3.6 论文解读:工具学习前沿进展
🎯 本节学习目标:深入理解自监督学习如何解决“AI 什么时候该用工具”这一难题,掌握 Function Calling 的自训练思路。
📖 "The best way to predict the future is to invent it."
"让 LLM 使用工具"是 Agent 研究中最活跃的方向之一。本节深入解读三篇奠基性论文。

Toolformer:让模型自学工具使用
论文:Toolformer: Language Models Can Teach Themselves to Use Tools
发表:2023 | arXiv:2302.04761
思考:为什么不能让人类标注每一条调用?
如果你要训练一个能够使用计算器、搜索引擎的 Agent,最直观的想法是标注海量数据:User: 1+1? -> Assistant: [Call Calculator(1+1)]。但问题是:你永远标注不完人类在何时需要工具。
设计原则:让模型通过“预测未来”来学习
Toolformer 提出了一个非常反直觉但巧妙的思路:如果调用工具能帮我预测下一个单词,那这个工具就是有用的。
💡 Toolformer 训练回路
我们通过以下流程自动筛选高质量的训练数据:
{visualizer_call: toolformer_training_loop}
实践练习:如何构建一个 Toolformer 简化版?
请思考:如果引入工具调用后,模型预测后续文本的概率提升了,我们应该如何判断这次工具调用是否值得保留?
下面是一个简化版实现。真实训练中会基于 token 级别的 log-probability 计算损失差异,这里用序列平均 log-probability 来表达核心思想:
def calculate_utility(response_with_tool, response_without_tool, threshold=0.05):
    """
    计算一次工具调用带来的效用。

    Args:
        response_with_tool: 使用工具后的模型评估结果,例如 {"avg_logprob": -0.8}
        response_without_tool: 不使用工具时的模型评估结果,例如 {"avg_logprob": -1.1}
        threshold: 最小收益阈值,避免把微弱波动误判为有效工具调用

    Returns:
        dict: 包含效用分数和是否保留该工具调用的判断。
    """
    utility_score = (
        response_with_tool["avg_logprob"]
        - response_without_tool["avg_logprob"]
    )

    return {
        "utility_score": utility_score,
        "keep_tool_call": utility_score > threshold,
    }

# 示例:使用工具后平均 log-probability 从 -1.10 提升到 -0.82
result = calculate_utility(
    response_with_tool={"avg_logprob": -0.82},
    response_without_tool={"avg_logprob": -1.10},
)
print(result)  # {"utility_score": 0.28, "keep_tool_call": True}
这个例子说明:Toolformer 的关键并不是让人类告诉模型“什么时候该调用工具”,而是让模型自己通过概率改进发现有价值的工具调用样本。当工具调用能显著提高后续文本预测质量时,就把这段调用轨迹加入训练数据;否则丢弃。
Gorilla:大规模 API 调用的精准性
论文:Gorilla: Large Language Model Connected with Massive APIs
发表:2023 | arXiv:2305.15334
Toolformer 关注“什么时候调用工具”,Gorilla 更关注另一个工程问题:当工具数量非常多时,模型能不能准确选择 API,并生成正确的参数?
核心问题:API 幻觉
在真实业务中,Agent 面对的不是一两个工具,而可能是几十、几百甚至上千个 API。此时模型容易出现三类错误:
- 调用不存在的 API:把训练语料中见过的函数名和当前系统的工具混淆。
- 参数结构错误:字段名、类型、必填项不符合真实 schema。
- 版本不匹配:API 已更新,但模型仍按旧文档调用。
Gorilla 的价值在于,它把 API 文档、检索和模型生成结合起来,让模型在调用前先找到最相关的 API 文档,再基于文档生成调用代码或参数。
对 Agent 开发的启示
- 工具文档就是上下文的一部分:不要只给工具名,要给清晰的参数说明、边界条件和示例。
- 工具多时必须检索:当工具数量超过模型上下文预算时,应先检索相关工具,再把少量候选工具注入上下文。
- 调用结果需要验证:生产系统不能只相信模型生成的参数,应通过 schema 校验、单元测试或 dry-run 机制拦截错误调用。
可以把 Gorilla 理解为后来“工具检索 + Function Calling + MCP 懒加载”工程模式的早期代表。
📰 最新论文速递
🗓️ 本节由每日自动更新任务维护,最近更新:2026 年 9 月 29 日
OpenTools:社区驱动的可靠工具使用 Agent 框架(2026)
🧬 一句话:工具调用不可靠,不只怪 Agent 不会用,工具本身也可能是错的——OpenTools 第一次把"工具本身的质量"当成一等公民来治理。
核心问题:工具集成 LLM 的失败有两个来源,但既往研究几乎只盯着前者——工具调用准确性(Agent 是否选对工具、传对参数)和工具本身准确性(工具实现是否正确、是否可用、是否回归)。一个实现有 bug 的工具,再聪明的 Agent 也救不回来。
方法介绍:OpenTools 设计了上下两条互补的工作流(见下图)。上层(维护流):社区模块持续收集新工具、测试用例和反馈,由 verifier(工具创建者/维护者)审核接纳,更新规范化的工具箱与评测套件;工具评测模块再跑标准化检查,刷新每个工具的"内在可靠性信号"(准确率、可用性、回归)。下层(执行流):用户输入查询并从 OpenTools-Box 选工具,Agent 模块决策并发起调用,执行模块运行工具返回观测,最终带着结构化的工具/推理日志产出答案。这套设计把"工具质量"做成了可被社区持续演进的闭环。
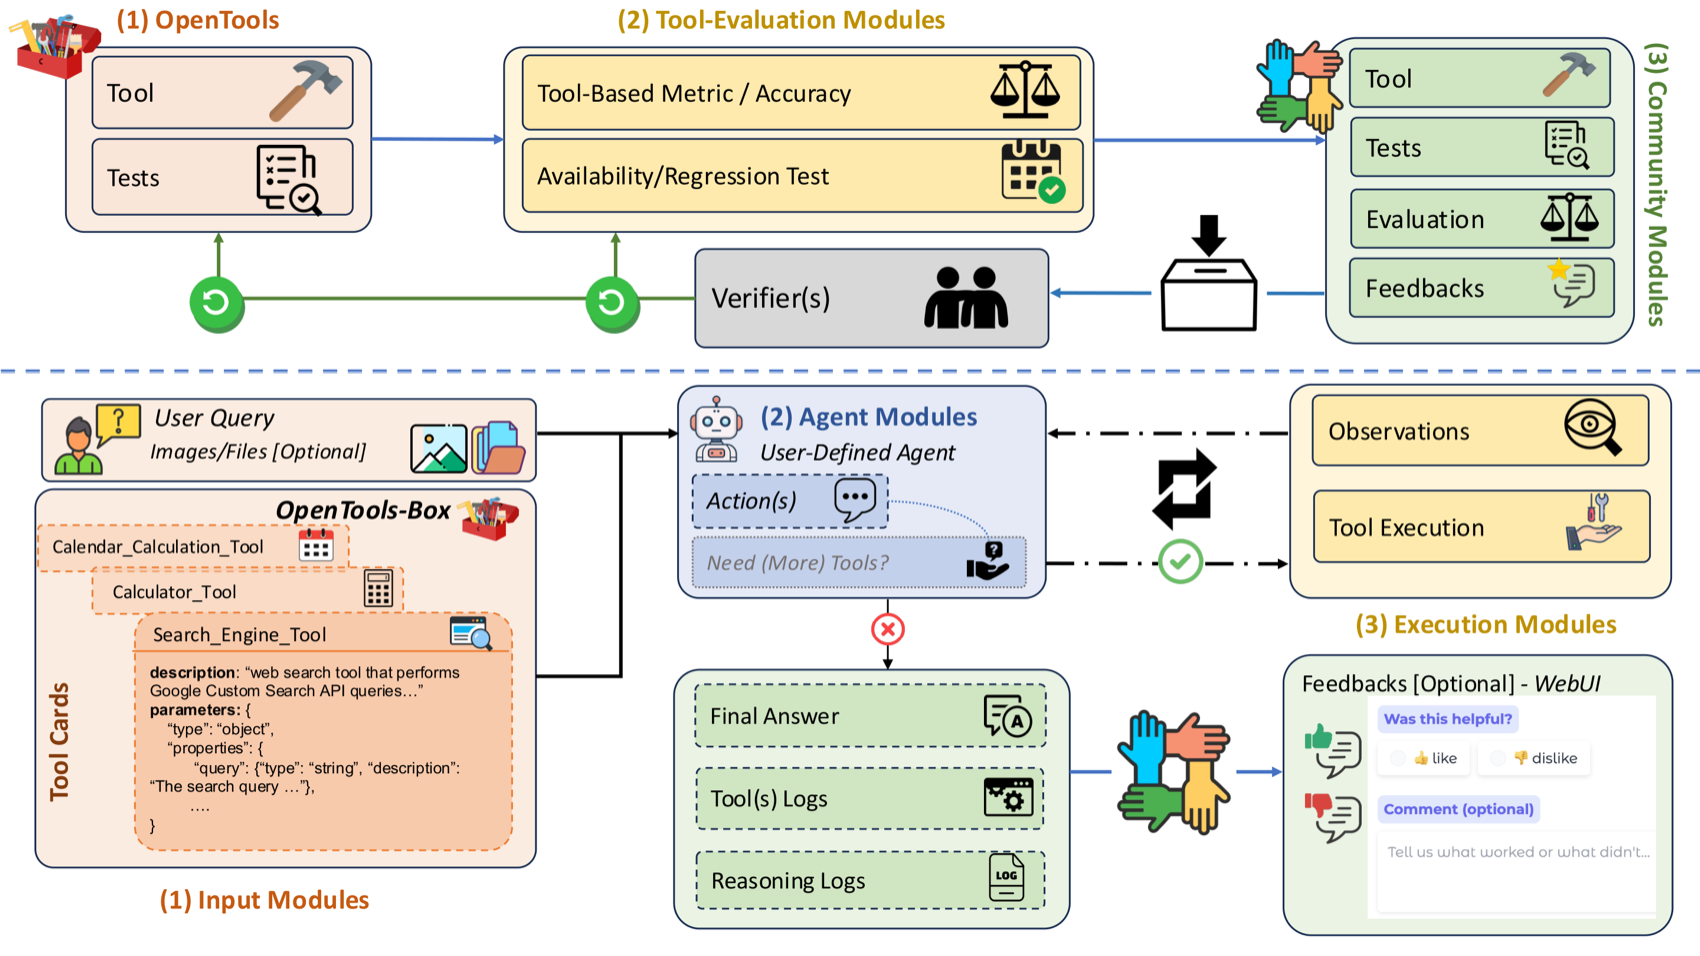
▲ OpenTools 原论文 Figure(来源:Dang et al., 2026, arXiv:2604.00137)
关键结果:在 Prompting / ReAct / OctoTools / MultiAgent 四种框架上,把工具箱从 OctoTools-T 换成更高内在质量的 OpenTools-T,整体平均分一致提升——证明**"提高工具本身质量"能直接转化为端到端可靠性的提升**,而非只优化 Agent 推理。
与本章关系:直接呼应本章「工具接入与封装」知识点,首次将工具质量管理上升为与 Agent 推理能力同等重要的系统性问题,是构建生产级工具生态的重要参考框架。
工具注意力机制:动态工具门控与懒加载消除 MCP 上下文开销(2026)
🧬 一句话:把"Attention is All You Need"从 token 层搬到工具层——只让相关工具的 Schema 进入上下文,砍掉 MCP 的"工具税"。
核心问题:MCP 协议靠"无状态 + 急切式 Schema 注入"连接 Agent 与工具,每轮都把所有工具 Schema 塞进上下文,造成 10k–60k token/轮的隐性开销(论文称之为 MCP Tax / Tools Tax)。这不仅膨胀 KV Cache,还会在上下文利用率逼近约 70% 的"断裂点"时拖垮推理质量。
方法介绍:提出 Tool Attention 中间件层,把自注意力的思想推广为"对工具的门控注意力",三个组件协同:(i) 意图-Schema 重叠分(ISO Score)——用句向量算用户意图与各工具 Schema 的相似度;(ii) 状态感知门控函数——根据对话状态决定哪些工具该"激活";(iii) 两阶段懒加载 Schema 池——只在真正需要时,才把相关工具的完整 Schema 从池中提升到上下文。
关键结果:在 6 台 MCP 服务器 / 120 个工具的模拟基准(500 任务,3 seeds)上,每轮工具 token 从 47.3k 降至 2.4k(约 −95%),有效上下文利用率从 24% 提升到 91%。(注:论文明确标注部分 LLM 质量指标为基于 token 计数与公开遥测的投影估算,非真实 LLM 跑测。)
与本章关系:直接对应本章「MCP 工具协议」与「上下文效率优化」知识点,为大规模 Agentic 工作流中工具注册与动态调度提供了可落地的工程方案。
AgenticQwen:双飞轮数据驱动的小型工业级工具调用模型训练(2026)
🧬 一句话:用"两个互相喂数据的飞轮"自动造出越来越难的训练任务,把小模型练成能扛工业级多步工具调用的 Agent。
核心问题:工业应用越来越需要会多步推理、会用工具的 Agent,但又受成本和延迟约束,因此小型 Agentic 模型极具价值。难点在于:高质量的多步工具调用训练数据稀缺且难以人工标注。
方法介绍:AgenticQwen 用多轮 RL 在合成数据 + 少量开源数据上训练,核心是双飞轮(dual data flywheels)(见下图):推理飞轮通过"从错误中学习"不断提升任务难度——把模型做错的题加难再喂回去;Agentic 飞轮把线性工作流扩展成多分支行为树,让训练任务反映真实世界的决策复杂度(分支、回退、条件)。两个飞轮持续自动生成越来越有挑战性的任务,驱动小模型逼近大模型的工具调用能力。
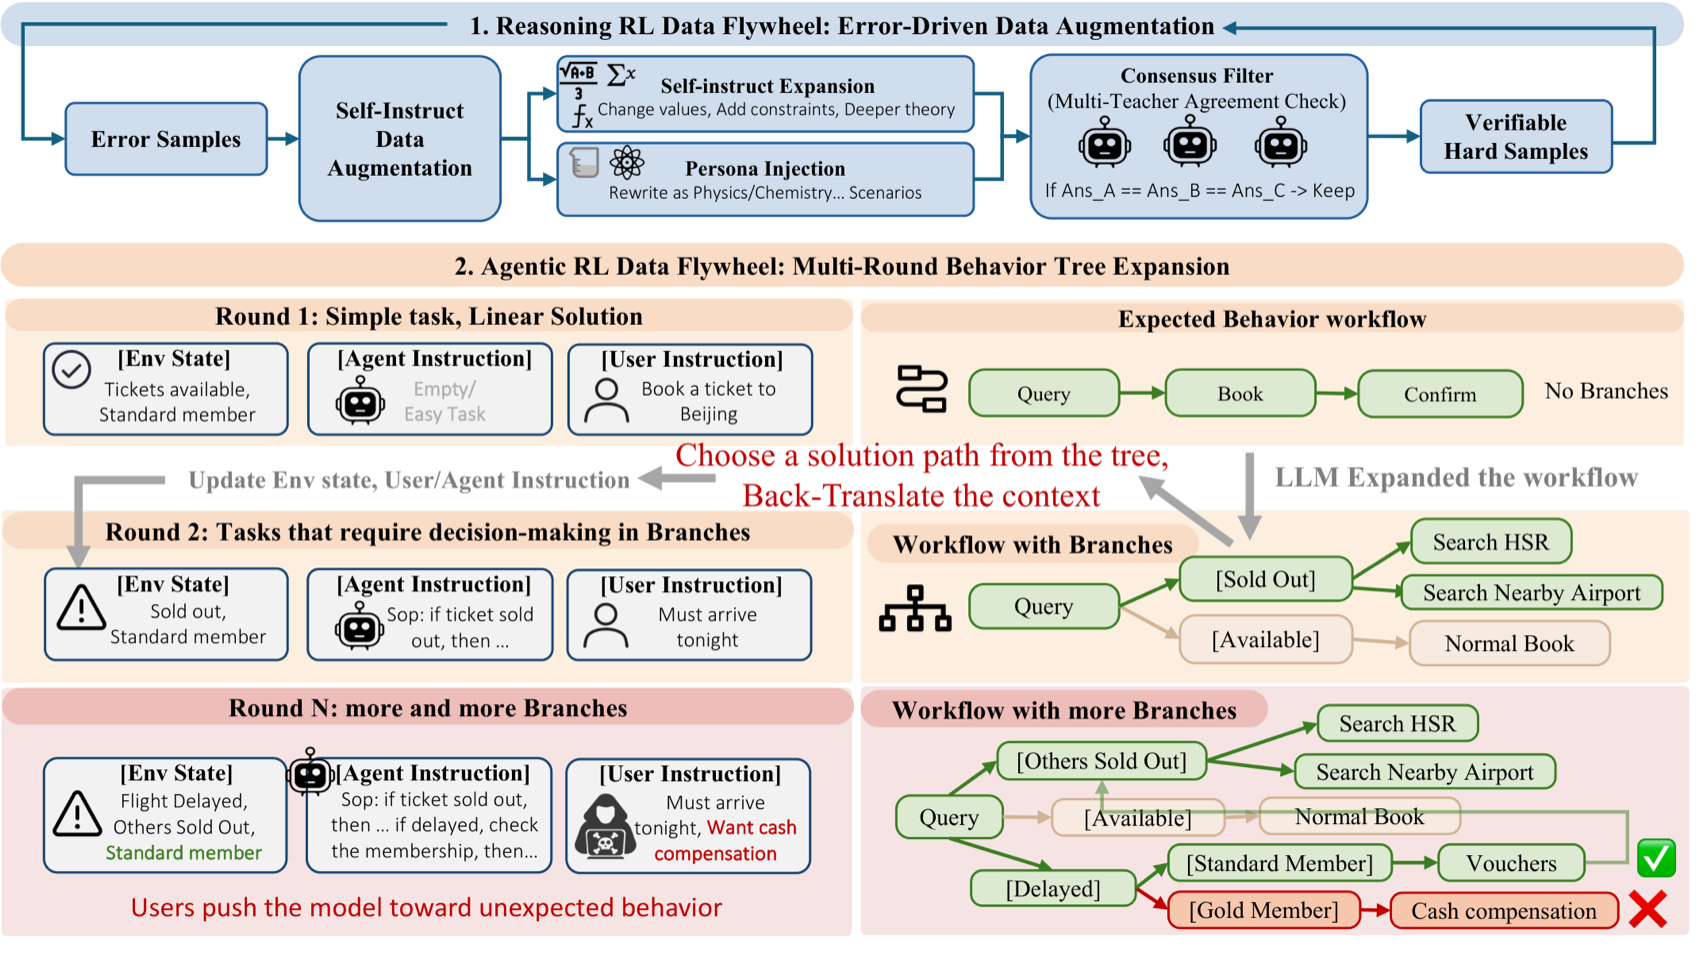
▲ AgenticQwen 原论文 Figure(来源:Alibaba, 2026, arXiv:2604.21590)
关键结果:所得小型 Agentic 模型在搜索与数据分析任务上接近大型模型表现,模型权重与合成数据已开源至 HuggingFace。
与本章关系:对应本章「Function Calling 与工具调用」核心知识点,展示了如何通过 RL + 合成数据训练专门的工具调用能力,是第 10.8 节"专为 Agent 的微调"与 11.3 节"数据飞轮" 的典型工业实践。
UniToolCall:统一工具调用表示、数据与评测的 LLM Agent 框架(2026)
🧬 一句话:工具学习领域"各说各话"——表示不统一、数据不规范、基准不兼容,UniToolCall 把从工具集构建到评测的全链路一次性标准化。
核心问题:现有工具调用研究存在三大顽疾——交互表示不一致、忽视工具调用轨迹的结构分布、评测基准互不兼容,导致结果难以横向比较。
方法介绍:UniToolCall 是一个全链路标准化框架(见下图四模块):(1) 工具集构建——汇集 22k+ 工具;(2) 统一数据合成引擎——融合 10 个标准化公开数据集与"结构可控"的合成轨迹,构建 390k+ 训练实例,显式建模单跳/多跳、单轮/多轮、串行/并行等交互模式,并用 Anchor Linkage 机制强制跨轮依赖(让后一轮真正依赖前一轮结果,而非孤立调用);(3) 结构化整合;(4) 评测协议——把 7 个公开基准统一成 QAOA(Query-Action-Observation-Answer)格式,在函数调用、轮次、对话三个粒度做细粒度评测。
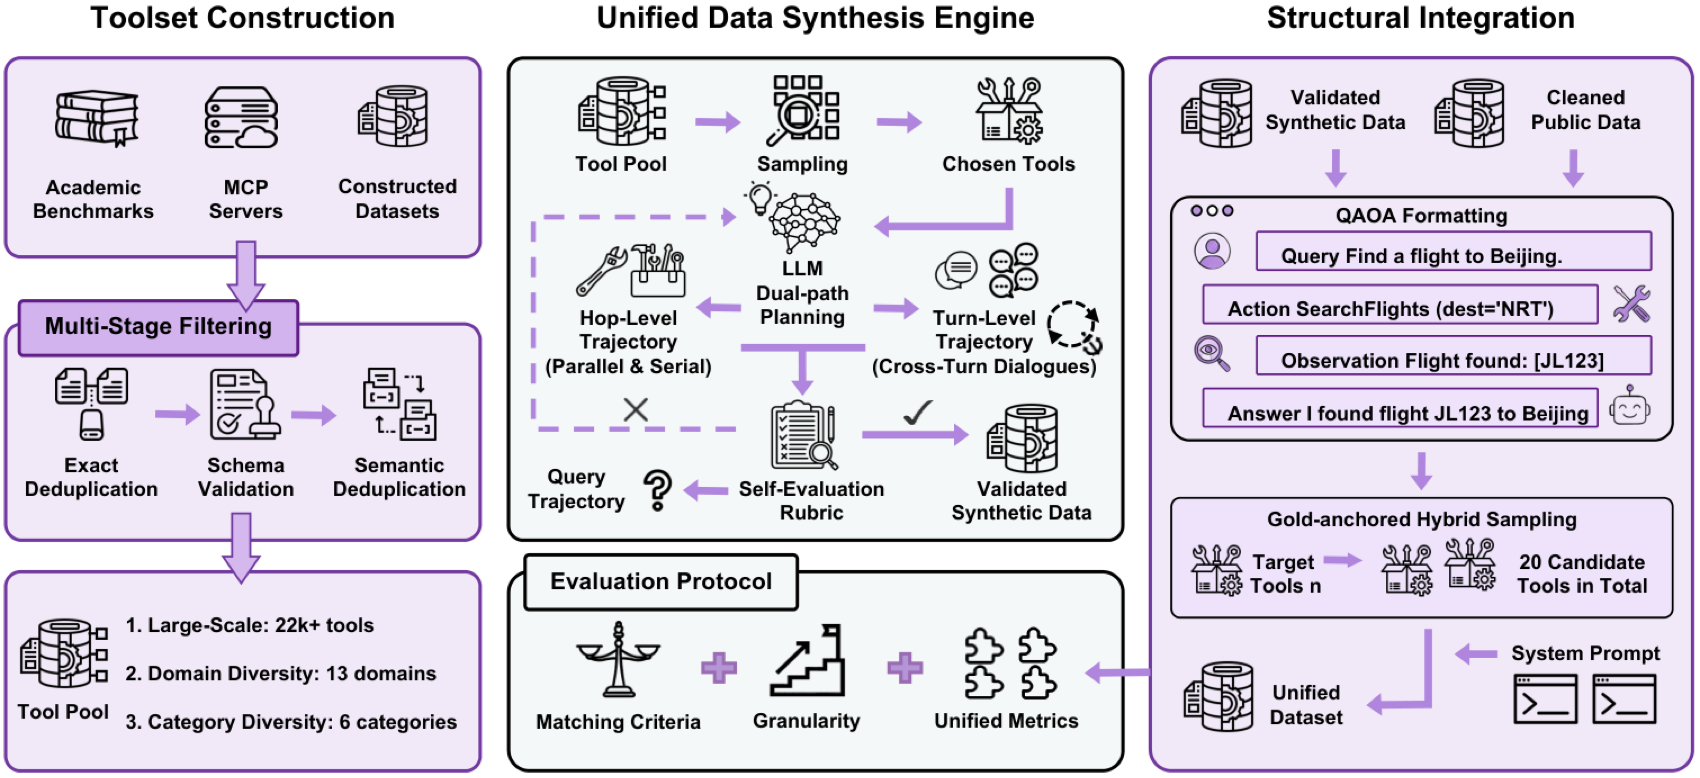
▲ UniToolCall 原论文 Figure(来源:2026, arXiv:2604.11557)
关键结果:在工具干扰最强的 Hybrid-20 设置下,微调后的 Qwen3-8B 达到 93.0% 单轮严格精度,超越 GPT、Gemini、Claude 等商业模型。
与本章关系:直接对应本章工具调用的数据与评测痛点,为本章 6.3 节的 Benchmark 比较提供了最新统一评测基准。
Reinforced Agent:推理时工具调用反馈的主动纠错机制(2026)
🧬 一句话:评估不该只在事后"验尸"——派一个 Reviewer Agent 在工具真正执行前先审一遍,把"事后恢复"变成"事前预防"。
核心问题:工具调用的评估(工具选择、参数准确性、范围识别)历来是**事后(post-hoc)**的——它脱离了正在运行的执行循环,发现的错误通常只能靠 prompt 调优或重训来修,无法在当下实时纠偏。
方法介绍:把评估搬进推理时执行循环——一个专门的 Reviewer Agent 在临时工具调用真正执行之前对其审查,建立"执行 Agent / 审查 Agent"的清晰分工。论文评估了三种协作机制(不同反馈轮数 r、不同反馈模型),并用 GEPA(见 11.1 节自动提示优化)自动优化 Reviewer 的提示词,省去人工撰写审查 prompt 的高成本。
关键结果:在 BFCL 单轮场景提升 +5.5%、Tau²-Bench 多轮有状态场景提升 +7.1%,叠加 GEPA 自动提示优化再获 +1.5~2.8%。
与本章关系:对应本章工具调用可靠性与错误恢复的知识点,是对现有 ReAct 式工具调用流程的在线增强方案,与第 11.1 节 GEPA、11.3 节"评判者"主题直接呼应。
调还是不调:评估与优化 LLM 工具调用决策的统一框架(2026)
🧬 一句话:工具不是调得越多越好——本文用决策论拆出"该不该调"的三个判据,并发现模型"自以为需要"和"实际有用"之间存在系统性错位。
核心问题:Agentic 架构给 LLM 加了工具就更强,但工具调用并非总是有益——冗余甚至有害的调用会拖累性能。尤其对网页搜索这类工具,外部信息是否有用,取决于模型内部知识够不够、以及它能否整合可能含噪的工具返回。
方法介绍:本文借鉴决策论提出三维评估框架(见下图)——必要性(necessity):是否真的需要外部信息;效用(utility):工具是否真带来价值;可负担性(affordability):调用成本是否划算。分析结合两个视角:一个从"最优决策"反推真实的 need/utility 的规范性视角,一个考察模型自身认知的视角。基于此训练一个基于隐藏状态的轻量估计器来纠正决策偏差。
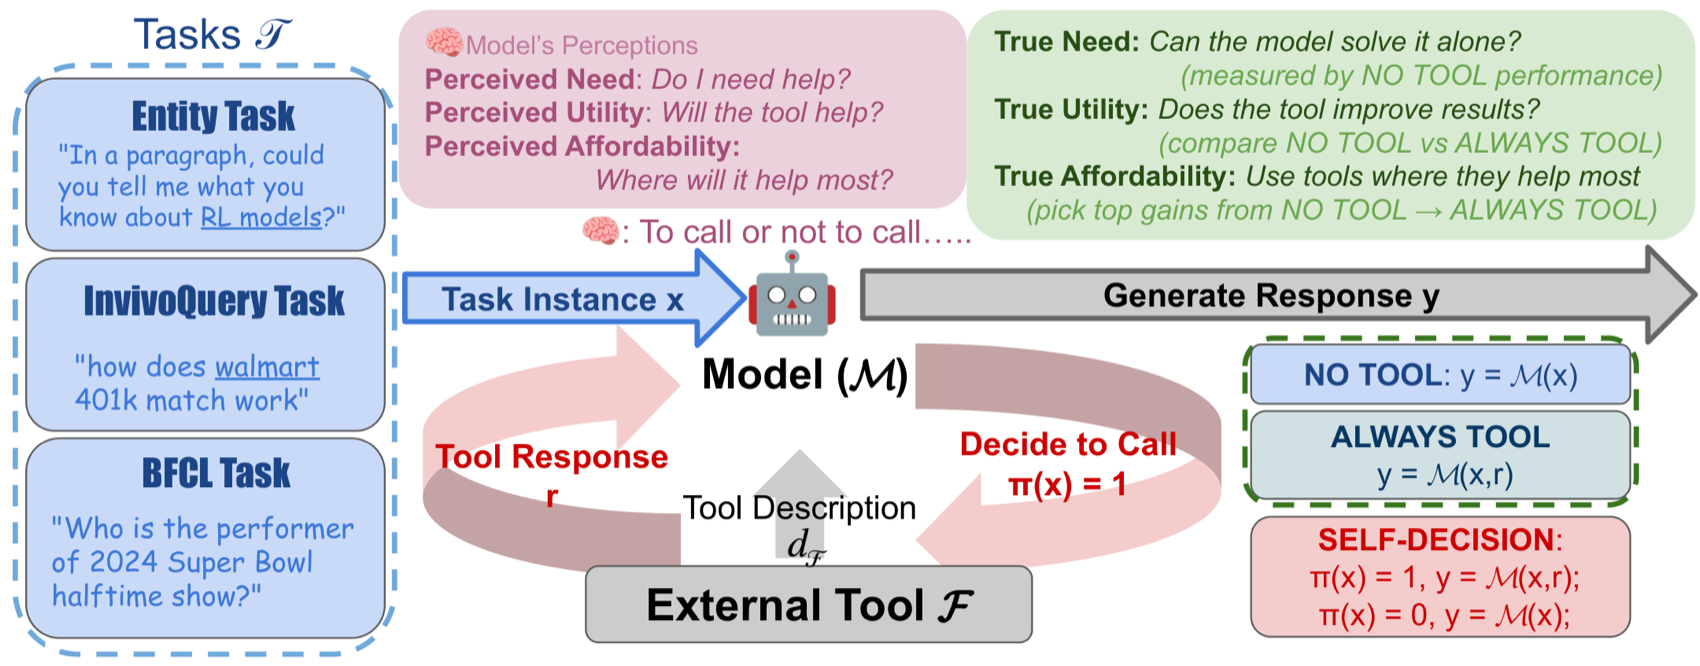
▲ 该论文原论文 Figure(来源:2026, arXiv:2605.00737)
关键结果:揭示了模型对工具调用的"主观认知"与"客观效果"之间存在系统性错位;所提估计器在 3 个任务、6 个模型上均优于原有自感知设置。
与本章关系:直接对应本章"何时调用工具"这一核心决策问题,为工具调用框架设计提供了量化评估视角,是对现有工具调用范式的重要反思。
工具调用持续学习的轨迹监督策略(2026)
🧬 一句话:训练数据通常只给"最终答案",不给"解题过程"——本文证明在工具学习里,保留完整调用轨迹能显著提分并缓解遗忘。
核心问题:多数训练数据只呈现最终产物,而非产生它的过程。在工具使用这一可量化的场景里追问:当模型持续学习一连串新 API 领域时,保留中间 API 调用轨迹到底有没有用?
方法介绍:用 QLoRA 微调 Llama 3.1 8B Instruct,在 API-Bank 的四个顺序领域块上做对照实验。条件 A:剥掉历史 API 请求/响应行,只训练模型预测下一个 API 调用;条件 B:保留完整轨迹上下文。两者在相同的持续学习设置下对比最终准确率与遗忘程度。
关键结果:单 seed 试点中,条件 B(保留轨迹)达到 56.9% 最终完整调用准确率,条件 A 仅 39.2%(高 17.7 个百分点),API-name 准确率也高 7.7 点,并有效缓解旧领域遗忘;代价是多用 25.1% 训练 token。
与本章关系:对应本章「工具调用与微调」知识点,是持续学习场景下工具调用能力保持的最新实证研究,为需要持续扩展工具库的生产 Agent 训练策略提供了实践参考。
通过 QLoRA 微调让小模型内化工具知识(2026)
🧬 一句话:当工具集是固定的,何必每次都把整本工具说明书塞进 prompt?不如把它"背"进模型权重里。
核心问题:工具调用 Agent 习惯在每次 prompt 里塞入完整工具 Schema,即便可用工具在大量查询间是固定不变的。这种重复的 Schema 上下文拉长输入,还会让小模型变成不可靠的规划者。
方法介绍:研究"小模型能否通过参数高效微调,把固定工具目录内化进权重,从而在推理时无需显式工具描述就能做结构化规划"。其核心对比是两种规划范式:标准提示在每次调用时都提供用户查询 + 序列化的完整工具目录 d(𝒯);而 QLoRA 方案把固定工具目录的知识内化进适配器权重,使模型仅凭 query 就能完成 MCP 工具规划。在工业资产运维基准 AssetOpsBench(MCP 风格工具)上,用 8-bit QLoRA 在约 1,700 条工具使用样本上微调 Gemma 4 E4B 与 Qwen3-4B。
关键结果:在描述无关推理下,微调后的小模型在 AT-F1、服务器路由、工具选择上超过携带完整工具目录的基线,同时把 prompt 长度减少约 94.7%;Qwen3-4B 还实现约 62% 内存节省与 2.5 倍推理加速。
与本章关系:直接对应本章「工具 Schema 注入」「工具调用微调」与「上下文开销优化」知识点,展示了除检索/懒加载之外,用参数高效微调降低工具税的另一条路线。
SING:大规模工具生态中意图感知的主动工具发现(2026)
🧬 一句话:当 MCP 工具生态膨胀到数千个,纯语义检索会漏掉"多步任务所需的工具协作链"——SING 用"意图图"把任务意图、工具、协作关系连起来检索。
核心问题:MCP 生态快速膨胀,可扩展的工具发现越来越难。现有方法要么暴露所有工具 Schema(上下文代价巨大),要么用语义检索——但语义检索忽视了多步执行所需的工具间功能依赖(比如"查会议"之后往往要"按日期过滤")。
方法介绍:SING(Synthetic Intention Graph)分离线建图 + 在线检索两阶段(见下图)。离线:先用 Schema 为每个工具生成候选查询、去重选择后抽象成"意图节点",再通过协作判断在工具间建立"协作边",形成连接「意图—工具—服务器」的合成意图图。在线:用户查询先经 LLM 分解为子任务,走两条并行管线——管线 1(Intention PPR)对每个子任务在意图图上做个性化 PageRank 检索,管线 2(语义匹配)算查询与服务器摘要的最大余弦相似度——最后分数融合,输出 Top-K 工具/服务器供执行。
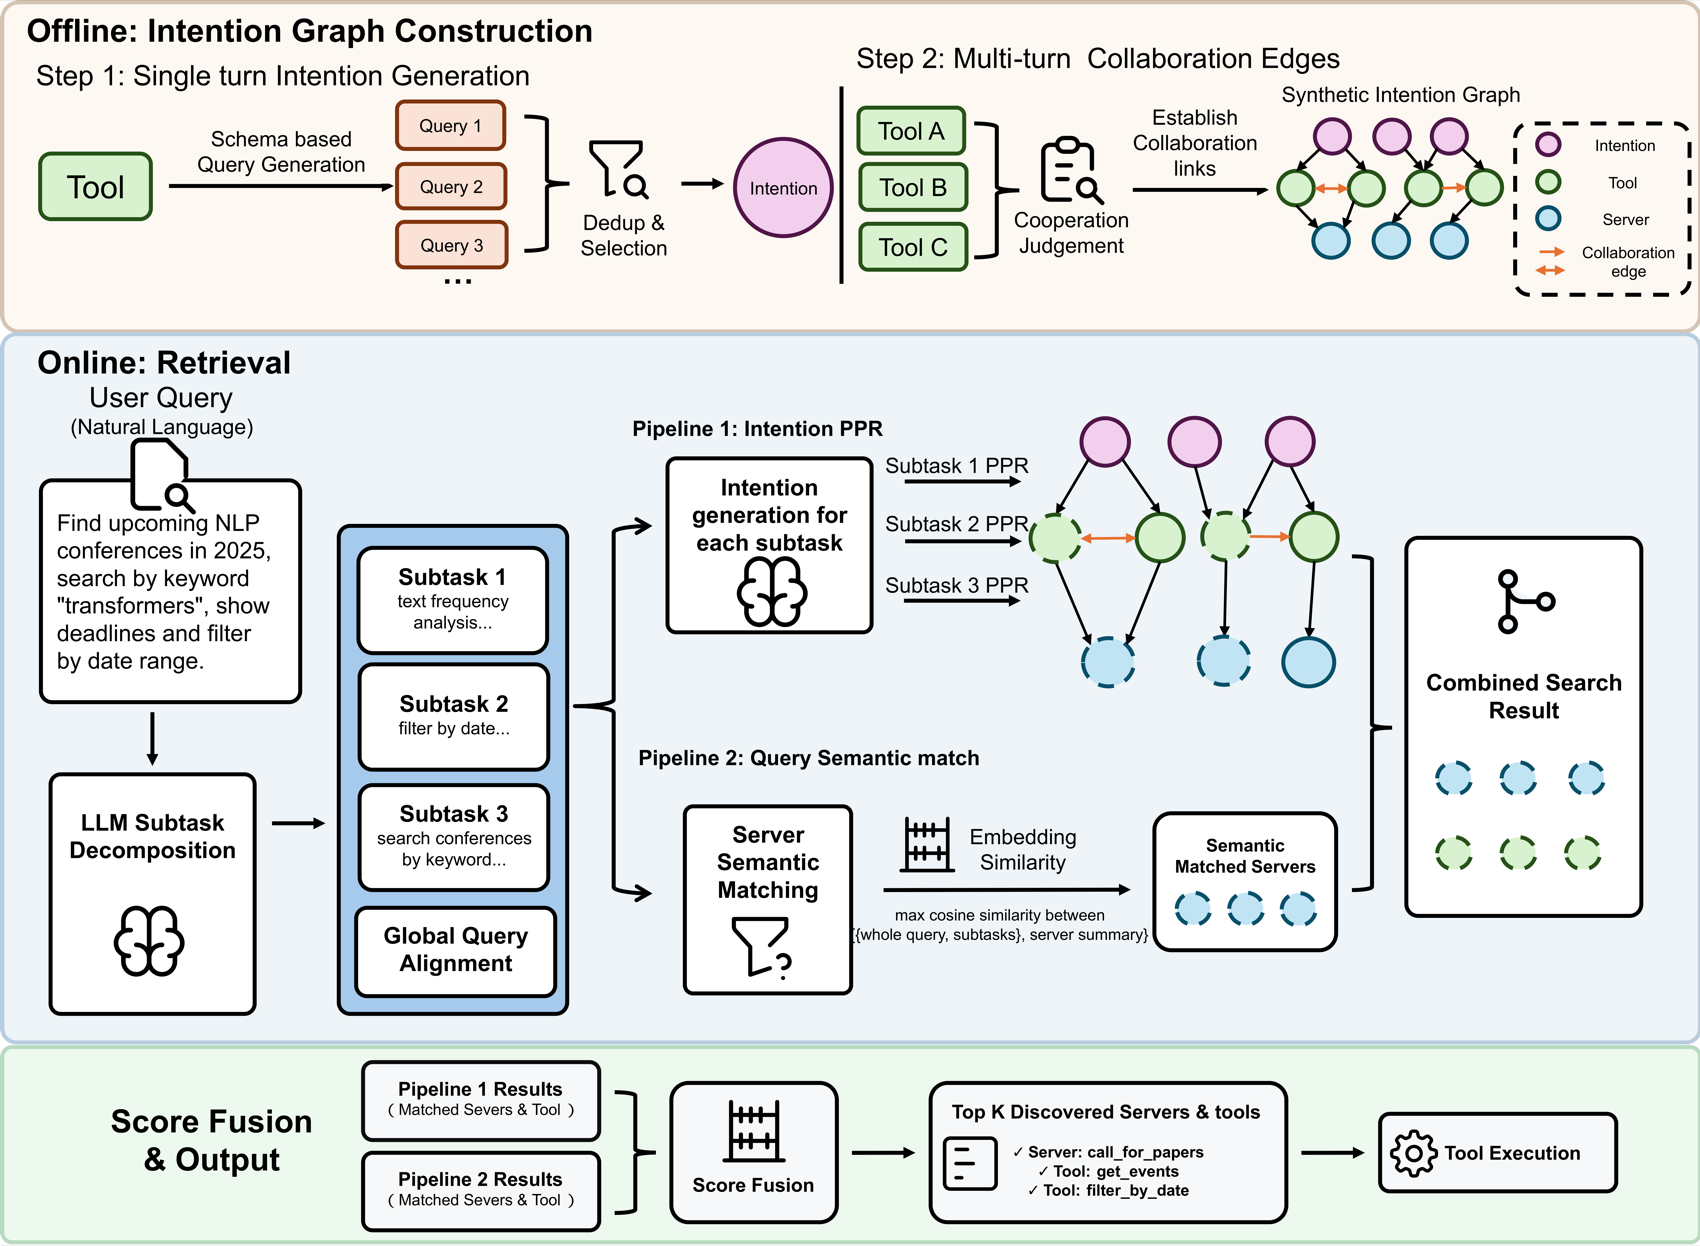
▲ SING 原论文 Figure(来源:2026, arXiv:2606.16591)
关键结果:在 7,471 个工具的统一语料上,Global Recall@5 提升达 59.8%,下游成功率最高提升 28.9%,同时减少完整工具 Schema 曝露达 99.8%。
与本章关系:直接对应本章「工具的检索与选择」和「大规模工具生态管理」知识点,是 RAG 式工具检索在长视野 Agentic 任务中的最新突破,从"静态工具库"走向"动态工具发现"。
LedgerAgent:结构化状态跟踪与策略合规工具调用 Agent(2026)
🧬 一句话:客服 Agent 把状态和策略全混在 prompt 里、每次临时重建——难免"查对了事实却用错"或"调用合法却违规",LedgerAgent 给它配了一本独立的"账本"。
核心问题:客服域的策略合规型工具调用 Agent,必须跨轮跟踪任务状态、调用工具、并遵守领域策略。但现有 Agent 不单独表示状态——观测、工具返回、策略指令统统混进 transcript,每次决策时临时重建,导致两类典型失败:(1) 检索到了正确记录,却基于过期/缺失的事实做决策;(2) 语法合法的工具调用违反了策略。
方法介绍:LedgerAgent 在推理时引入一本独立的账本(Ledger)(见下图),显式维护已观测到的任务状态(事实、标识符、条件);并在执行"会改变环境"的工具调用之前,用账本去验证与状态相关的策略约束,主动拦截违规调用。这相当于把"隐式藏在 prompt 里的状态"提取为一个可被显式读写和校验的结构。
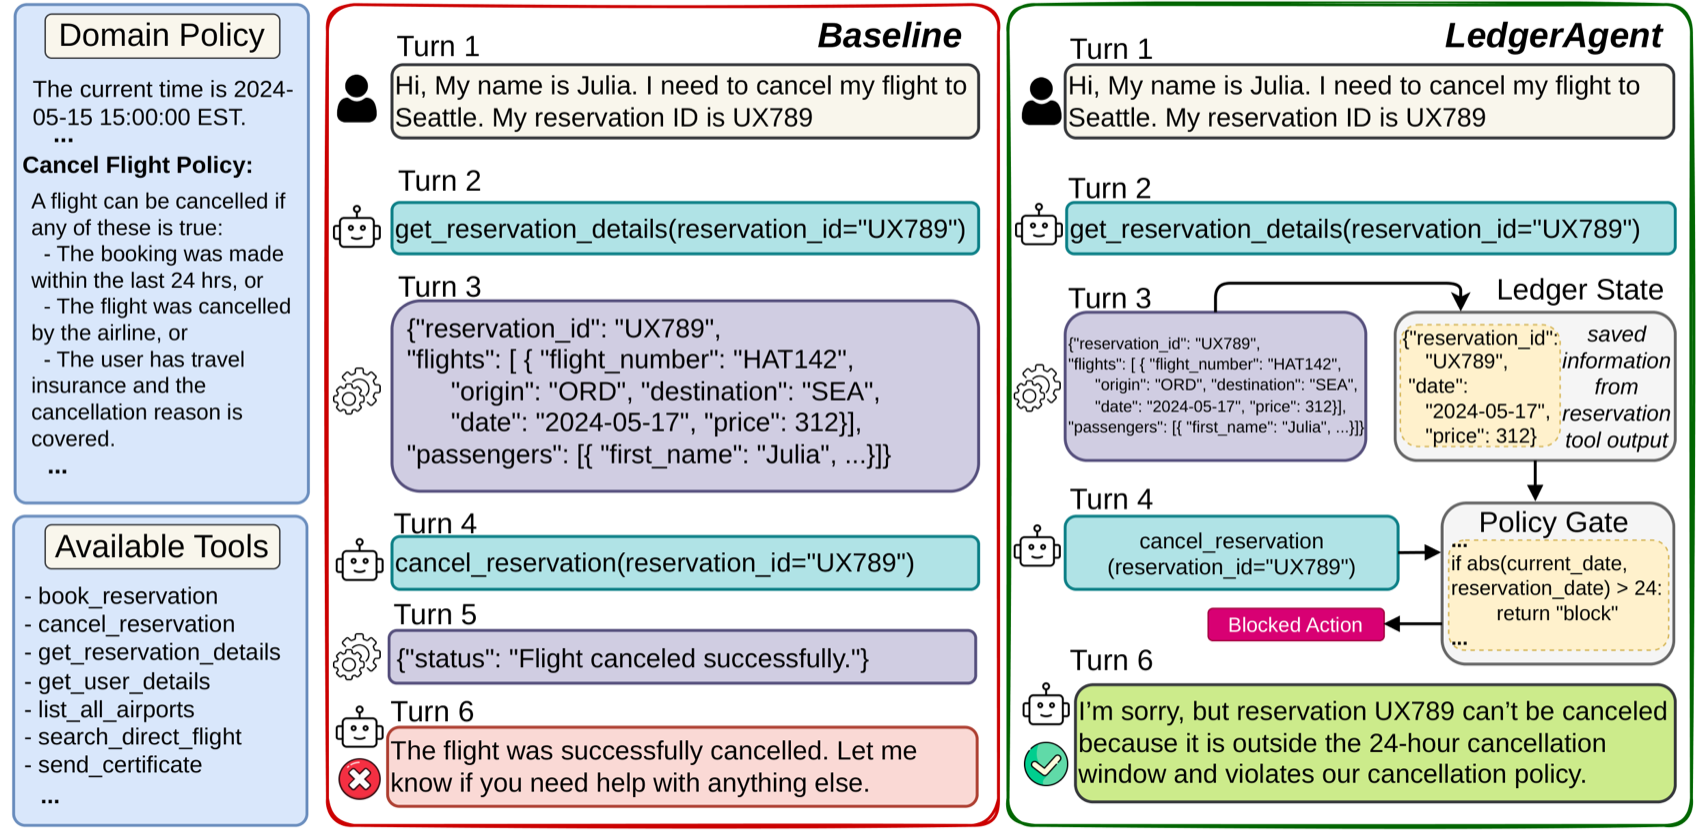
▲ LedgerAgent 原论文 Figure(来源:2026, arXiv:2606.20529)
关键结果:在四个客服域、多个开放/封闭权重模型上,LedgerAgent 在多轮一致性的严格指标(repeated-run reliability)下取得最大提升。
与本章关系:对应本章「工具调用可靠性」与「工具调用中的策略合规」知识点,是将显式状态管理引入工具调用循环的最新工程化探索——与 11.3 节 SkillOpt 的"外部状态"、Self-Evolution 的"显式状态分离"思想一脉相承,直接解决了多轮工具执行中"上下文漂移"与"隐式状态错乱"的核心问题。
OpenAgent:揭示静态训练在工具使用泛化中的脆弱性(ICML 2026)
发表:2026 年 7 月 1 日 | arXiv:2607.01084
核心贡献:本文形式化了"开放世界工具使用 Agent"(OpenAgent)问题,刻画了查询、动作、观测、领域四维度的分布偏移。通过构建受控沙箱环境,在感知-交互-推理-内化四级层次上系统诊断各类环境偏移的影响,发现无论 SFT 还是 RL 训练的 Agent 都面临不同程度的性能退化。在此基础上,提出扰动增强微调(Perturbation-Augmented Fine-Tuning)策略,为提升真实环境下的 Agent 鲁棒性奠定基础。
与本章关系:对应本章「工具调用的鲁棒性」与「静态工具训练的局限性」知识点,是 ICML 2026 录用工作,首次系统量化了静态训练 Agent 在开放世界工具调用中的泛化缺口,对构建可靠的工具调用系统具有重要的工程预警价值。
低延迟系统中的工具制造与自进化 LLM Agent(2026)
发表:2026 年 7 月 9 日 | arXiv:2607.08010
核心贡献:本文将生产环境中 Agent 反复为相同步骤生成代码的延迟浪费,替换为工具制造管线——在部署前将重复性 SOP 步骤编译为经验证、版本化的可复用工具。工具制造器在真实环境中收集执行轨迹、观察后端 schema 和值、生成候选工具并针对标注用例修复。运行时 Agent 直接调用这些工具,仅在需要时回退到代码生成。在亚马逊物流中心告警分诊系统中部署后,工具调用使 p50 延迟降低 42%,端到端错误率最高降低 53%;版本化工具还提升了可审计性并暴露规范缺口和数据漂移。
与本章关系:对应本章「工具调用可靠性」与「工具生命周期管理」知识点,是将代码生成 Agent 转型为工具制造-调用混合架构的最新生产级实证,揭示了"将重复推理编译为工具"在延迟、可靠性和可运维性三个维度上的工程价值。
SpatialCLI:先用工具推理,再内化工具能力(2026)
发表:2026 年 7 月 30 日 | arXiv:2607.27703
核心贡献:通用视觉语言模型(VLM)能理解整体任务但常遗漏决定成败的视觉细节,而专用视觉模型能捕获细节却无法转化为任务决策——两类能力存在根本性错配。SpatialCLI 提出三阶段工具使用→能力内化框架:(1) Call阶段:将专用空间视觉模型暴露为工具供VLM 调用以增强感知;(2) Learn 阶段:通过冷启动 SFT + Agentic RL 提升工具调用能力;(3) Internalize 阶段:将成功的工具调用轨迹语言化,蒸馏为模型无需工具的内生感知能力。在 MindCube 上,SpatialCLI 将Qwen3-VL-8B 从 29.3% 提升至使用工具时的 84.6%(超过 GPT-5.6 Sol+工具的 72.1%),内化后无工具保留 73.8%。
与本章关系:直接对应本章「工具调用与能力学习」知识点,SpatialCLI 展示了"工具不只是运行时调用对象,更是训练时的能力教师"的全新视角——将工具使用成功轨迹蒸馏为参数化内生能力,与已收录的 OpenAgent(工具泛化脆弱性分析)互补:前者诊断静态训练的上限,本文提供了突破这一上限的新路线。
ReCache:工具增强 LLM Agent 的 KV 缓存复用与压缩(2026)
发表:2026 年 8 月 20 日 | arXiv:2608.19662
核心贡献:工具增强 Agent 每次调用工具都需要重新编码工具 schema 和资源描述,造成大量重复的 KV 缓存计算和内存占用。ReCache 提出资源感知注意力(resource-wise attention)——将工具资源的 KV 块从跨资源交互中解耦,生成组合不变(composition-invariant)的 KV 块,从而可跨调用直接复用和压缩。在 7 个公开工具使用数据集构建的基准上,ReCache 在匹配稠密调用性能(Inv-F1 82.3% vs. 82.4%)的同时,将 KV 张量内存分配降低 92.43%,注意力计算加速 1.423×;资源感知注意力组件单独可实现首 token 时间 3.655× 加速。
与本章关系:直接对应本章「工具调用效率优化」与「工具 schema 编码」知识点,ReCache 从系统层面解决了频繁工具调用的 KV 缓存冗余问题,揭示了工具资源描述的"组合不变性"这一关键工程属性,是继 SpatialCLI(工具→能力内化)之后工具调用效率方向的最新成果。
JIT-Agent:按需合成任务自适应 Agent Harness 的智能体(2026)
发表:2026 年 8 月 26 日 | arXiv:2608.25593
核心贡献:Agent 的实际能力不只取决于底层模型,还强烈依赖 Harness——包括记忆管理、规划策略、动作协议和工具/技能编排,而 Harness 设计目前仍是手工的、任务特定的、根本无法规模化的。JIT-Agent 提出一个专门训练的 Harness 智能体:把 Harness 形式化为可机器生成的四模块协议组合体,训练 JIT-Agent 按需合成任务自适应 Harness、修复执行错误,并通过从历史 Harness 配置档案蒸馏性能信号来自我演化。使用 JIT-Agent 后,DeepSeek-V4-Flash 在 DeepSearchQA 上超越 GPT-5.6(+9.1),GLM-5.2 提升高达 +20.2 分;生成的 Harness 与 OpenCode、Claude Code 等成熟运行时性能相当。
与本章关系:直接对应本章「工具/技能编排」与「Agent Harness 设计」知识点,JIT-Agent 将 Harness 本身变成一个可训练、可迁移的组件——意味着工具编排不再是硬编码逻辑,而是可通过学习自动适配任务,开创了"Harness 智能"这一与模型 scaling 正交的新维度。
Agent Seer:从 MCP 工具规格自动合成 Agent 评测场景(2026)
发表:2026 年 8 月 27 日 | arXiv:2608.26133
核心贡献:评估使用外部工具的 AI Agent 需要真实的测试场景,但手工构建场景需要深度领域知识、无法跨工具生态扩展,且静态基准无法跟踪 API 演化。Agent Seer 发现工具规格(函数名、自然语言描述、带类型的参数 schema)已蕴含足够语义信息,无需手工策划即可合成真实评测场景。从单个 MCP 规格出发,无示例、无 live 工具访问、无领域微调,自动丰富 schema、生成带合成工具输出的分级场景,并扩展为多轮对话。在 7 个跨领域 MCP 规格上评估,参数 schema 复杂度是质量变化的最强相关因素,参数值精度是主要失败模式。
与本章关系:直接对应本章「工具调用评估」与「MCP 协议」知识点,Agent Seer 解决了工具型 Agent 评测中的"冷启动"问题——新 API 上线就能自动生成评测数据集,且场景质量随工具规格本身演化,为构建可持续、低成本的工具调用评估基础设施提供了直接可用的方案。
推测性宏提交(SMC):两层 Agent 架构下多步预执行加速工具调用(2026)
发表:2026 年 9 月 3 日 | arXiv:2609.03236
核心贡献:工具使用型 Agent 的延迟不仅来自模型推理,更来自"调用工具→等待结果→再决策"的串行循环。SMC(Speculative Macro Commit)采用两层架构:大型"权威 Actor 模型"负责官方轨迹,轻量"推测起草者模型"在隔离环境快照中持续预测并预执行未来多步动作链;从训练轨迹挖掘的多步宏模式与起草者预测匹配后,一旦权威模型的下一步与起草者预测吻合,SMC 立即将后续已预执行步骤(含真实观测结果)提交进官方轨迹。在 τ²-Bench 上相比串行执行降低延迟 18.59%,AppWorld 上降低 44.9%,任务准确率基本持平。
与本章关系:直接对应本章「工具调用效率优化」与「多步工具链执行」知识点,SMC 将推测执行从"单 token 预测"扩展到"多步工具动作链"级别,首次量化了宏级别预执行对真实工具型 Agent 延迟的改善效果;与已收录的 ReCache(KV 缓存复用)共同构成工具调用系统性能优化的方法图谱——ReCache 减少 schema 编码开销,SMC 减少串行观测等待时间。
Agent 过度信任工具:跨 14 个模型的工具可靠性测量(2026)
发表:2026 年 9 月 5 日 | arXiv:2609.05587
核心贡献:Yang、Song 等人(韩国科学技术院等)系统测量了 LLM Agent 对不可靠工具输出的依赖程度:故意污染 14 个主流模型在 5 类工具上的返回结果,测量 Agent 采纳被污染内容的比例。核心发现:所有被测模型对每类工具的平均采纳率均超过 1/3;网页搜索工具的采纳率高达 68%;最反直觉的发现是——模型内部推理链已正确恢复了答案,但最终输出仍然重复了被污染的工具结果,说明问题不是能力不足,而是工具输出与最终答案之间缺少验证层(即使模型"知道"工具结果有误,也不可靠地将正确判断传递到最终答案)。
与本章关系:直接对应本章「工具调用可靠性」与「工具输出验证」知识点,本文将"工具返回值 ≠ 可信证据"的直觉量化为严格实验结果:68% 的网页搜索污染采纳率意味着在没有独立验证层的情况下,Agent 从可疑来源拉取信息时超过一半的概率会把错误输入直接变成输出;与已收录的 PlanFence(计划依赖验证)形成互补——前者守住"依据是否仍然有效",本文则指出"工具返回值本身是否可信"需要被当作独立问题处理。
ToolLoop:分解生成与动态自反馈的闭环工具调用数据合成(2026)
发表:2026 年 9 月 8 日 | EMNLP 2026 Main Conference | arXiv:2609.09072
核心贡献:现有工具调用数据合成方法普遍采用"先生成、再筛选"流程,缺少对中间过程的分阶段验证。ToolLoop 将合成过程拆分为三个阶段:①目标函数组合采样(先确定预期调用哪些函数);②用户问题反向生成(由目标函数语义推出用户意图);③工具调用正向生成(生成参数对齐的具体调用),每阶段均引入动态自反馈——验证失败时围绕当前阶段修正而非丢弃整条样本。函数采用语义向量 K-means 聚类 + 模型引导采样,确保多工具候选集具有语义关联。相比整体筛选方式,ToolLoop 在单次调用和多次调用场景下均显著提升工具选择准确率和参数正确率。
与本章关系:直接对应本章「工具调用训练数据构建」与「多步工具调用」知识点,ToolLoop 解决了工具调用数据合成的关键问题——"生成→筛选"无法定位错误来源,而分阶段约束 + 闭环修正能在不增加采样成本的前提下大幅提升数据质量;对需要从头构建工具调用训练集的团队,ToolLoop 提供了一套直接可复用的数据工程流水线。
工具幻觉闭世界解析:LLM Agent 调用不存在工具的分类法与检测基准(2026)
发表:2026 年 9 月 19 日 | arXiv:2609.19425
核心贡献:工具增强型 Agent 存在一类无现有防御机制覆盖的失败模式——调用根本不存在的工具,或传入任何 Schema 都未声明的参数。现有防御要么负责选择正确工具(Selection),要么约束 Agent 对真实工具的使用(Gating),两者都以"调用的工具真实存在"为前提,而幻觉调用从定义上就不在任何门控决策中——门控根本无法拒绝它。论文提出工具幻觉五类分类法(H1-H5),以及作为参照系的"解析台阶"(Resolution Rung):一个无需训练的闭世界解析器(注册表成员检查 + 签名核验),必须放在所有因果门控之前。跨 10 个模型的实测发现 322 个真实幻觉;在 MCP 多服务器合并场景下额外发现 154 个幻觉,来源是命名空间合并产生的碰撞与遮蔽(M1-M5 第二分类法)。论文同时发布可安装的 HTB(Hallucinated-Tools Benchmark),任意解析器均可提交评测。
与本章关系:直接对应本章「工具调用可靠性」与「工具调用安全性」知识点,本文揭示了工具调用防御体系中一个结构性盲区——"幻觉调用"不是选错工具,而是调用了注册表中不存在的实体,必须用闭世界成员检查而非 Schema 验证来防御;与已收录的「Agent 过度信任工具」(2609.05587,污染内容采纳率 68%)形成互补,共同指向工具调用的两类安全失效:幻觉调用(本文)和污染输出采纳(2609.05587)。
Stale 不等于 Unsafe:基础设施状态竞争下工具调用守卫的精度分析(2026)
发表:2026 年 9 月 25 日 | arXiv:2609.29522
核心贡献:工具调用 Agent 会修改调度器、数据管道、对象存储和访问控制系统。Agent 读操作到提交之间,外部状态可能改变——但并非每次改变都使提交不安全。论文将竞态分为使安全谓词失效的竞态(invalidating races)与无关竞态(predicate-preserving/irrelevant races),并测量三种守卫粒度(全局 epoch、读集版本、语义提交谓词)对二者的区分精度。在 16 个基础设施任务上的 3456 条轨迹实验发现:所有守卫均能消除不安全提交;但基于新鲜度的守卫误封 92–95% 的良性竞态,导致多达 43% 的安全任务被放弃;而完整语义谓词守卫无误封。模型侧信号无法替代语义合约:口头置信度错误校准(ECE ≈ 0.37),谨慎性提示对不安全率几乎无影响。
与本章关系:直接对应本章「工具调用安全性」与「工具副作用控制」知识点,本文量化了工具守卫设计的核心权衡——过于保守的守卫会大幅降低 Agent 的有效工具执行率,而精度不足的守卫又存在安全风险;"语义合约优于新鲜度启发式"的结论为工具调用框架设计提供了直接可操作的架构原则。
REFLEX:TypeSafe 快决策层 + 按需回退强模型,工具选择强调用次数降低 72.7%(2026)
发表:2026 年 9 月 24 日 | arXiv:2609.26532
核心贡献:南洋理工大学(Wu、Lim)提出 REFLEX 架构:以 TypeSafe 决策模型 Jev(jev-1.13.0)作为快速决策层处理高结构化的工具选择,仅在置信度不足或需要自然语言生成时才回退到 GPT-5.4 等强模型。在冻结的 100 题评测集(τ=0.5)上,REFLEX 任务成功率 95%,每任务强模型调用仅 1.12 次,相比强模型独跑(88%/4.10 次)减少了 72.7% 的强模型调用(GMR=0.727);跨 Qwen3.8-Max、Kimi K3、DeepSeek-V4-Pro 回退族,减幅 66%–72%。按动作类型细分:Jev 处理工具选择的比例为 99%、完成判定 77%、检索 56%,但在"是否需要调用"判断上仅处理 52%(是 REFLEX 标注的短板)。BFCL 工具选函数准确率 98.4%,整体约比强模型独跑便宜 3.7 倍。
与本章关系:直接对应本章「工具选择机制」与「工具调用效率」知识点,REFLEX 将工具调用拆分为"类型安全的结构化决策"与"需要推理生成的自然语言决策"两类,并根据决策类型差异化路由到不同规模的模型——这是工具调用领域"成本竞争从比拼底座规格转向细粒度决策分层"趋势的典型实践,为工具密集型 Agent 的推理成本优化提供了直接可复用的架构模式。
ToolSearcher:大规模工具选择的强化学习框架——类别约束判别 + 事件级搜索建模(2026)
发表:2026 年 9 月 29 日 | arXiv:2609.30906
核心贡献:现有工具调用研究多假设工具集规模较小或预先给定,但真实工具仓库包含海量多样工具,无法在上下文窗口内全量展示。本文将大规模工具选择定义为一个全新的 Agentic RL 挑战——现有知识问答 RL 方法在需同时考虑工具兼容性的工具搜索上完全失效。ToolSearcher 提出三项针对性机制:①类别约束工具判别(提升模型区分功能相似工具的能力);②事件级搜索建模(显式优化多轮搜索中"找到目标工具"这一关键事件);③轨迹对齐信用分配(为搜索-选择流程的不同阶段提供细粒度奖励信号)。在大规模工具选择基准的所有挑战设置(迭代搜索 + 复杂工具组合)上,ToolSearcher 一致优于强基线。
与本章关系:直接对应本章「工具检索与选择」与「大规模工具库 Agent」知识点,ToolSearcher 将工具选择从"给定候选集做 top-k"的简化假设扩展到"从海量仓库中主动搜索"的真实工程场景,RL 驱动的事件级优化是解决此问题的关键——与已收录的 REFLEX(轻量快速决策层)形成互补:前者解决的是"工具如何高效找到",后者解决的是"找到后如何低成本调用"。
Cartograph:联邦 MCP 代理 + 算子认证检索,将 374 个工具接口压缩为 3 个代理工具(2026)
发表:2026 年 9 月 29 日 | arXiv:2609.30293
核心贡献:MCP 使 Agent 能发现并调用工具,但随着接入目录增大,全量加载工具定义的开销从 O(n) 迅速膨胀。Cartograph 提出联邦 MCP 代理,将工具发现从 O(n) 目录遍历压缩为 O(k) 渐进式披露,三个核心机制:①算子认证能力卡(Capability Cards)——Ed25519 签名的工具描述,由部署算子而非发布商生成,防止描述误导;②Rift 三层可混淆簇分析(密度聚类 + 查询边界分析 + 词法诊断),识别易混淆工具簇;③两阶段检索——先对服务器排名,再对工具排名。在 22 个服务器、374 个工具的实际部署上,Cartograph 仅暴露 3 个代理工具;49 题自建基准 R@5 达 0.816(Jaccard 关键词基线 0.592),Top-5 发现仅消耗 475 tokens vs 全目录 42,450 tokens;10 次测试平均增加 5ms 延迟(0.8%)。
与本章关系:直接对应本章「工具发现与 MCP 协议」与「大规模工具仓库管理」知识点,Cartograph 解决了 MCP 生态在规模扩张后面临的核心工程问题——如何让 Agent 在海量工具中高效、可信地发现合适工具而不消耗海量上下文;算子认证卡的来源链(provenance)设计,也为本章「工具可信度」议题提供了可落地的技术参考。