4.6 论文解读:记忆系统前沿进展
📖 "记忆不只是存储,更是理解和推理的基础。"
Agent 记忆系统的研究正在快速发展,以下是最有影响力的几项工作。
Generative Agents:虚拟小镇中的记忆里程碑
论文:Generative Agents: Interactive Simulacra of Human Behavior
作者:Park et al., Stanford University & Google Research
发表:2023 | arXiv:2304.03442
核心问题
如何让 AI Agent 像人类一样拥有丰富的内心世界——记住过去的经历、反思这些经历的意义、并据此制定未来的计划?
实验设计
研究者构建了一个名为 Smallville 的虚拟小镇,25 个 AI 居民(Generative Agents)在其中自主生活。每个居民有自己的身份背景(名字、职业、人际关系),并在小镇中自由活动——去咖啡店、上班、与其他居民交谈、参加活动。
令人惊叹的是,这些 Agent 展现出了许多涌现行为:
- 一个 Agent 计划举办情人节派对,自发地邀请其他 Agent
- Agent 之间形成了友谊和社交圈
- Agent 会基于过去的互动调整对其他 Agent 的态度
记忆架构(核心贡献)
Generative Agents 的记忆系统是其最重要的技术创新,包含三个层次:

对 Agent 开发的启示
- "观察-反思-检索"框架是设计 Agent 记忆系统的黄金范式。大多数后续研究都借鉴了这一框架
- 重要性评分的思想——不是所有信息都值得记忆,需要有选择性
- 多维度检索优于单维度检索(纯时间序列或纯语义相似度都不够)
- 反思机制让 Agent 能从具体经历中提炼出抽象知识——这是"智能"的关键标志
MemGPT:操作系统式的记忆管理
论文:MemGPT: Towards LLMs as Operating Systems
作者:Packer et al., UC Berkeley
发表:2023 | arXiv:2310.08560
核心问题
LLM 的上下文窗口是有限的(即使 128K Token 也会耗尽)。当对话足够长或需要处理大量信息时,如何管理这个有限的"内存"?
核心类比:LLM = 计算机
MemGPT 最精妙的洞察是将 LLM 的上下文窗口类比为计算机的内存管理:

方法原理
MemGPT 将上下文窗口分为两个区域:
- 主上下文(Main Context):类似 RAM,放当前最需要的信息(系统提示、近期对话、工作记忆)
- 外部存储(External Storage):类似硬盘,存放完整的对话历史、文档、知识等
关键机制:
- 自我编辑函数:Agent 可以调用
core_memory_append()、core_memory_replace()等函数来主动管理自己的记忆 - 自动换入换出:当 Agent 需要的信息不在主上下文中时,系统自动从外部存储中检索并"换入"
- 暂停与恢复:Agent 可以暂停当前对话,去外部存储中搜索信息,然后恢复
关键发现
- 理论上无限的记忆:通过分层存储,LLM 可以突破上下文窗口的限制
- 主动记忆管理:Agent 自己决定哪些信息值得保留在"工作记忆"中
- 多会话连续性:跨会话的信息可以通过外部存储持续保存
对 Agent 开发的启示
MemGPT 的架构思想在今天的 Agent 开发中非常实用:
- 分层记忆设计:不要把所有信息都塞进 Prompt,而是分层管理
- Agent 自管理记忆:给 Agent 提供记忆管理工具(如本书 4.5 节的实战项目)
- 参考 mem0 等开源方案:mem0 是 MemGPT 理念的开源实现
MemoryBank:遗忘曲线启发的记忆管理
论文:MemoryBank: Enhancing Large Language Models with Long-Term Memory
作者:Zhong et al.
发表:2023 | arXiv:2305.10250
核心问题
现有的记忆系统要么"全部记住"(存储爆炸),要么"只记最新"(遗忘重要信息)。如何模拟人类真实的记忆行为——重要的、经常回忆的记忆被巩固,不重要的、不常回忆的记忆逐渐淡化?
方法原理
MemoryBank 的核心创新是引入了艾宾浩斯遗忘曲线(Ebbinghaus Forgetting Curve):
记忆强度 = 初始强度 × e^(-t/S)
- t = 自上次访问以来的时间
- S = 记忆稳定性(取决于重要性和回顾次数)
实际效果:经常被访问的记忆 → S 增大 → 衰减更慢 → 被"巩固";很久不访问的记忆 → 强度不断衰减 → 最终被“遗忘”
记忆操作
MemoryBank 支持三种核心操作:
- 记忆写入:新信息带初始强度存入
- 记忆回忆:检索时更新访问时间,增加稳定性
- 记忆遗忘:定期扫描,强度低于阈值的记忆被移至"归档区"
对 Agent 开发的启示
- 自然的信息管理:比起手动设置"保留最近 N 条",遗忘曲线更智能
- 用户画像随时间演进:用户的偏好可能会变化,旧偏好自然衰减
- 存储效率:自动淘汰不再需要的信息,控制存储成本
CoALA:Agent 认知架构的统一框架
论文:Cognitive Architectures for Language Agents (CoALA)
作者:Sumers et al.
发表:2023 | arXiv:2309.02427
核心问题
Agent 的记忆系统、推理系统、行动系统之间是什么关系?是否存在一个统一的认知架构来组织这些组件?
CoALA 框架
CoALA 借鉴了认知科学中的认知架构理论(如 ACT-R、SOAR),提出了一个适用于 LLM Agent 的统一框架:

核心贡献
- 统一分类:将现有的 Agent 系统按认知架构的组件进行分类和比较
- 记忆三分法:工作记忆 / 情景记忆 / 语义记忆 的划分比传统的"短期/长期"划分更精细
- 设计指导:为 Agent 开发者提供了一个"清单"——在设计 Agent 时需要考虑哪些认知组件
对 Agent 开发的启示
CoALA 框架帮助我们更系统地思考 Agent 设计:
- 情景记忆 ≠ 语义记忆:前者存储"我经历了什么",后者存储"我知道什么"。两者的检索策略不同
- 工作记忆是推理的基础:复杂推理需要 Scratchpad(详见 4.4 节)
- 学习循环:Agent 不仅要使用记忆,还要从经验中学习并更新记忆
HippoRAG:受海马体启发的长时记忆
论文:HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models
作者:Gutiérrez et al., 俄亥俄州立大学 NLP Group
发表:2024 | NeurIPS 2024 | arXiv:2405.14831
核心问题
人类大脑的海马体能够高效地整合新信息并与已有知识关联,而现有的 RAG 系统只是简单地"检索最相似的片段"——缺乏对知识之间关联关系的建模。
方法原理
HippoRAG 模拟了海马体的记忆索引理论(Complementary Learning Systems):
传统 RAG:文档 → 分块 → 向量化 → 检索最相似片段 → 生成回答(问题:片段之间没有关联,无法跨文档推理)
HippoRAG:
- 离线索引:文档 → LLM 提取知识三元组 → 构建知识图谱
- 在线检索:查询 → 提取实体 → 通过个性化 PageRank 沿图扩展 → 定位最相关文档片段 → 生成回答
关键发现
- 知识图谱作为索引:比纯向量检索更擅长处理需要跨文档关联推理的问题
- 持续学习:新知识可以增量添加到图中,而不需要重新索引所有文档
- 在多跳问答任务上显著优于标准 RAG:在 MuSiQue 等基准上提升 20%+
对 Agent 开发的启示
HippoRAG 为 Agent 的长期记忆提供了一个新范式——用知识图谱作为记忆的索引层,向量数据库作为原始内容的存储层,两者协作实现高质量的记忆检索。这与 CoALA 框架中"语义记忆"的概念高度吻合。
Zep:时序知识图谱驱动的 Agent 记忆
论文:Zep: A Temporal Knowledge Graph Architecture for Agent Memory
作者:Rasmussen et al.
发表:2025 | arXiv:2501.13956
核心问题
现有的 Agent 记忆系统大多忽略了时间维度——信息何时被记录、何时过期、不同时间点的信息如何演变。但在实际应用中,时间信息至关重要:
用户偏好的演变:2025年1月"用户喜欢用 Python" → 6月"用户开始转向 Rust" → 12月"用户现在主要用 Rust"
没有时间建模 → Agent 不知道该推荐哪种语言;有时间建模 → Agent 知道用户最新偏好是 Rust
方法原理
Zep 将 Agent 的记忆组织为时序知识图谱(Temporal Knowledge Graph):
核心数据结构:(实体, 关系, 实体, 时间戳, 有效期)
例如:
(用户A, 偏好语言, Python, 2025-01, 2025-05)(用户A, 偏好语言, Rust, 2025-06, 当前)
检索时同时考虑:语义相关性(图结构遍历)+ 时间相关性(优先返回最新、仍有效的记忆)+ 情景上下文(关联同一时期的其他记忆)
对 Agent 开发的启示
- 时间感知是长期记忆的必要条件:特别是在个人助手、客户服务等场景中
- 知识图谱是记忆组织的理想结构:比纯向量列表更能表达实体间的复杂关系
- Zep 已开源并提供 Python SDK,可以直接集成到 LangChain / LangGraph 项目中
论文对比与发展脉络
| 维度 | Generative Agents | MemGPT | MemoryBank | CoALA | HippoRAG | Zep |
|---|---|---|---|---|---|---|
| 年份 | 2023 | 2023 | 2023 | 2023 | 2024 | 2025 |
| 核心创新 | 观察-反思-检索框架 | OS 式分层存储 | 遗忘曲线记忆管理 | 统一认知架构 | 海马体索引理论 | 时序知识图谱 |
| 记忆类型 | 记忆流 + 反思 | 主上下文 + 外部存储 | 遗忘曲线驱动 | 工作/情景/语义 | 知识图谱索引 | 时序图 + 情景 |
| 特色 | 反思机制 | 自我编辑内存 | 自然记忆衰减 | 理论框架 | 跨文档关联 | 时间感知 |
| 适用场景 | 社会模拟 | 长对话 | 用户画像 | 系统设计 | 知识密集任务 | 个人助理 |
发展脉络:
Generative Agents(建立了记忆系统的基本范式)→ MemGPT(解决"上下文窗口有限"的工程问题)→ MemoryBank(引入认知科学中的遗忘机制)→ CoALA(提供统一的理论框架)→ HippoRAG(用知识图谱作为记忆索引层,NeurIPS 2024)→ Zep + mem0(时序图谱 + 工业级记忆方案,2025)
💡 前沿趋势(2025-2026):记忆系统正在从"被动存储"向"主动组织"演进,两大关键趋势:① 知识图谱成为记忆的核心:HippoRAG、Zep、mem0 都采用了图结构来组织记忆,相比纯向量存储能更好地表达实体关系和支持多跳推理;② 时间感知记忆:Agent 需要理解"什么时候知道了什么"、"哪些信息已过时",Zep 的时序知识图谱和 MemoryBank 的遗忘曲线代表了两种互补的时间建模方案。mem0 作为开源记忆层方案已获得广泛采用,支持自动记忆提取、冲突检测和图结构记忆。supermemory 则代表了另一种工业级路线——它将 RAG 与 Memory 融合为统一的上下文引擎,支持自动事实提取、用户画像维护、多模态文档处理,并在 LongMemEval、LoCoMo、ConvoMem 三大基准上均排名第一,同时提供 MCP 服务和主流框架集成(LangChain、LangGraph、Vercel AI SDK 等)。
📰 最新论文速递
🗓️ 本节由每日自动更新任务维护,最近更新:2026 年 9 月 29 日
ProactAgent:经验驱动的终身 Agent 主动检索框架(2026)
🧬 一句话:把记忆检索从"被动触发"升级为"主动决策",用 ProactRL 把检索建模成显式策略动作,只在能带来更好结果时才检索。
核心问题:在线终身学习让 Agent 跨交互累积经验、持续改进长视野任务。但现有方法把"从过去经验检索"当被动操作——只在任务初始化或完成一步后触发,导致 Agent 在交互中无法识别知识缺口、主动检索最有用经验。
方法介绍:ProactAgent 是经验驱动的终身学习框架,在结构化经验库上做主动检索。先引入 Experience-Enhanced Online Evolution,把检索建模为显式策略动作,用 **ProactRL(主动强化学习检索)**配对分支过程奖励学习"何时检索"和"检索什么"——只有检索能带来更好任务结果时才触发。经验库按类型组织为事实记忆、情节记忆、行为技能三仓库。框架概览见下图:
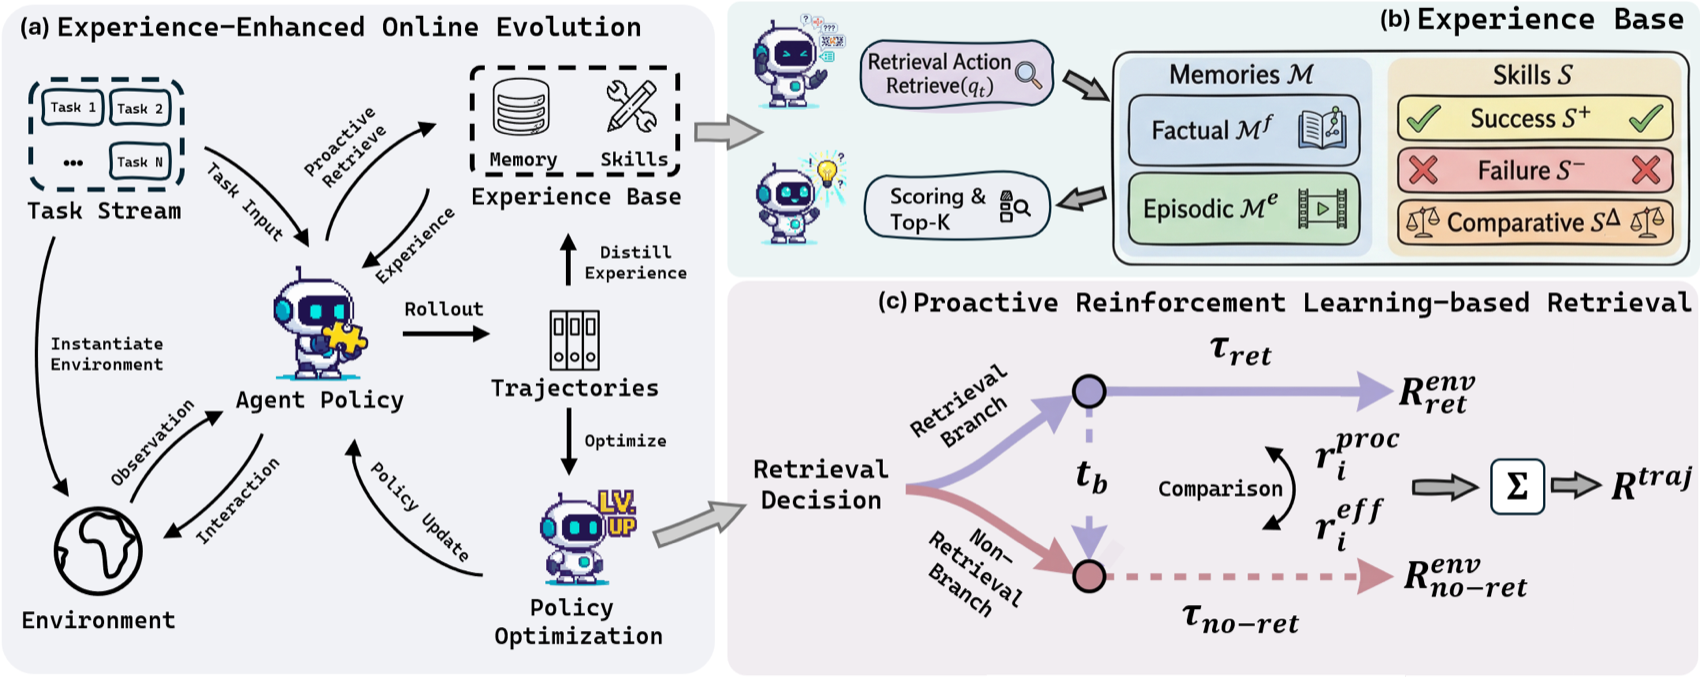
图源:ProactAgent 论文(来源:2026, arXiv:2604.20572)
关键结果:在 SciWorld(73.50%)和 AlfWorld(71.28%)上显著提升终身 Agent 成功率。
与本章关系:与本章 4.2 节「记忆类型」(事实/情节/技能三分法)和 4.4 节「记忆检索」高度对应,是「主动式记忆检索」方向的最新实践,为检索时机决策提供了 RL 范式的解决方案。
FSFM:仿生的 Agent 记忆选择性遗忘框架(2026)
🧬 一句话:受海马索引/巩固理论与艾宾浩斯遗忘曲线启发,把遗忘分四类(被动衰减/主动删除/安全触发/自适应强化),证明"精心遗忘与记忆保留同等重要"。
核心问题:LLM Agent 中记忆管理是直接影响效率、质量与安全的关键挑战。大量研究关注记忆保留与检索,但生物选择性遗忘机制与策略同样重要却 largely 未探索。
方法介绍:FSFM 是神经启发的选择性遗忘框架,直接借鉴人类认知过程——海马记忆索引/巩固理论与艾宾浩斯遗忘曲线。把遗忘机制分四类:被动衰减型、主动删除型、安全触发型、自适应强化型,针对资源受限环境论证"精心设计的遗忘与记忆保留同等重要"。生物启发概览见下图:
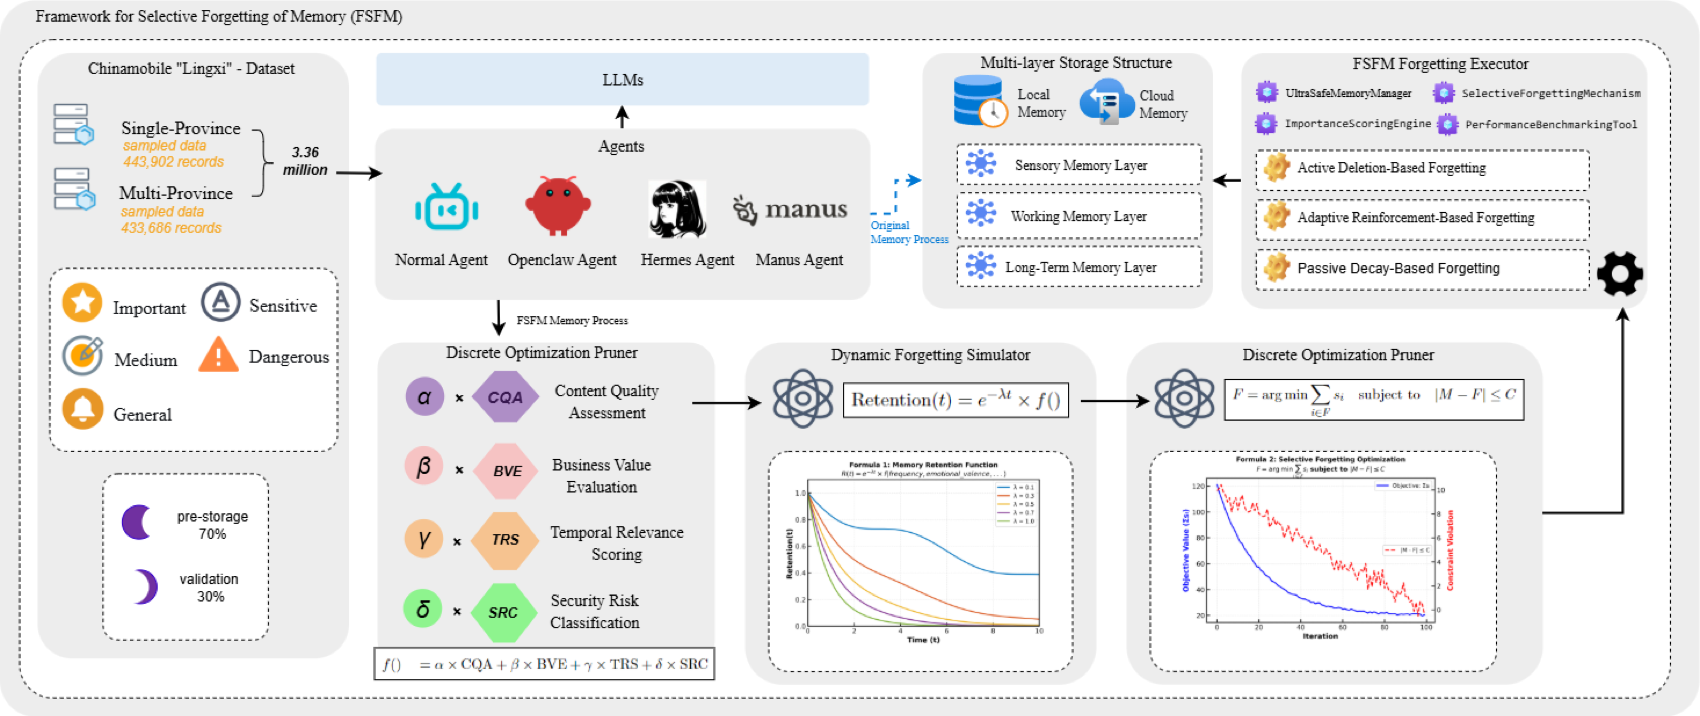
图源:FSFM 论文(来源:2026, arXiv:2604.20300)
关键结果:访问效率提升 8.49%、内容质量信噪比提升 29.2%、安全风险消除率 100%(主动删除恶意/隐私敏感记忆)。
与本章关系:填补了本章记忆管理讨论中「何时/如何删除过期记忆」的空白,与 MemoryBank 的遗忘曲线思路互补,为记忆安全治理提供了系统性的分类框架。
AI Agent 记忆系统现状 2026:10 种方法基准测评(2026)
🧬 一句话:mem0 团队在 LOCOMO 上横向测评 10 种主流记忆方案(准确率/延迟/Token 三维),图增强 Mem0g 以 <5pp 精度差+低延迟成为最优生产方案。
核心问题:Agent 记忆方案百花齐放,但缺乏同时涵盖准确率、延迟、Token 成本的横向基准,选型无实证依据。
方法介绍:mem0 团队在 LOCOMO 基准上对 10 种主流 Agent 记忆方案(Full-context、Mem0、Mem0g 图增强、OpenAI Memory、RAG、MemGPT 等)横向测评,覆盖准确率、延迟、Token 消耗三维。
关键结果:全上下文注入精度最高(72.9%)但 P95 延迟 17 秒,不可用于生产;Mem0 仅损失 6pp 精度,换来 91% 延迟下降和 90% Token 节省;图增强 Mem0g 把精度差距压缩至 <5pp 同时保持低延迟——是最优生产就绪方案。报告还揭示记忆系统已从可选组件演进为 Agent 一等架构组件,21 个框架、19 个向量数据库已完成集成。
与本章关系:为本章 4.2 节「记忆类型」和 4.4 节「记忆检索」提供了全球首份包含延迟和 Token 成本的横向基准数据,也是选型决策的实证依据。
Prism:面向多 Agent 开放式发现的进化记忆基底(2026)
🧬 一句话:把层次文件持久化、向量语义、图关系、多 Agent 进化搜索四大范式统一在单一决策论框架下,用熵门控路由+复制子衰减动力学收敛到进化稳定记忆集。
核心问题:多 Agent 开放式发现需要进化记忆基底,但现有记忆范式(层次文件、向量语义、图关系、进化搜索)各自孤立,缺乏统一决策框架。
方法介绍:PRISM(概率检索+信息分层记忆)把四大范式统一在单一决策论框架下。三大核心机制:①熵门控分层路由——基于 Shannon 信息熵把记忆自动分配到技能/笔记/尝试三元枢纽;②因果记忆图——追踪每条记忆的 Agent 贡献来源并支持干预溯源;③复制子衰减动力学——把记忆置信度建模为进化适应度,收敛至进化稳定记忆集(ESMS)。
关键结果:在 LOCOMO 基准上 LLM-as-a-Judge 得分 88.1,超越 Mem0 达 31.2%。
与本章关系:直接对应本章 4.2 节「记忆类型」与 4.4 节「记忆检索」,是将向量记忆、图记忆与进化搜索融合为统一记忆架构的前沿尝试,也为本章末尾 mem0 vs supermemory 的选型对比提供了新的竞争参照系。
Omni-SimpleMem:自主研究驱动的终身多模态 Agent 记忆框架(2026)
🧬 一句话:用无人工干预的自主研究管道跑 50 次实验自动发现记忆框架,F1 从 0.117→0.598,最有价值的改进来自 bug 修复和提示优化而非超参。
核心问题:AI Agent 跨扩展时间 horizon 运作,但保留、组织、回忆多模态经验的能力仍是关键瓶颈。构建有效终身记忆需在架构、检索、提示、数据管道的庞大设计空间中导航——这空间太大且相互关联,手工探索或传统 AutoML 难以有效覆盖。
方法介绍:本文部署自主研究管道发现 Omni-SimpleMem——终身 AI Agent 的统一多模态记忆框架。从朴素基线(LoCoMo F1=0.117)出发,管道自主执行约 50 次实验,跨两个基准自动诊断失败模式、提架构改进、修复数据管道。框架见下图:
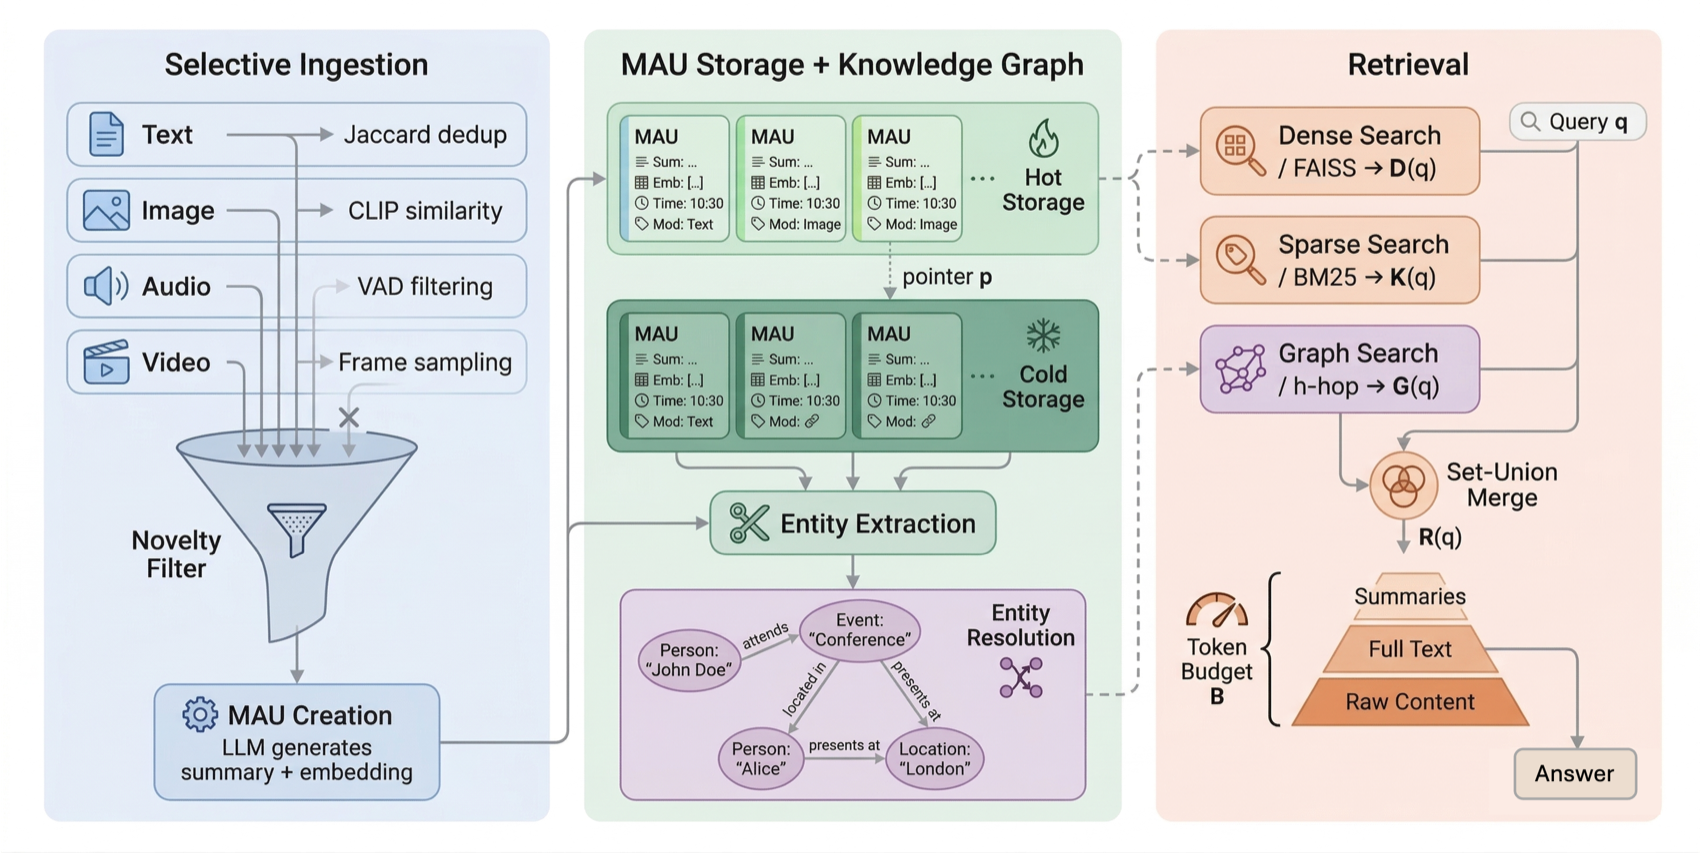
图源:Omni-SimpleMem 论文(来源:2026, arXiv:2604.01007)
关键结果:LoCoMo 达 F1=0.598(提升 411%),Mem-Gallery 达 F1=0.797(提升 214%),两项 SOTA。最有价值改进来自 bug 修复(+175%)和提示优化(+188%),远超所有超参调整之和。
与本章关系:直接对应本章「记忆系统设计」议题,是将自主研究(Auto-Research)方法首次应用于多模态记忆框架发现的前沿工作,为记忆系统架构探索提供了全自动化的新路径。
StructMem:面向长时行为的分层结构化记忆框架(2026)
🧬 一句话:用事件级绑定保留+跨事件关系归纳+双视角时序锚定+周期语义整合,兼顾扁平记忆的效率与图记忆的推理能力。
核心问题:LLM Agent 长期对话记忆面临两难——扁平记忆高效但缺关系建模,图结构记忆支持推理但构建代价昂贵。
方法介绍:StructMem 是结构化分层记忆框架,通过事件级绑定保留、跨事件关系归纳、双视角时序锚定、周期性语义整合,在 LoCoMo 上同时提升时序推理和多跳问答性能。三种记忆范式对比见下图:
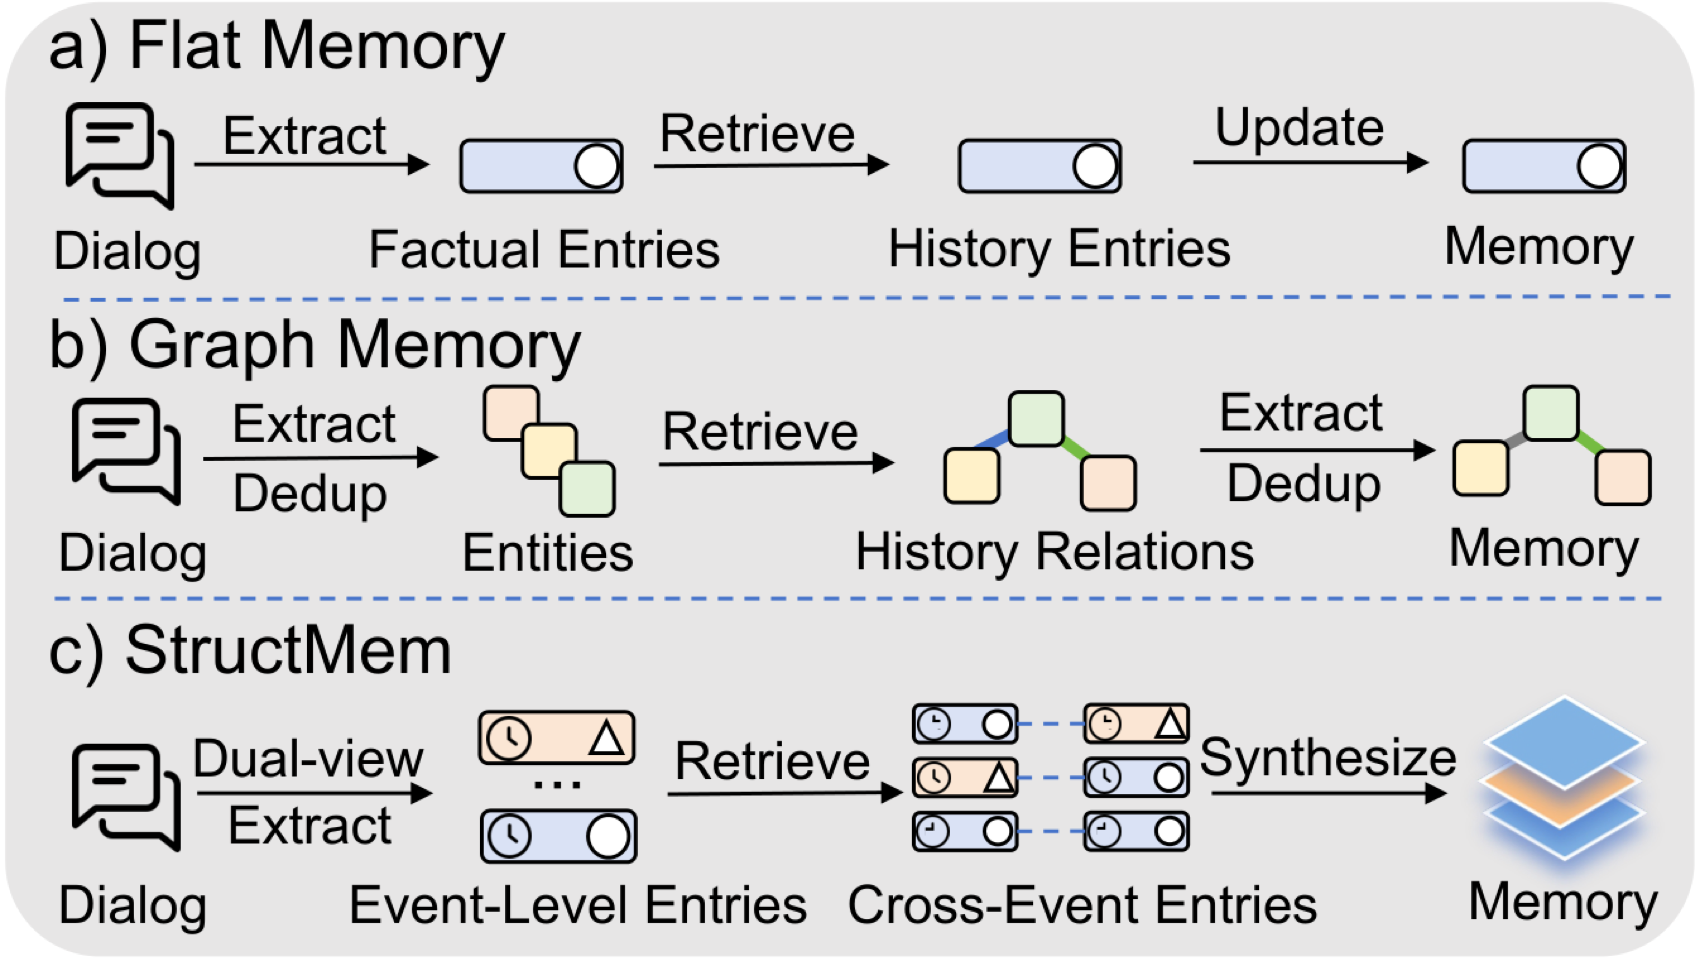
图源:StructMem 论文(来源:2026, arXiv:2604.21748,ACL 2026)
关键结果:显著减少 token 用量、API 调用次数与运行时间,同时提升时序推理与多跳问答性能。
与本章关系:对应本章 4.2「记忆类型」与 4.4「记忆检索」核心知识点,为实现兼顾效率与结构化推理的 Agent 长期记忆提供了经 ACL 2026 认可的完整方案。
AEL:通过经验演化学习提升开放环境中的 Agent 自我改进(2026)
🧬 一句话:双时间尺度——快用 Thompson Sampling bandit 学检索策略,慢用 LLM 反思诊断失败注入因果洞见;揭示"少即是多":记忆+反思+58%,每加一机制反降。
核心问题:LLM Agent 在数百顺序 episode 的开放环境中运作,却基本无状态——每个任务从零解,没把过去经验转成更好未来行为。核心障碍不是"记什么"而是"记住了什么"——用哪种检索策略、如何解读先验结果、何时该改变当前策略。
方法介绍:AEL(Agent Evolving Learning)是双时间尺度框架。快时间尺度用 Thompson Sampling 老虎机学每次用哪种记忆检索策略;慢时间尺度由 LLM 驱动的反思诊断失败模式,把因果洞见注入决策提示。框架概览见下图:
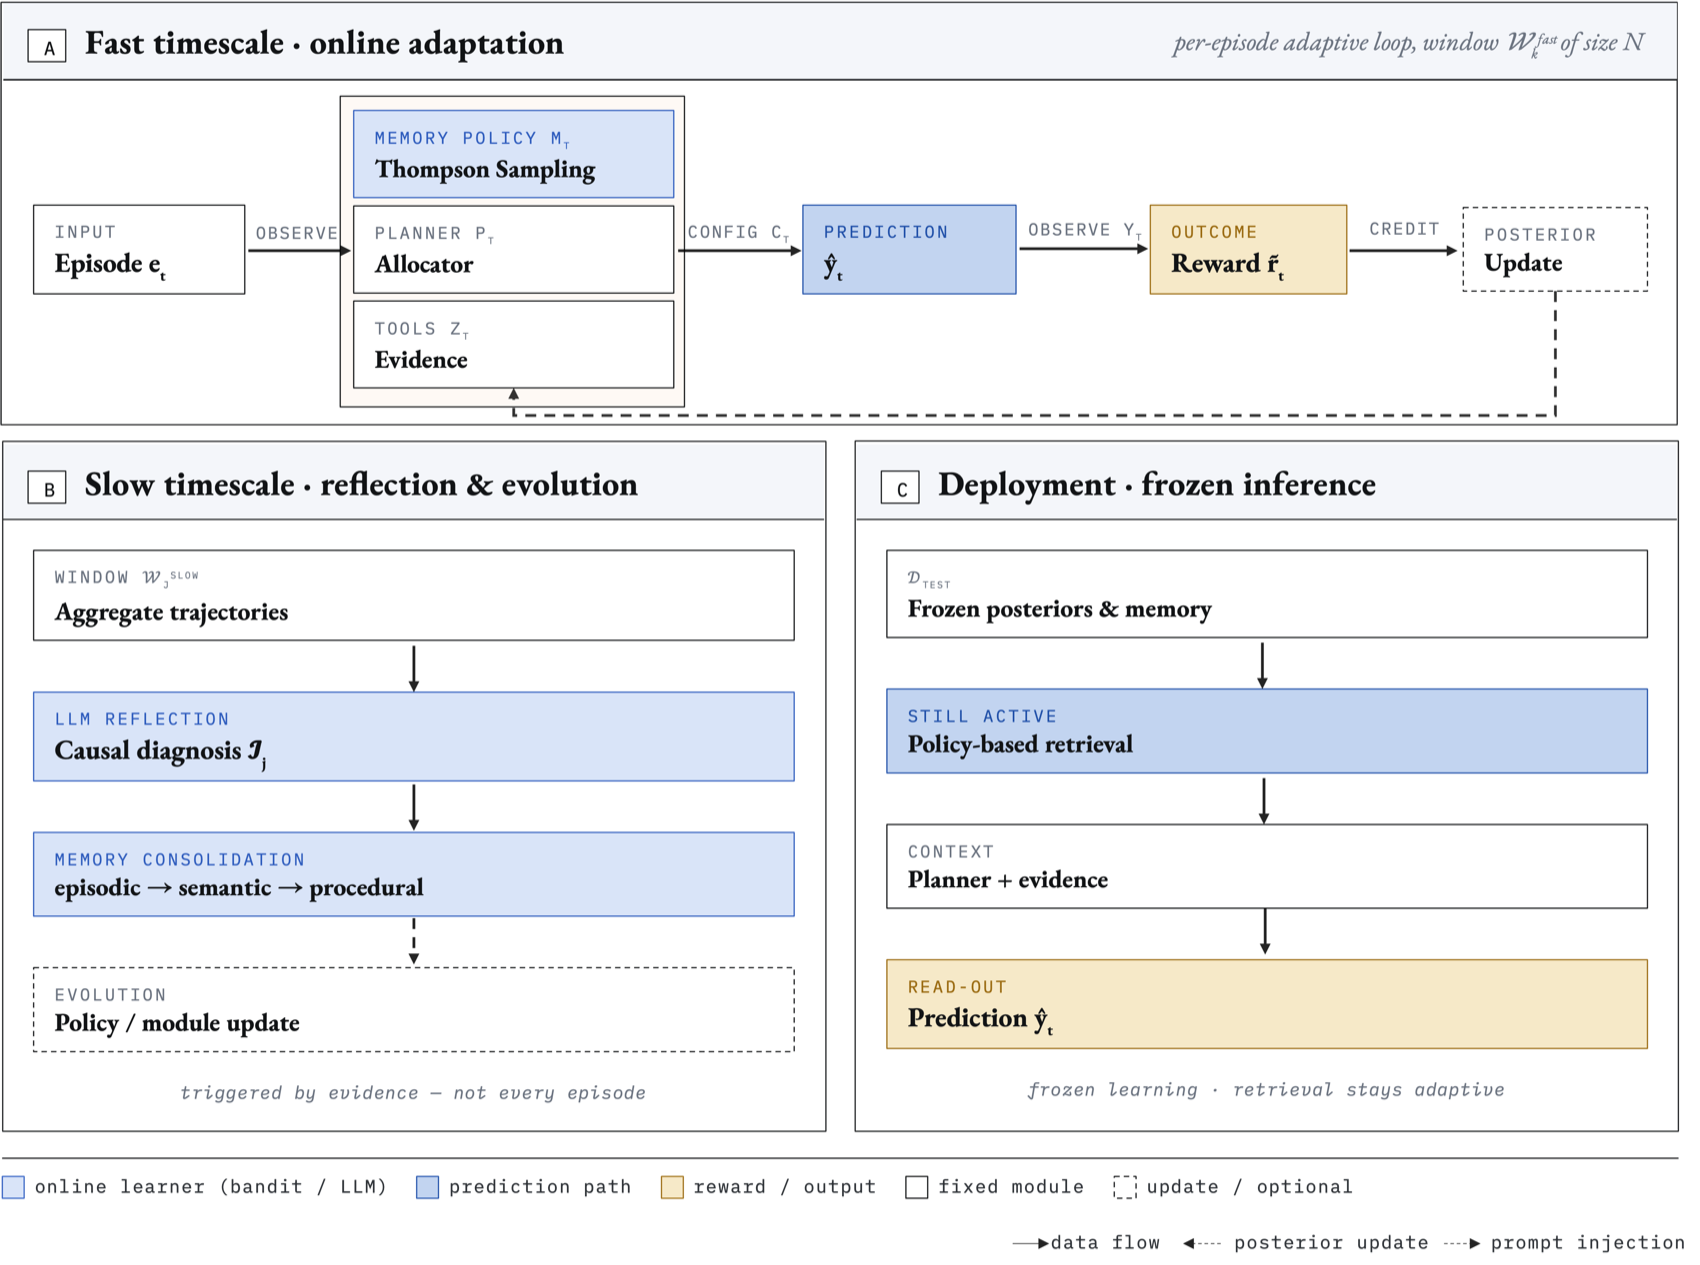
图源:AEL 论文(来源:2026, arXiv:2604.21725)
关键结果:消融揭示"少即是多"——记忆+反思带来 58% 累积提升,但每增加一个机制(规划演化、技能提取等)性能均下降。
与本章关系:直接呼应本章 4.4「记忆检索策略」议题,深刻揭示了记忆系统的核心瓶颈不在于存什么而在于如何使用,为 Agent 记忆利用策略的设计提供了清晰的研究方向。
Memanto:基于信息论检索的类型化语义记忆层(2026)
🧬 一句话:颠覆"高保真记忆必须依赖知识图谱"假设,用 13 类类型化语义模式+Moorcheh 信息论搜索(零索引/亚90ms/零入库延迟),少 250 倍参数超混合图谱。
核心问题:从无状态推理到持久多会话自主 Agent 的转变,揭示了记忆是生产级 Agentic 系统的主要架构瓶颈。现有方法多依赖混合语义图架构——摄入与检索都带来大量计算开销(LLM 实体抽取、显式图 schema 维护、多查询检索管道)。
方法介绍:Memanto 是面向 Agent 的通用记忆层,挑战"知识需图"的主流假设。它用 13 个预定义记忆类别的类型化语义模式,配自动冲突解决与时间版本控制,依托 Moorcheh 信息论搜索引擎(零索引、亚 90 毫秒确定性检索、零入库延迟、单次查询)。
关键结果:在 LongMemEval 和 LoCoMo 上分别达 89.8% 和 87.1% 最优准确率,以少 250 倍可训练参数全面超越混合图谱与向量数据库方案。
与本章关系:与本章 4.3 节「长期记忆」和 4.4 节「记忆检索」直接对应,是当前在 LongMemEval 基准上的最优方案,展示了无图结构记忆架构的可行性。
Oblivion:衰减驱动激活的自适应 Agent 记忆控制(2026)
🧬 一句话:每条记忆带随时间衰减的激活值,仅高于阈值才可检索,但上下文强化/显式访问可重激活——"有序遗忘"减 40%+ 上下文占用。
核心问题:选择性遗忘、巩固、重学习是人类记忆的适应属性——经验随时间变不易访问,但可通过强化或上下文线索重激活。而记忆增强 LLM Agent 依赖"always-on 检索"与"扁平存储",随历史增长导致高干扰与延迟。
方法介绍:Oblivion 受人类记忆遗忘与重激活机制启发,为 Agent 记忆引入动态衰减机制——每条记忆有随时间降低的激活值,仅高于阈值的才可被检索;但经上下文强化或显式访问的记忆可被重新激活。这一"有序遗忘"让 Agent 自动过滤陈旧低质记忆。架构设计见下图:
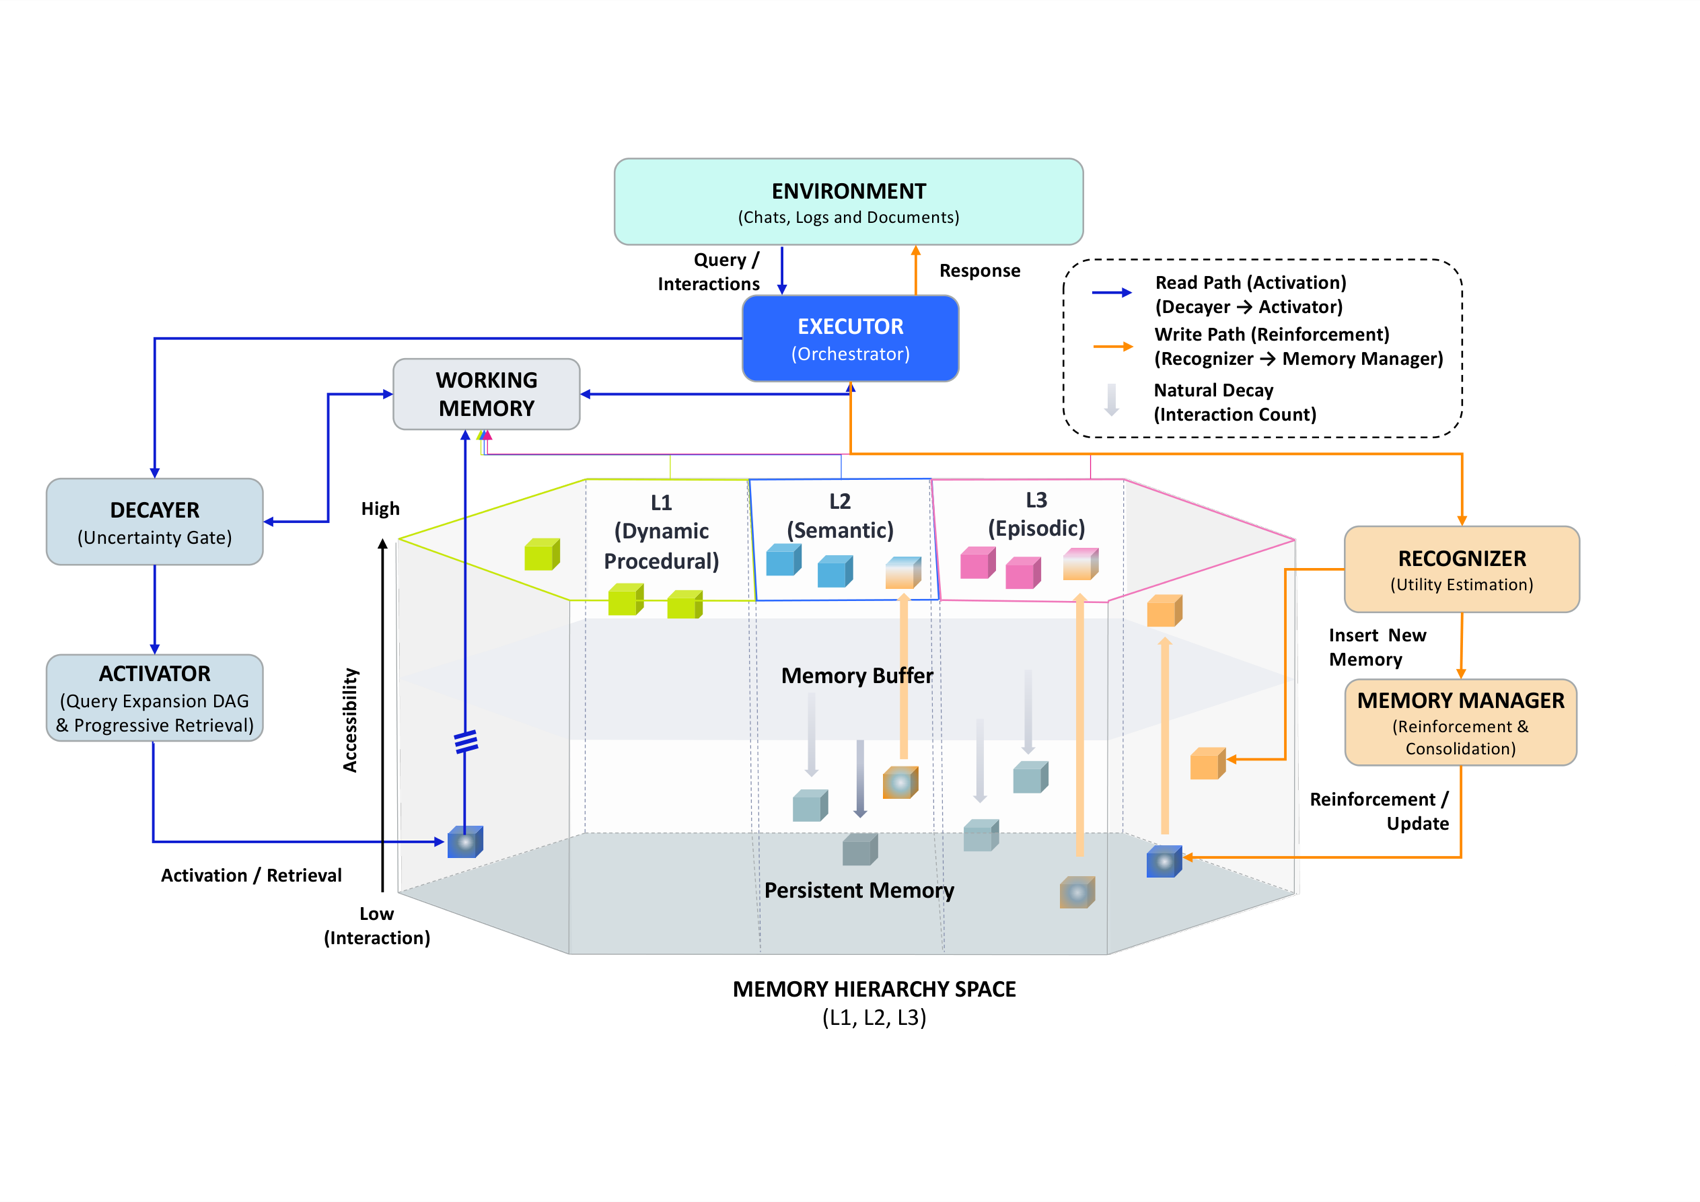
图源:Oblivion 论文(来源:2026, arXiv:2604.00131)
关键结果:任务相关性排序超越传统全量存储方案,上下文占用减少 40% 以上;代码已开源。
与本章关系:与本章 4.3 节「遗忘机制」与 FSFM 论文形成互补,从激活值建模角度为记忆管理提供了另一种仿生方案。
OCR-Memory:用视觉编码突破 Agent 长程记忆的上下文瓶颈(2026)
🧬 一句话:把历史轨迹渲染成带视觉标识符的图像,用视觉模态高密度表示突破文本 token 瓶颈,检索时"定位-转录"恢复逐字文本。
核心问题:自主 LLM Agent 在长视野交互中需复用扩展历史累积的经验。但现有记忆系统受文本上下文预算根本约束——存或重访原始轨迹 token 极贵,摘要与纯文本检索虽省 token 却换来信息丢失与碎片化证据。
方法介绍:OCR-Memory(Optical Context Retrieval Memory)用视觉模态作为 agent 经验的高密度表示,以最小开销保留任意长历史——把历史轨迹渲染为附唯一视觉标识符的图像;检索时用"定位-转录"范式,通过视觉锚点选相关区域后直接恢复逐字文本,避免自由式生成减少幻觉。框架概览见下图:
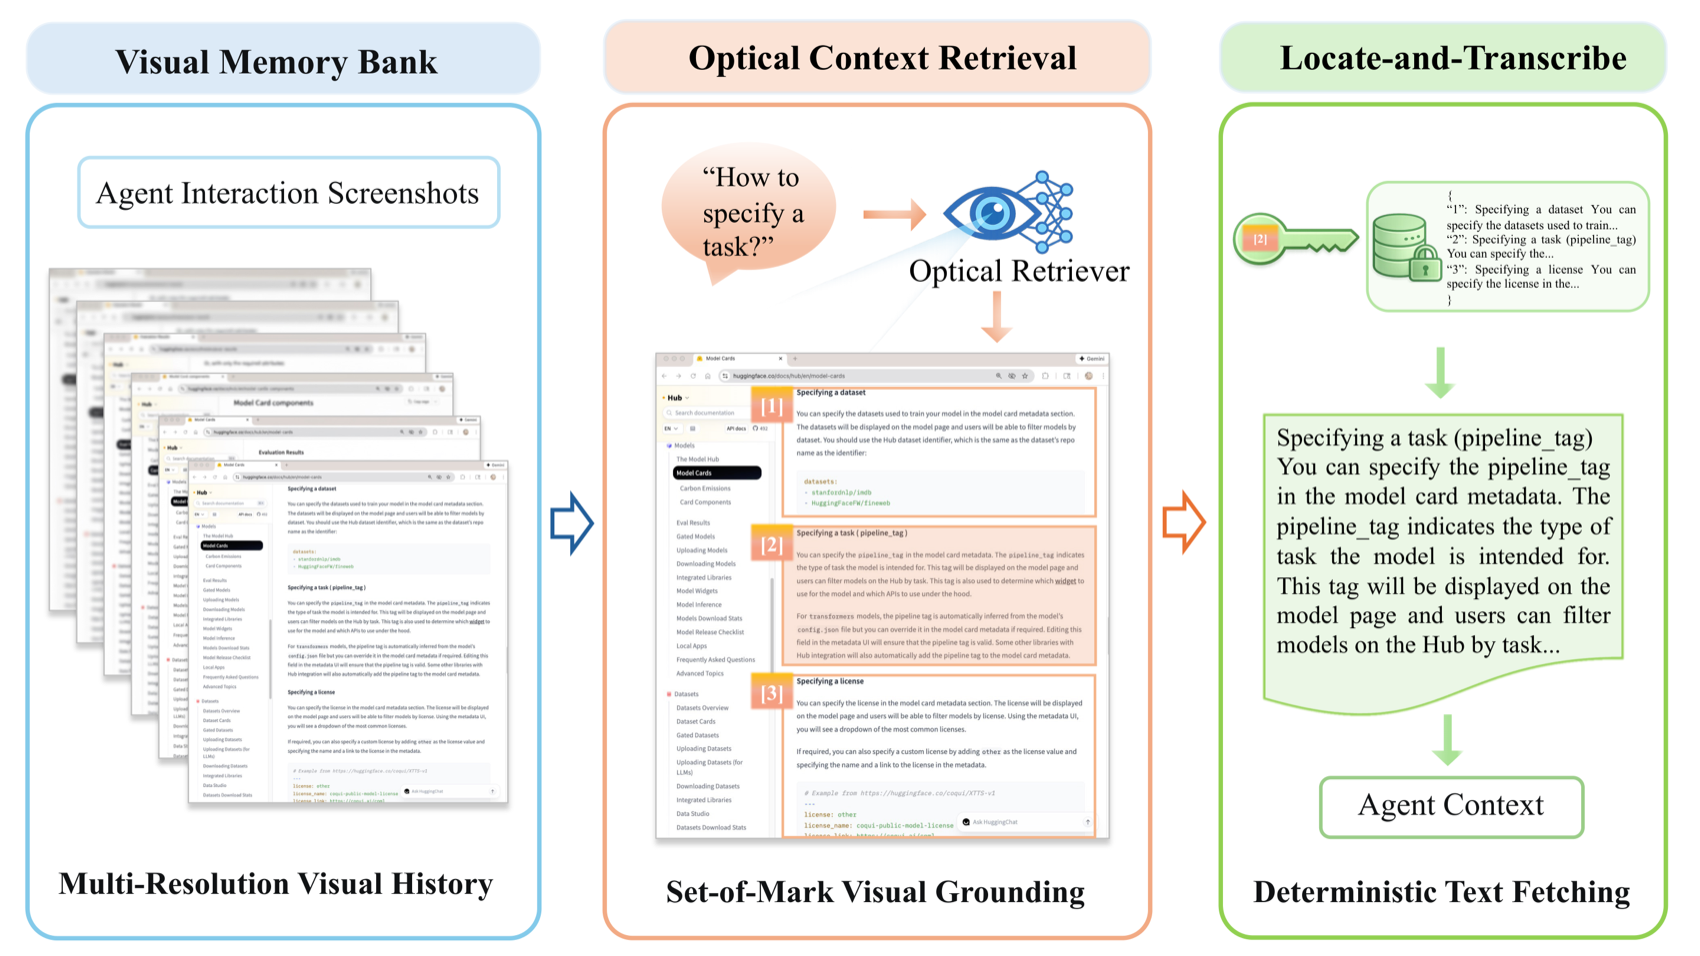
图源:OCR-Memory 论文(来源:2026, arXiv:2604.26622,ACL 2026)
关键结果:在严格上下文约束下的长程 Agent 基准上取得一致性增益,已被 ACL 2026 主会议接收。
与本章关系:直接扩展了本章 4.2 节「外部记忆存储」的技术边界,为超长历史轨迹的高保真检索提供了视觉模态新路径。
MEMTIER:面向长期自主 AI Agent 的分层记忆架构与检索瓶颈分析(2026)
🧬 一句话:诊断长期 Agent 72 小时工具成功率掉 14pp 的四类扁平记忆失效,建三层架构+五信号加权检索+PPO 调权,精度 5%→38.2%。
核心问题:长期运行自主 AI Agent 面临已记录的记忆一致性问题——工具执行成功率在 72 小时窗口内退化 14 个百分点,根因是现有扁平文件记忆系统的四类叠加失效模式。
方法介绍:MEMTIER 是 OpenClaw agent 运行时的三层记忆架构——结构化情节 JSONL 存储、五信号加权检索引擎、基于归因的认知权重更新循环、把情节事实提升到语义层的异步巩固守护进程,并用基于 PPO 的策略框架动态调整检索权重。系统架构见下图:
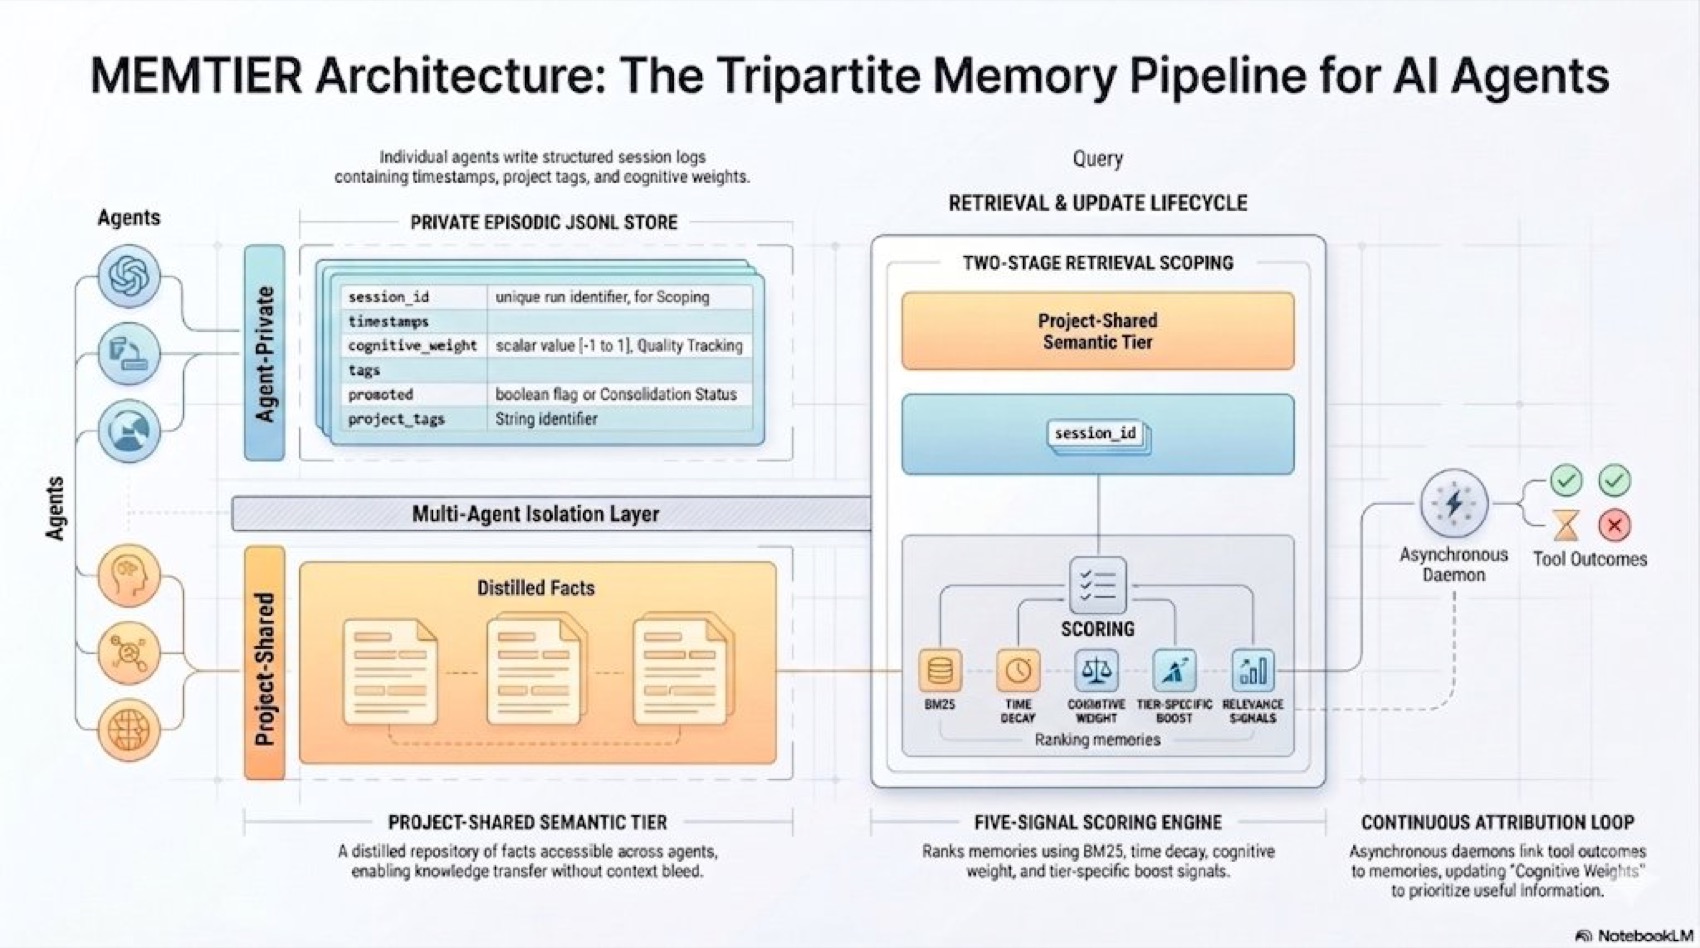
图源:MEMTIER 论文(来源:2026, arXiv:2605.03675)
关键结果:在 LongMemEval-S 上精度从 5% 提升至 38.2%(+33 个百分点),可在消费级 GPU(6GB 显存)上高效运行;诊断还揭示 PPO 在原始 BM25 主导与识别下失效。
与本章关系:与本章 4.3 节「长期记忆架构」和 4.4 节「记忆检索」直接对应,是专门针对长时运行 Agent 记忆衰减问题的系统性解决方案,为生产部署中的记忆持久化提供了实证基础。
HAGE:强化学习驱动加权图演化的 Agent 记忆动态检索(2026)
🧬 一句话:把记忆检索从静态向量查询升级为查询条件化的加权多关系图遍历,每条边带可训练关系特征向量,RL 联合优化路由与边权。
核心问题:Agentic LLM 系统的记忆检索常被当静态查询问题——依赖扁平向量搜索或固定二元关系图。但固定图结构无法捕捉事件间关系的强度、置信度与查询相关性的变化。
方法介绍:HAGE 是加权多关系记忆框架,把检索重新概念化为在统一关系记忆图上的顺序、查询条件化遍历。记忆组织为共享记忆节点上的关系特定图视图,每条边关联一个可训练关系特征向量(编码多种关系),并通过强化学习联合优化路由行为与边权表示,实现跨对话的记忆图持续演化。架构概览见下图:
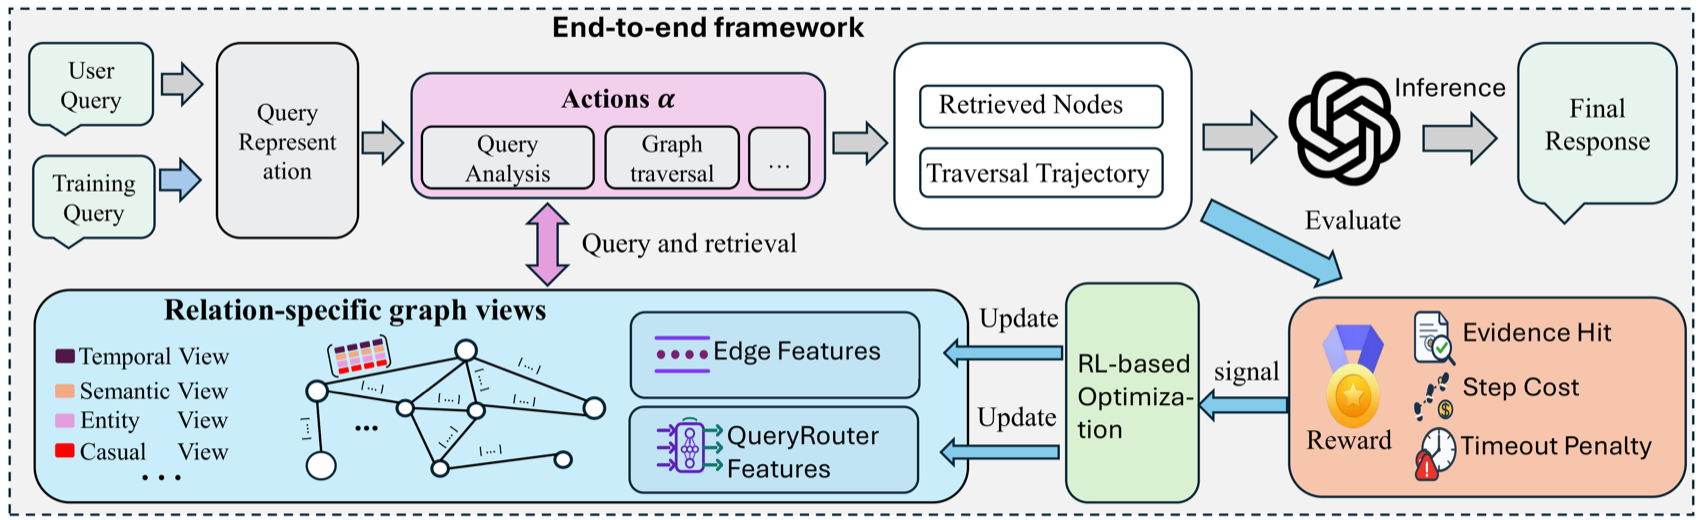
图源:HAGE 论文(来源:2026, arXiv:2605.09942)
关键结果:在长视野推理基准上,相比 RAG 基线在准确性与检索效率上均显著提升。
与本章关系:直接扩展本章 4.2 节「外部记忆存储」与 4.4 节「记忆检索」知识点,是将 RL 引入记忆图演化的最新进展,与 MEMTIER 的分层架构形成互补——前者关注图结构演化,后者关注层次化组织。
Mem-W:统一隐空间原生记忆 GUI Agent(2026)
🧬 一句话:把历史轨迹和当前情节前缀都投影到同一连续隐空间,自蒸馏+结果感知监督端到端训练,免手工记忆分类,最高 +30.0%。
核心问题:GUI Agent 开始操作 Web/移动/桌面作为交互世界,成功控制依赖把视觉、程序、任务级证据带过转瞬即逝的当前屏幕。但多数 Agent 把记忆当外部人类可读制品——历史被摘要、分类、检索后以文本/结构化记录重插入,再被 policy 重新编码。这造成记忆存储表示形式与现代 GUI policy 的 latent embedding 序列之间的错配。
方法介绍:Mem-W 提出统一隐空间原生记忆——用可学习轨迹压缩器把历史轨迹和当前情节前缀都投影到同一连续隐空间,通过自蒸馏和结果感知监督端到端训练,无需任何手工记忆分类。框架见下图:
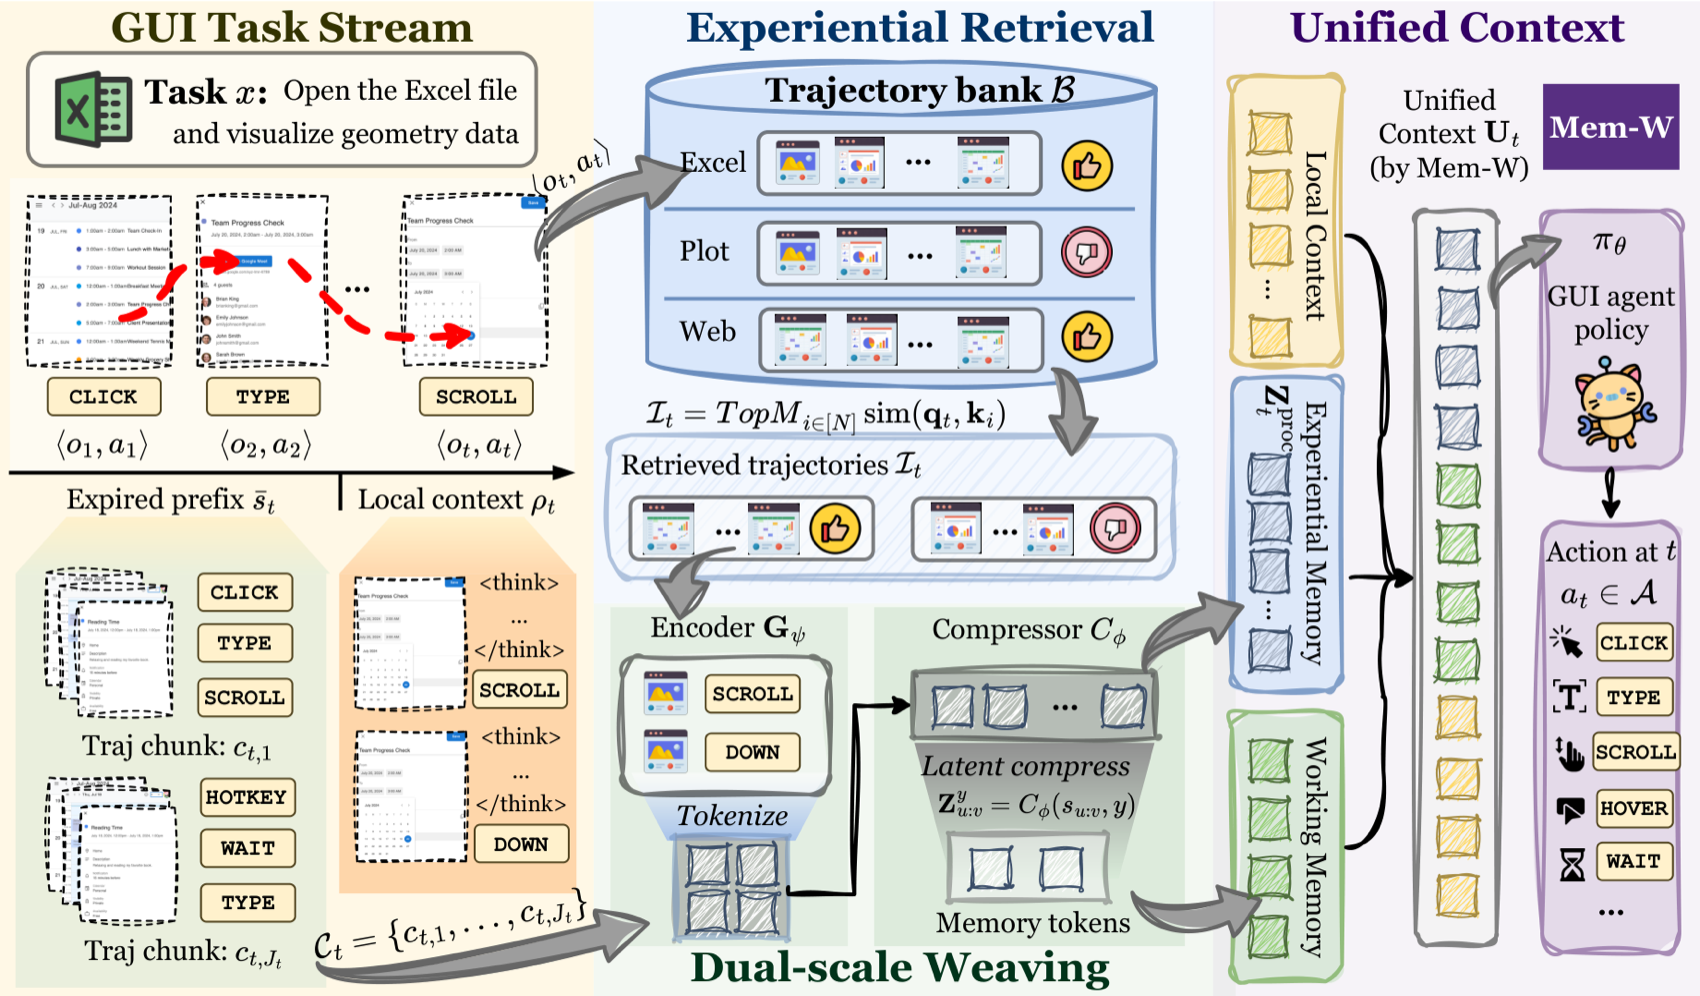
图源:Mem-W 论文(来源:2026, arXiv:2605.09317)
关键结果:在四个 web/移动导航基准上较主流 GUI Agent 最高提升 +30.0%,且随记忆库增长呈现良好扩展性。
与本章关系:对应本章 4.2 节"语义记忆与情节记忆",展示了将两类记忆融合到单一隐空间的端到端学习范式,是记忆系统设计的前沿探索。
MementoGUI:面向长程 GUI Agent 的多模态记忆控制(2026)
🧬 一句话:plug-in 记忆框架 MementoCore 在线选择/压缩/检索界面事件,文本摘要+ROI 级视觉证据入工作记忆,情景记忆检索可复用轨迹,免微调即插即用。
核心问题:GUI Agent 在视觉定位和动作预测上进步显著,但在需跨多次界面转换维护任务状态的长程任务上仍脆弱。现有 Agent 靠原始历史回放或纯文本记忆——前者用冗余截图淹没模型,后者丢弃未来决策所需的局部视觉证据。
方法介绍:MementoGUI 是 plug-in 记忆框架,为 MLLM GUI Agent 配备 MementoCore——一个在线选择、压缩、检索记忆的学习控制器。它不把交互历史当固定上下文,而是把文本摘要与 ROI 级视觉证据保存到工作记忆,并通过情景记忆检索可复用历史轨迹;即插即用增强现有 GUI Agent,无需微调骨干。框架见下图:
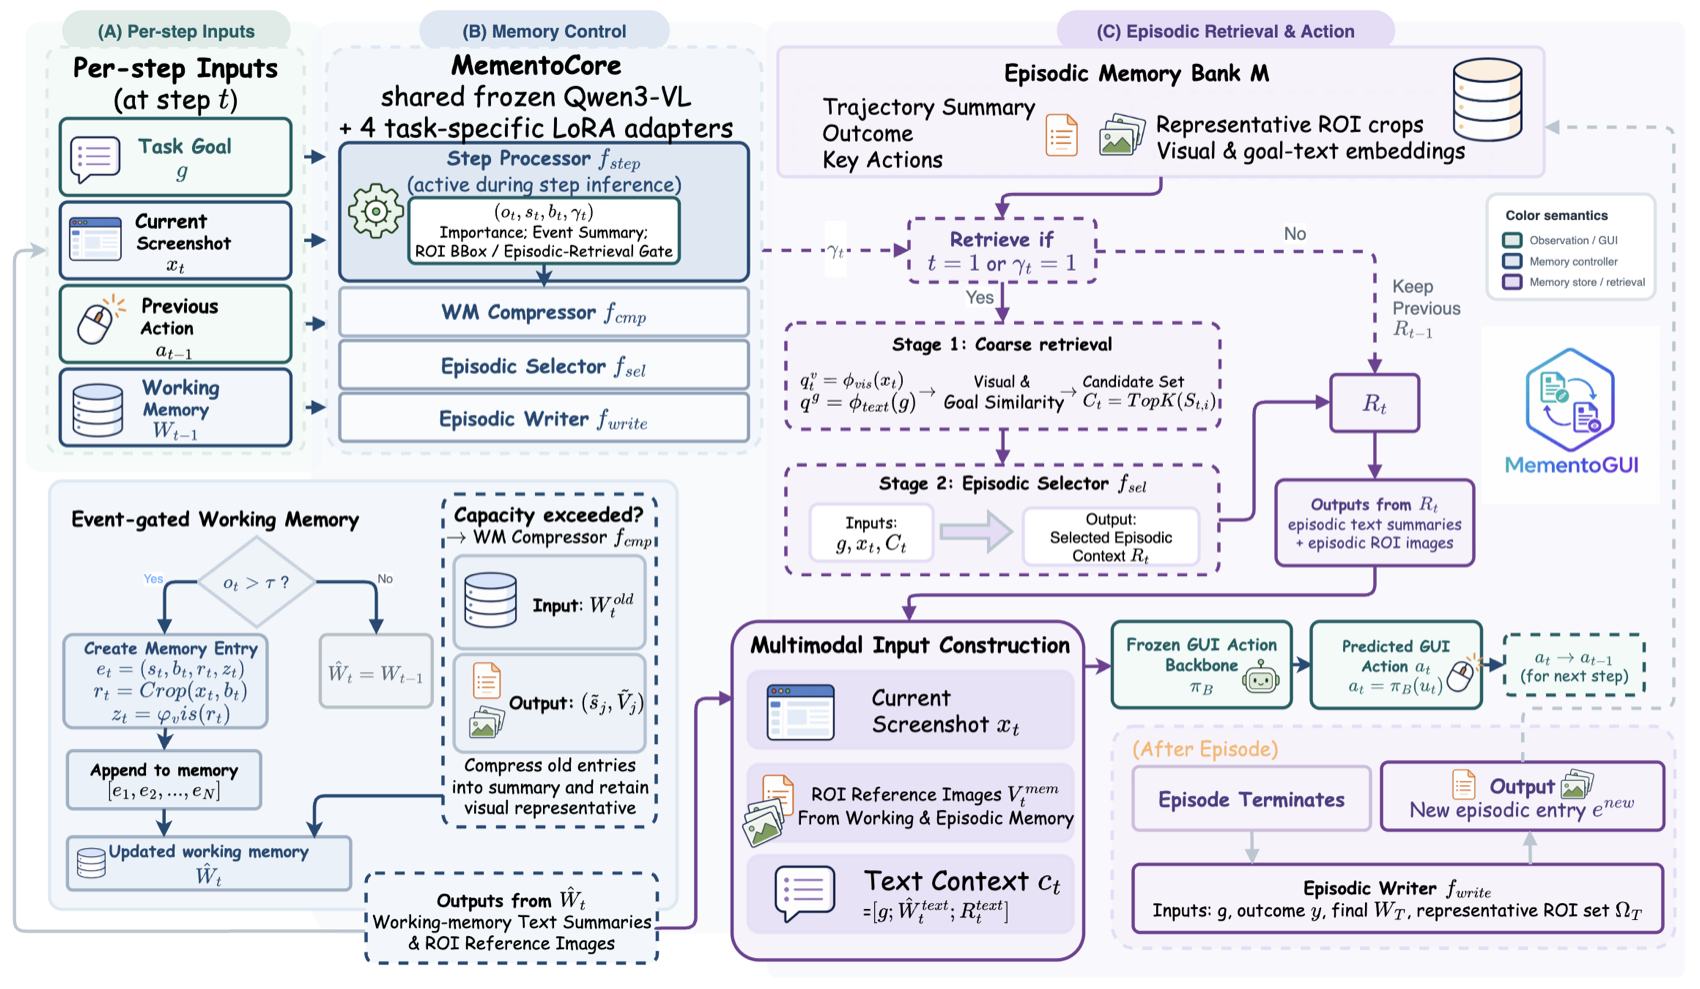
图源:MementoGUI 论文(来源:2026, arXiv:2605.18652)
关键结果:作为即插即用模块增强现有 GUI Agent,在长程任务上显著提升状态维持能力。
与本章关系:直接对应本章「工作记忆」「情景记忆」和「多模态记忆」知识点,展示了记忆系统如何从纯文本向界面视觉证据和长期操作轨迹扩展。
MemIR:类型化记忆中间表示——消除长期 Agent 溯源角色崩溃(2026)
🧬 一句话:长期记忆存为扁平文本致"溯源角色崩溃",MemIR 用类型化原子单元严格分离原始证据/检索线索/断言,事实授权仅限有支撑断言。
核心问题:长期记忆是持久 LLM Agent 的必需,但主流架构把历史交互存为无结构扁平文本,引发溯源角色崩溃(source-monitoring errors)——Agent 无法区分原始证据、检索线索和有证可循的真实断言。
方法介绍:MemIR 提出类型化记忆中间表示(typed memory IR),把 source monitoring 操作化为结构约束——把长期记忆写成接地的原子单元,严格分离原始证据原子、检索提示原子、断言原子,事实授权仅限于有支撑的断言原子;再用多路由原子投影和溯源域利用,把异构检索结果转化为以断言为中心的候选束。现有方法 vs MemIR 对比见下图:
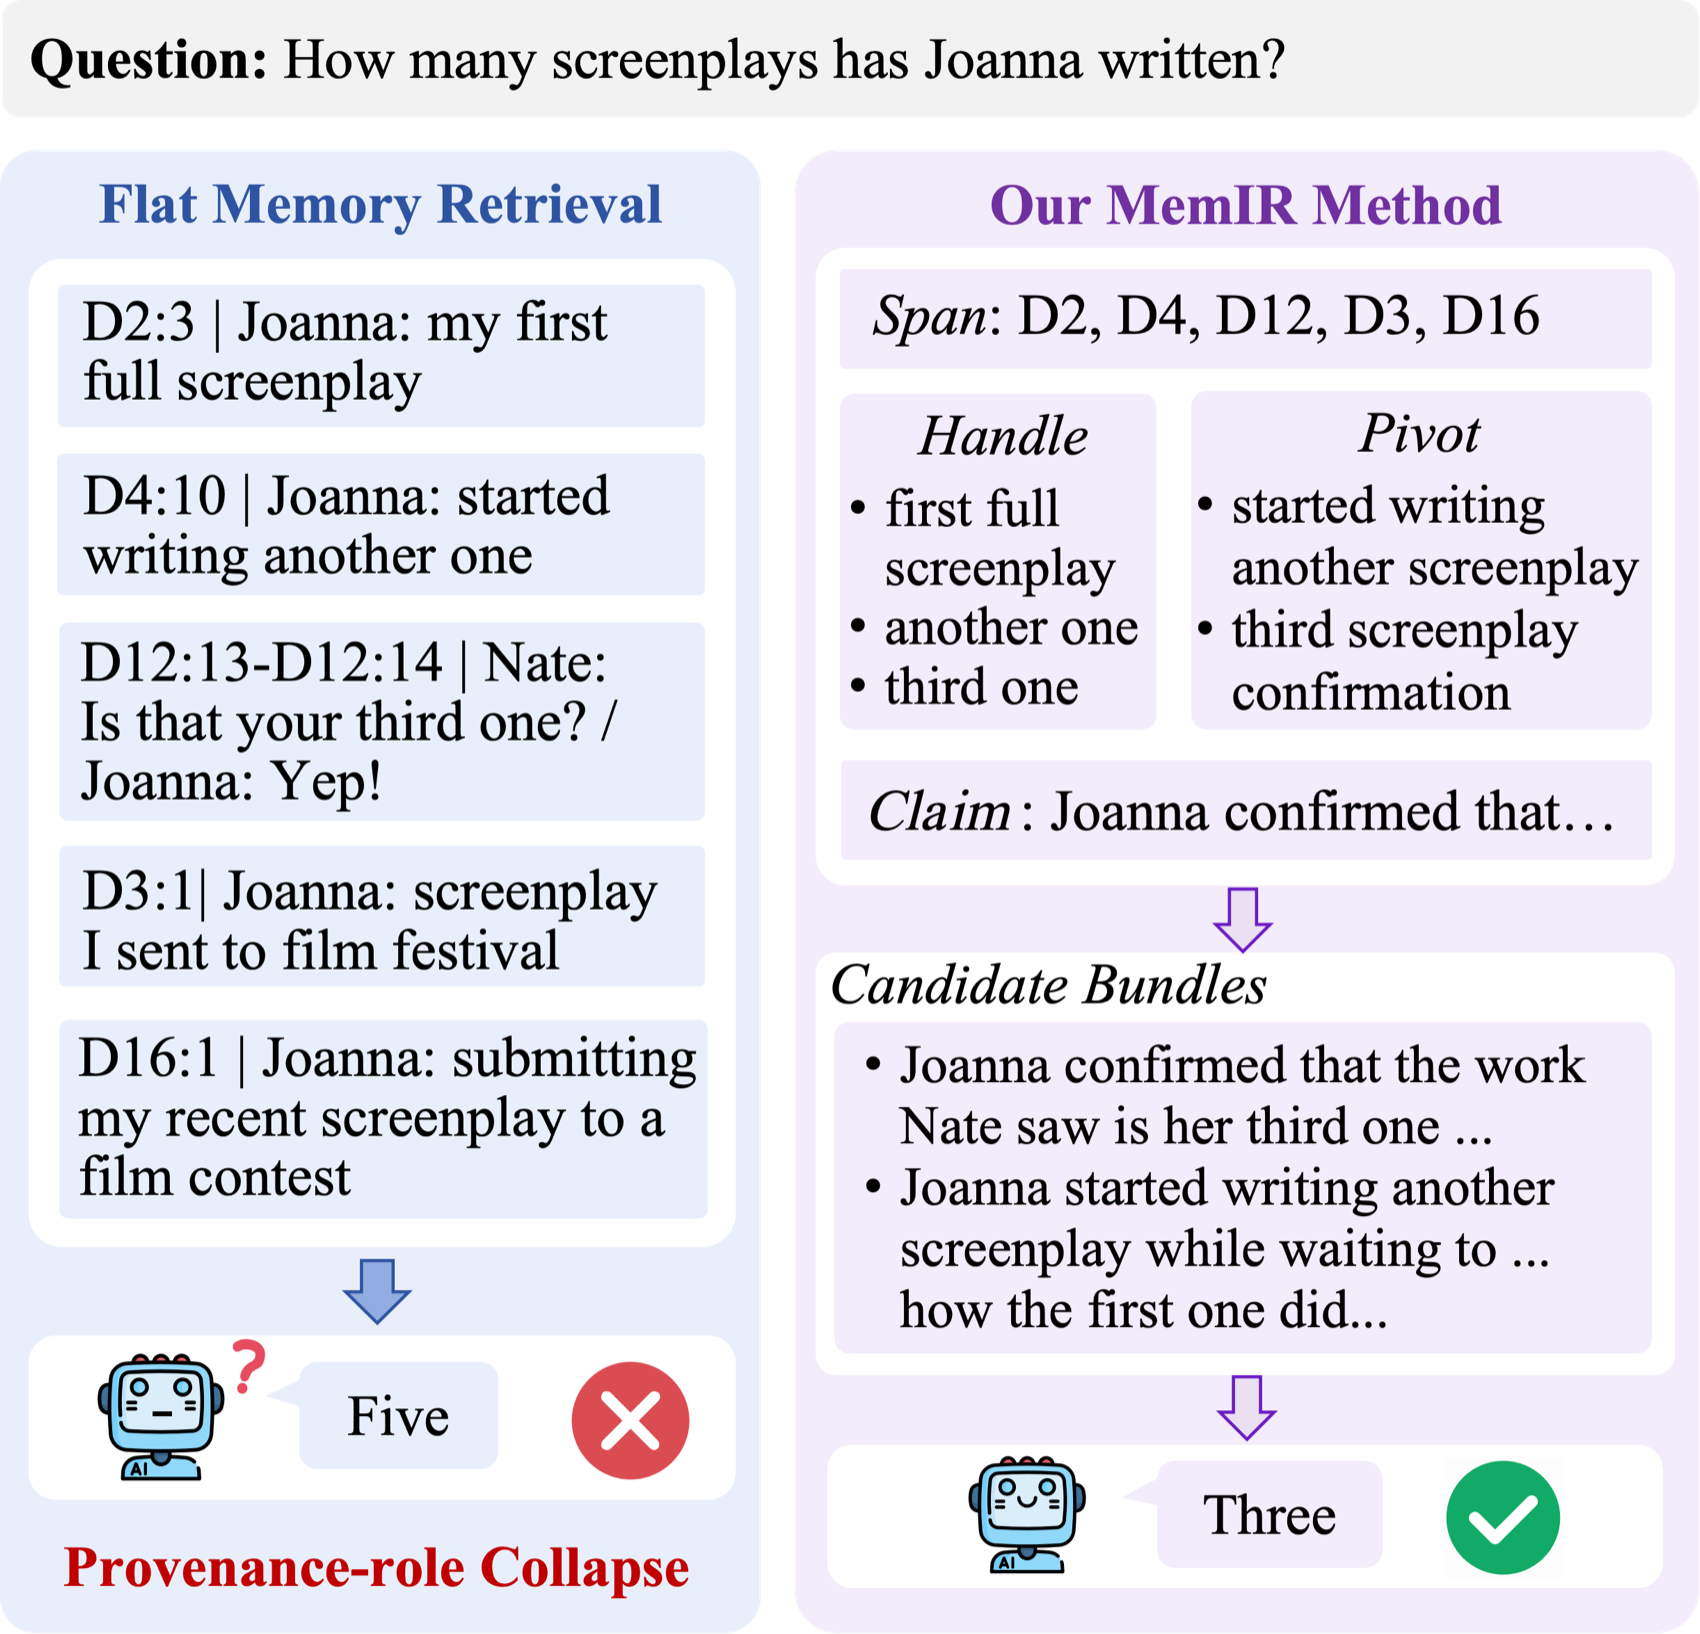
图源:MemIR 论文(来源:2026, arXiv:2605.25869)
关键结果:在 LoCoMo 和 BEAM-100K 上,尤其在需溯源追踪、时序定位和碎片化证据整合的任务中一致超越现有记忆基线。
与本章关系:对应本章 4.3 节"记忆的组织与检索",是对长期记忆结构化存储问题的深层诊断与修复,揭示了无结构记忆导致的认知失效模式及其类型化解决方案。
SE-GA:记忆增强自进化 GUI Agent 框架(2026)
🧬 一句话:TTME 推理时动态检索情节/语义/经验三类记忆,MASE 训练管线用 TTME 数据反哺基础策略,形成记忆→训练自进化闭环。
核心问题:自主 GUI Agent 常因受限上下文窗口和无法适应动态环境的静态策略在多步任务上挣扎。
方法介绍:SE-GA(Self-Evolving GUI Agent)集成层次记忆结构与迭代自改进机制——**TTME(Test-Time Memory Extension)**动态检索情节、语义、经验三类记忆支持长期规划;MASE 训练管线把 TTME 收集的数据用于稳定和增强基础策略,形成记忆→训练的持续自进化闭环。框架概览见下图:
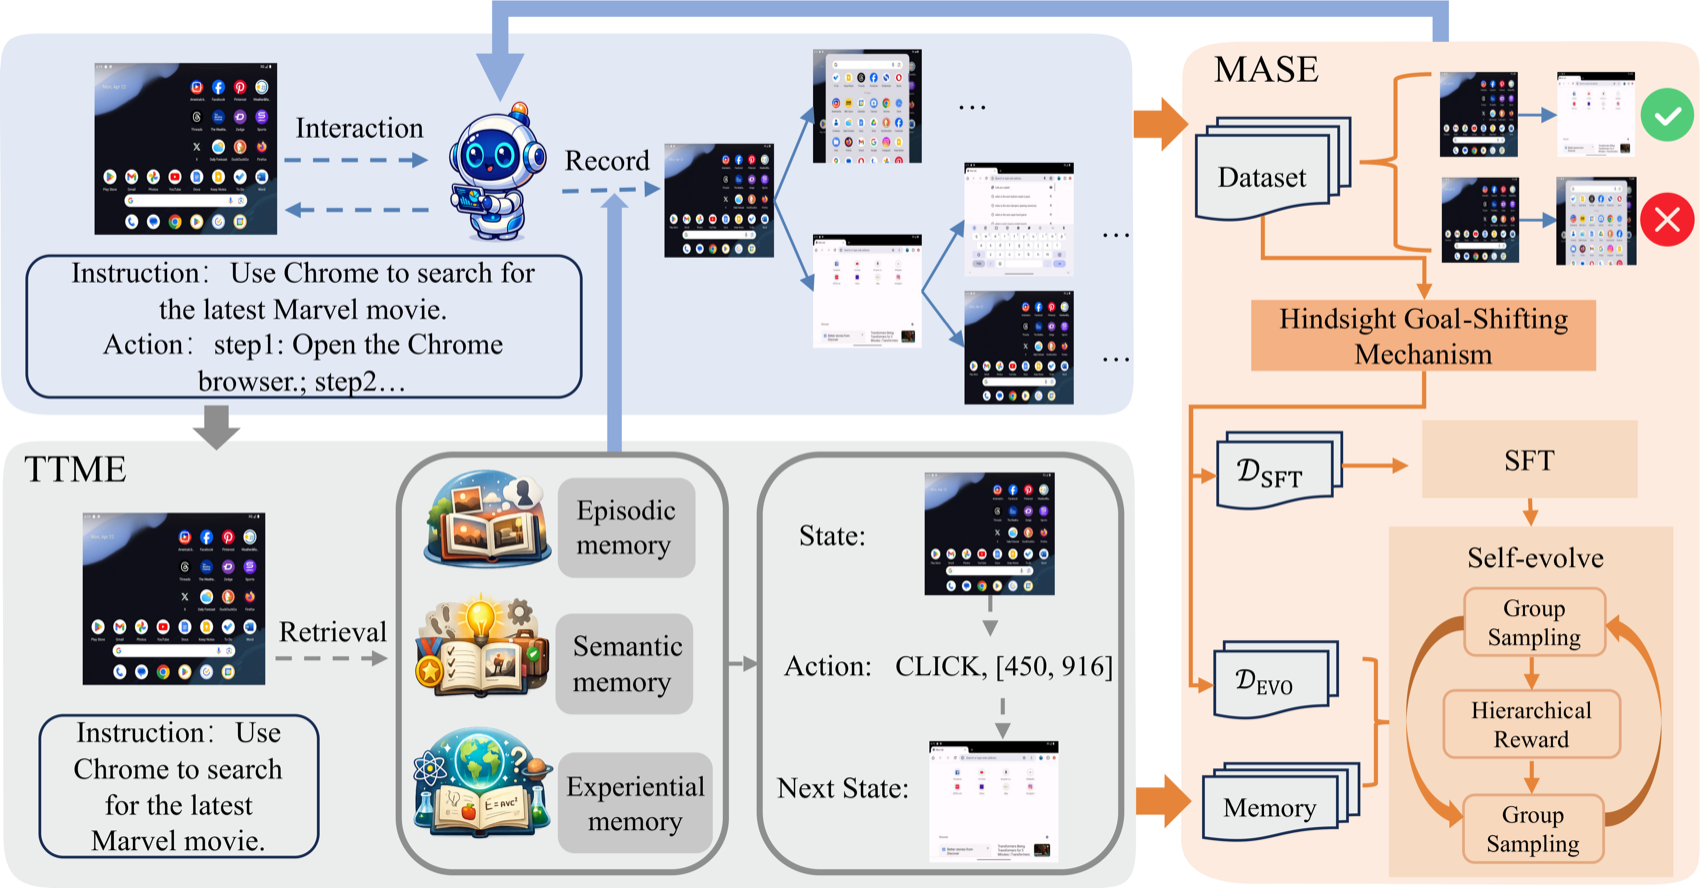
图源:SE-GA 论文(来源:2026, arXiv:2605.16883,天津大学&上海交大,ICML 2026)
关键结果:ScreenSpot 达 89.0%、AndroidControl-High 达 75.8%,AndroidWorld 超越所有已知基线。
与本章关系:直接对应本章「情节记忆」「语义记忆」和「记忆驱动的在线学习」知识点,是将三类记忆统一组织、与训练管线双向耦合的最新 ICML 旗舰成果,展示了记忆系统如何从被动检索升级为主动自进化的核心驱动力。
TOKI:LLM Agent 持久化记忆中矛盾解决的双时间算子代数(2026)
🧬 一句话:把矛盾解决形式化为写时并发控制,用双时间操作符族给严格隔离前置条件,是唯一同时排除重放不一致/信念漂移/审计擦除的方案。
核心问题:LLM Agent 持久化记忆是写密集型系统——每次信念更新产生版本化写入,新声明可能与旧声明矛盾。生产系统常用的四种矛盾解决启发式(最后写入获胜、证据加权合并、等待确认、按规则策略)均未明确隔离级别。
方法介绍:TOKI 把矛盾解决形式化为写时并发控制,通过双时间(bitemporal)操作符族提供严格的隔离前置条件,并用出处注释把失败事实保留在审计行中。理论证明键控日志记录是重放一致性的必要条件。矛盾解决机制见下图:
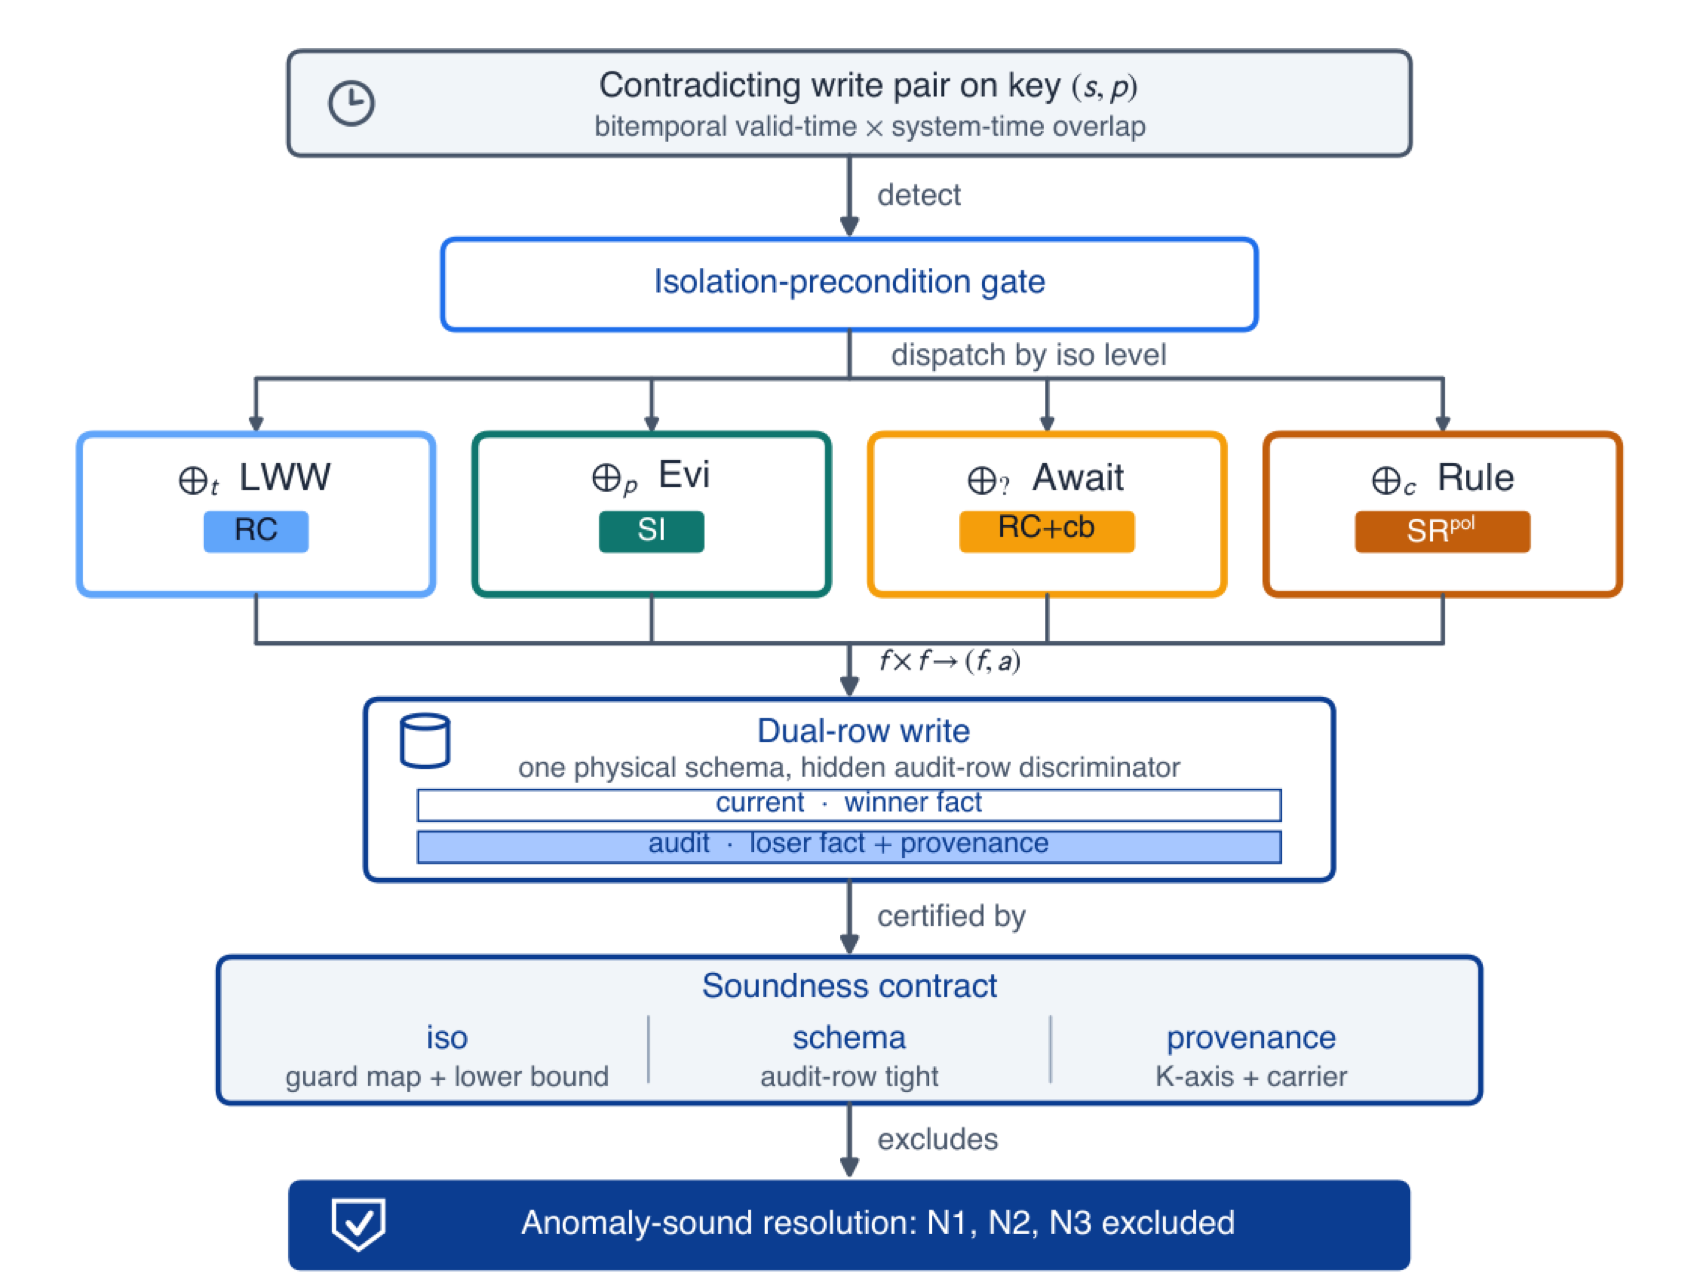
图源:TOKI 论文(来源:2026, arXiv:2606.06240)
关键结果:审计行防御把 LoCoMo 提升 0.86 分,TOKI 是唯一同时排除重放不一致、信念漂移偏差和审计擦除三类异常的方案。
与本章关系:对应本章「记忆的组织与检索」和「长期记忆一致性」知识点,从并发控制角度为持久化记忆的矛盾解决提供了首个完整的形式化理论框架。
MRAgent:记忆是重建,不是检索——LLM Agent 的图记忆框架(2026)
🧬 一句话:Cue-Tag-Content 三层关联图+主动重建机制把 LLM 推理嵌入记忆访问,迭代探索剪枝检索路径,超基线 23%。
核心问题:LLM Agent 在长交互历史上推理仍困难。当前记忆增强 Agent 依赖静态"先检索再推理"管线,这种刚性管道设计使其无法在推理中根据中间证据动态调整记忆访问路径。
方法介绍:MRAgent 把记忆表示为 Cue–Tag–Content 图——关联标签作语义桥梁连接细粒度触发点(Cue)与记忆内容(Content)。其主动重建机制把 LLM 推理直接嵌入记忆访问过程,Agent 迭代探索并剪枝检索路径,基于累积证据动态决定哪些记忆相关,同时用图结构约束扩展范围避免组合爆炸。系统架构见下图:
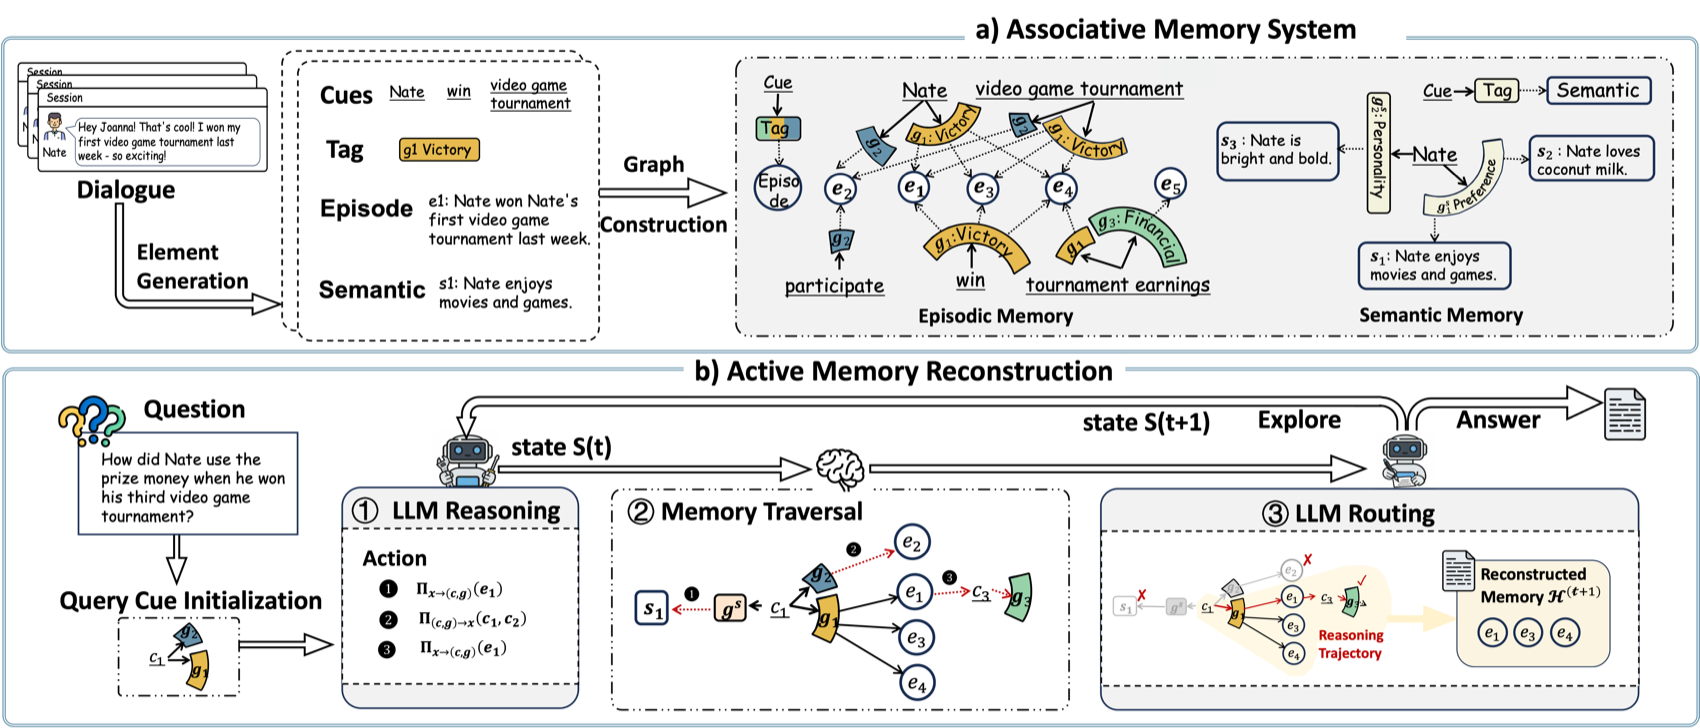
图源:MRAgent 论文(来源:2026, arXiv:2606.06036,ICML 2026)
关键结果:在 LoCoMo 和 LongMemEval 上超越强基线高达 23%,同时降低 token 与运行时成本。
与本章关系:对应本章「情节记忆」与「记忆的组织与检索」知识点,从范式层面挑战了现有"检索-推理"分离架构,是将 LLM 推理与记忆访问深度融合的最新 ICML 旗舰成果。
用户即代码:面向个性化 Agent 的可执行记忆架构(2026)
🧬 一句话:把用户记忆存为可执行 Python 代码(状态=类型对象、规则=函数),聚合类问题检索型崩溃 6-43% 而 UaC 达 99%。
核心问题:个性化 AI Agent 需要用户模型——跨多次对话累积、每次新对话 consulted。如今这记忆几乎总存为非结构化文本、知识图谱或扁平事实库,用"取最相似条目"consulted。这种"事实袋"能 recall 单个事实,但因"存事实"与"用事实"是分离两步,难解矛盾、聚合多记录或执行逻辑规则。
方法介绍:本文论证用户记忆应是可编程的。提出 UaC(User as Code)范式——把用户记忆存为可执行 Python 代码:用户状态以有类型 Python 对象表示,规则以函数编码,从而把"表示用户"和"对用户推理"统一为解释器可运行的同一介质。两阶段管线:追加日志(永不丢事实)→ 周期性结构化为类型代码。六个记忆系统基准对比见下图:
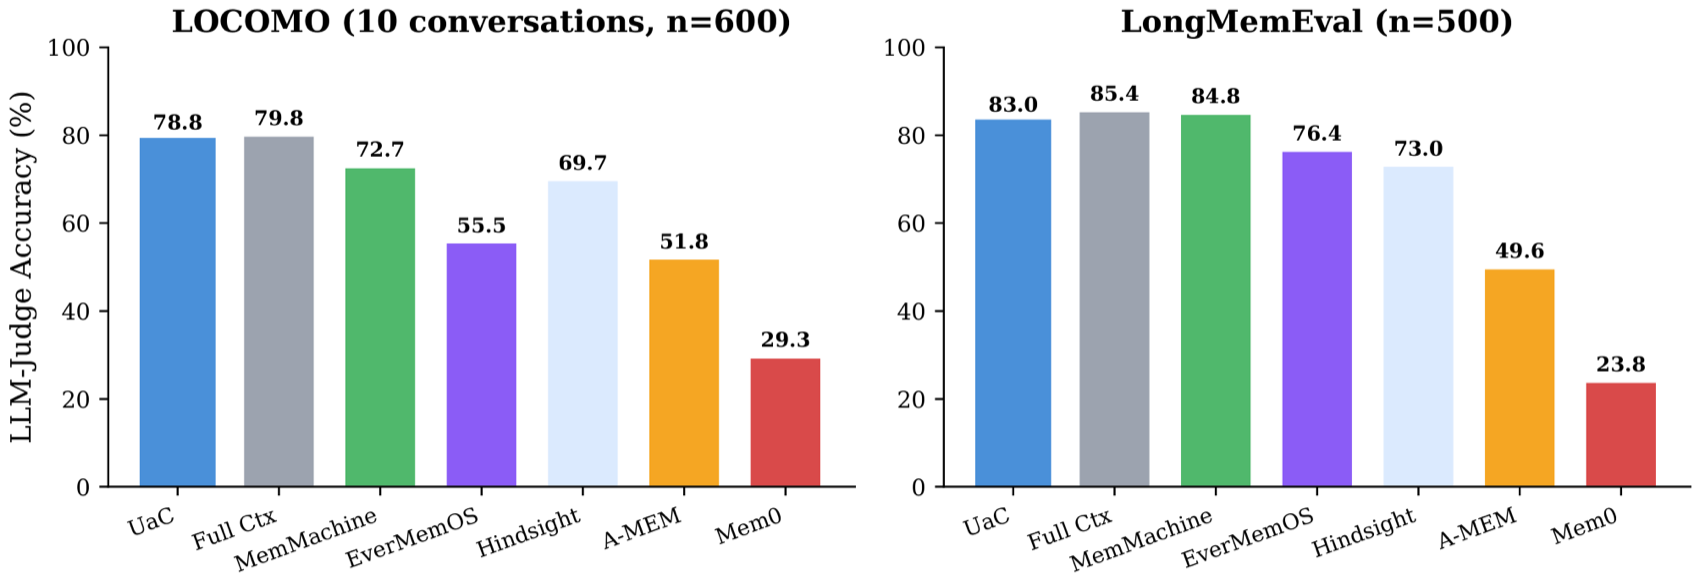
图源:UaC 论文(来源:2026, arXiv:2606.16707)
关键结果:聚合类问题(如"去年出了几次国?")检索型记忆崩溃(6–43%),而 UaC 接近满分(99%)——因答案只是对类型化状态的一行计算;还能在状态变更时主动触发安全关键提醒(如药物-过敏冲突)。
与本章关系:对应本章「结构化记忆」与「记忆的组织与检索」知识点,将记忆范式从"文本相似度检索"提升到"程序化状态计算",是记忆系统从"存事实"到"可执行推理"的重要范式跳跃。
Infini Memory:面向长期 LLM Agent 的可维护主题文档记忆(2026)
🧬 一句话:以主题结构化文档为记忆单元,新观测暂存缓冲+周期整合,推理时 Agent 迭代工具调用逐步读取,MemoryAgentBench 64.7%。
核心问题:长期 LLM Agent 需跨会话追踪变化事实并提供相关证据的持久记忆。现有系统把观测存为孤立记录、摘要或索引片段,使证据聚合、事实修订和记忆维护都困难。
方法介绍:Infini Memory 是可维护的文本持久记忆架构,把 agent 记忆视为主题结构化文档——每个主题文档作语义单元,收集相关证据、保留元数据并随时间修订事实;新观测先暂存缓冲区,再周期性整合为连贯文本上下文;推理时通过 Agent 迭代工具调用逐步读取记忆而非一次性检索。混合检索变体见下图:
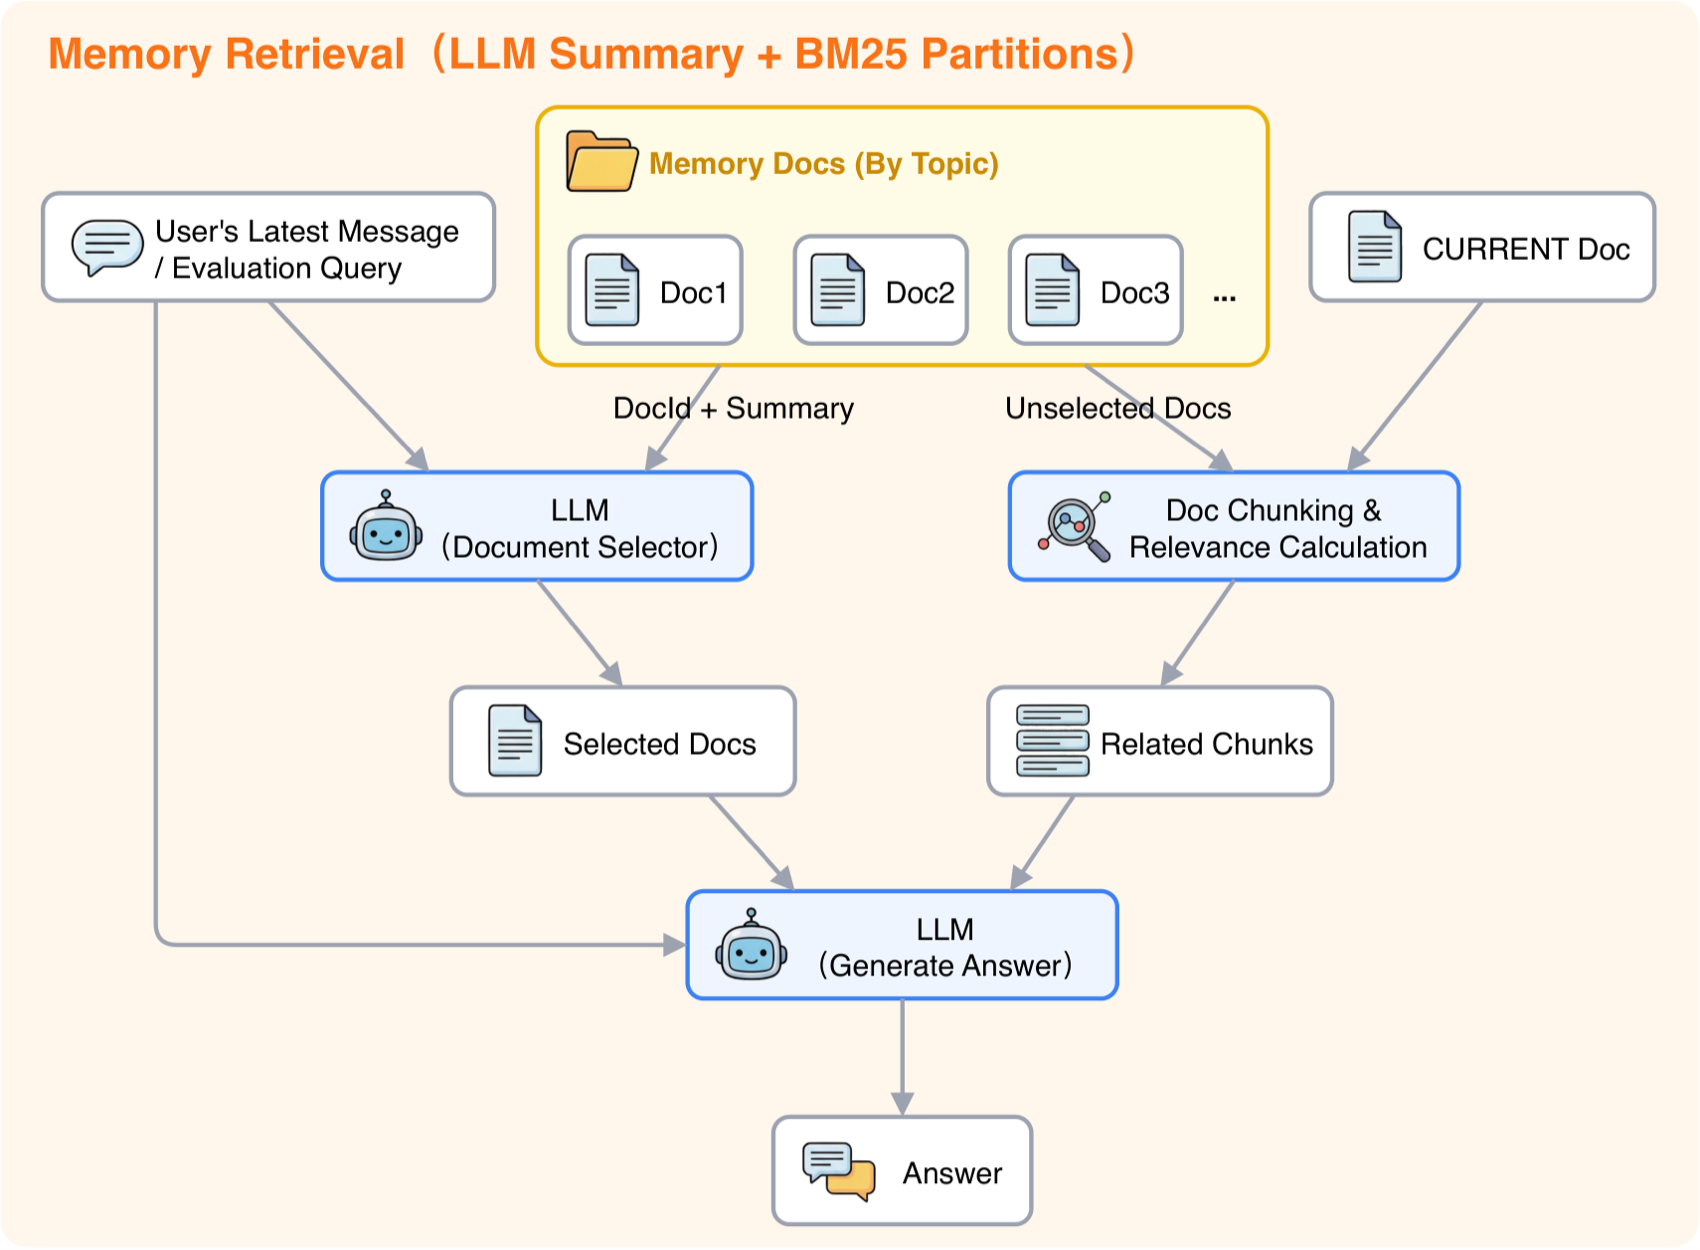
图源:Infini Memory 论文(来源:2026, arXiv:2606.10677)
关键结果:在 MemoryAgentBench 上取得 64.7% 总分,消融表明主题结构化维护与迭代证据检查互补。
与本章关系:对应本章「长期记忆维护」与「情节记忆」知识点,提供了继"向量数据库检索"之后的第三种路线——主题文档迭代维护,解决了跨会话事实修订和证据聚合这两个长期记忆的核心工程难题。
RaMem:基于上下文复原的长期 Agentic 记忆框架(2026)
🧬 一句话:诊断"上下文坍塌"——压缩后记忆失去判断适用性的外围情境,用四阶段(证据锚定→条件推断→有效性检索→上下文保留合成)复原,F1 +10%。
核心问题:长期记忆对持久 LLM Agent 至关重要。近期系统让过去经验更持久、紧凑、可检索,但检索 alone 不保证记忆为当前查询提供有效证据。当经验被压缩为可复用片段,来自不同情境的记忆可能因实体或用户状态重合而显得同样"相关"——这被称为上下文坍塌(context collapse):记忆失去了判断其是否适用于当前查询所需的外围情境。
方法介绍:RaMem 是四阶段框架:①证据锚定把每条记忆的原始情节条件(事件时间、提及时间、会话跨度、参与者)显式内嵌;②召回条件推断从查询派生必要证据条件;③有效性感知检索用条件优先筛选上下文相容记忆,保留内容相关记忆作备选;④上下文保留合成在生成阶段维持记忆的结构化上下文。框架概览见下图:
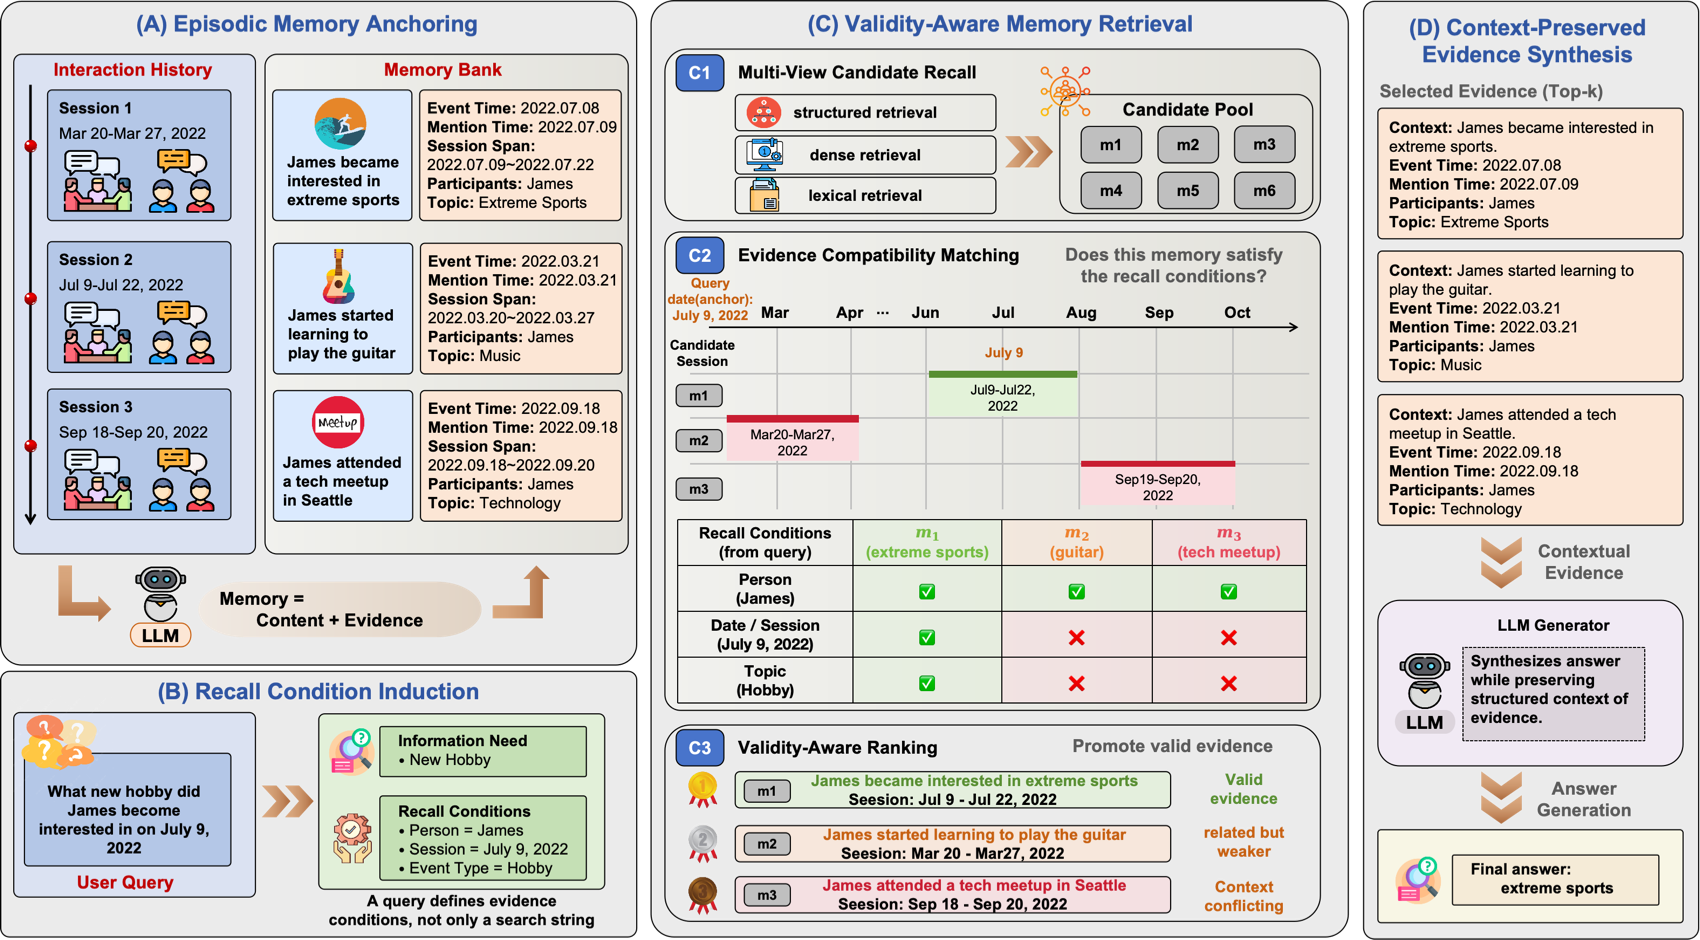
图源:RaMem 论文(来源:2026, arXiv:2606.22844)
关键结果:在长期记忆基准上,相比强基线平均 F1 提升超过 10%。
与本章关系:对应本章「记忆检索」与「情节记忆」知识点,直接解决了向量检索框架中的"相似不等于适用"问题,引入了情节锚定这一核心概念,是长期 Agent 记忆可靠性的最新系统性提升。
AutoMem:将记忆管理作为认知技能自动化学习(2026)
发表:2026 年 7 月 1 日 | arXiv:2607.01224
🧬 一句话:把文件系统操作提升为一等记忆动作,双闭环(外审查 + 内学习)自动改进记忆结构,32B 开源模型三游戏性能提升 2–4×。
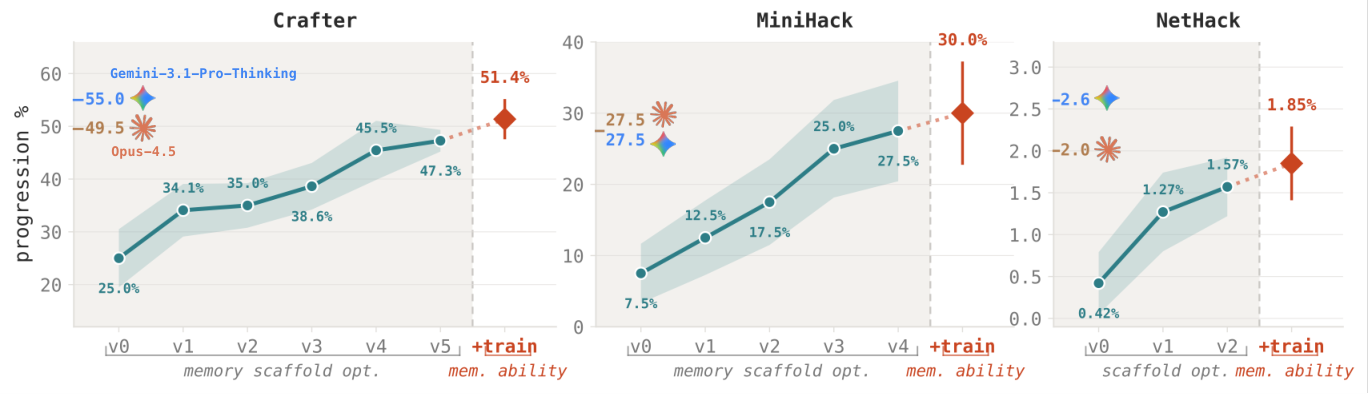
图源:AutoMem:将记忆管理作为认知技能自动化学习 论文(来源:2026, arXiv:2607.01224)
核心贡献:AutoMem 把文件系统操作提升为与任务动作并列的一等记忆动作,让模型自主决定何时写入、检索和组织记忆文件。系统包含两个迭代闭环:外循环由强模型审查完整 Agent 轨迹并反复改进记忆结构(提示词、文件模式、动作词汇表);内循环从海量情节中识别模型自身的优质记忆决策,以此为训练信号直接提升记忆熟练度。在三个程序生成的长时程游戏(Crafter、MiniHack、NetHack)上,仅优化记忆能力就让 32B 开源模型性能提升 2×–4×,达到 Claude Opus 4.5 和 Gemini 3.1 Pro Thinking 的竞争水平。
与本章关系:直接对应本章「记忆的写入与更新」和「长期记忆管理」知识点,首次证明记忆管理是可独立学习、高杠杆的认知技能,是 MemGPT 之后将记忆操作内化为模型能力的重要突破。
A-TMA:长期 Agent 记忆中的状态感知记忆失效解耦(2026)
发表:2026 年 7 月 2 日 | arXiv:2607.01935
🧬 一句话:解决「幽灵记忆」(旧/当前/过渡事实混存),状态感知叠加层显式暴露时态标签,冲突准确率 +0.240。
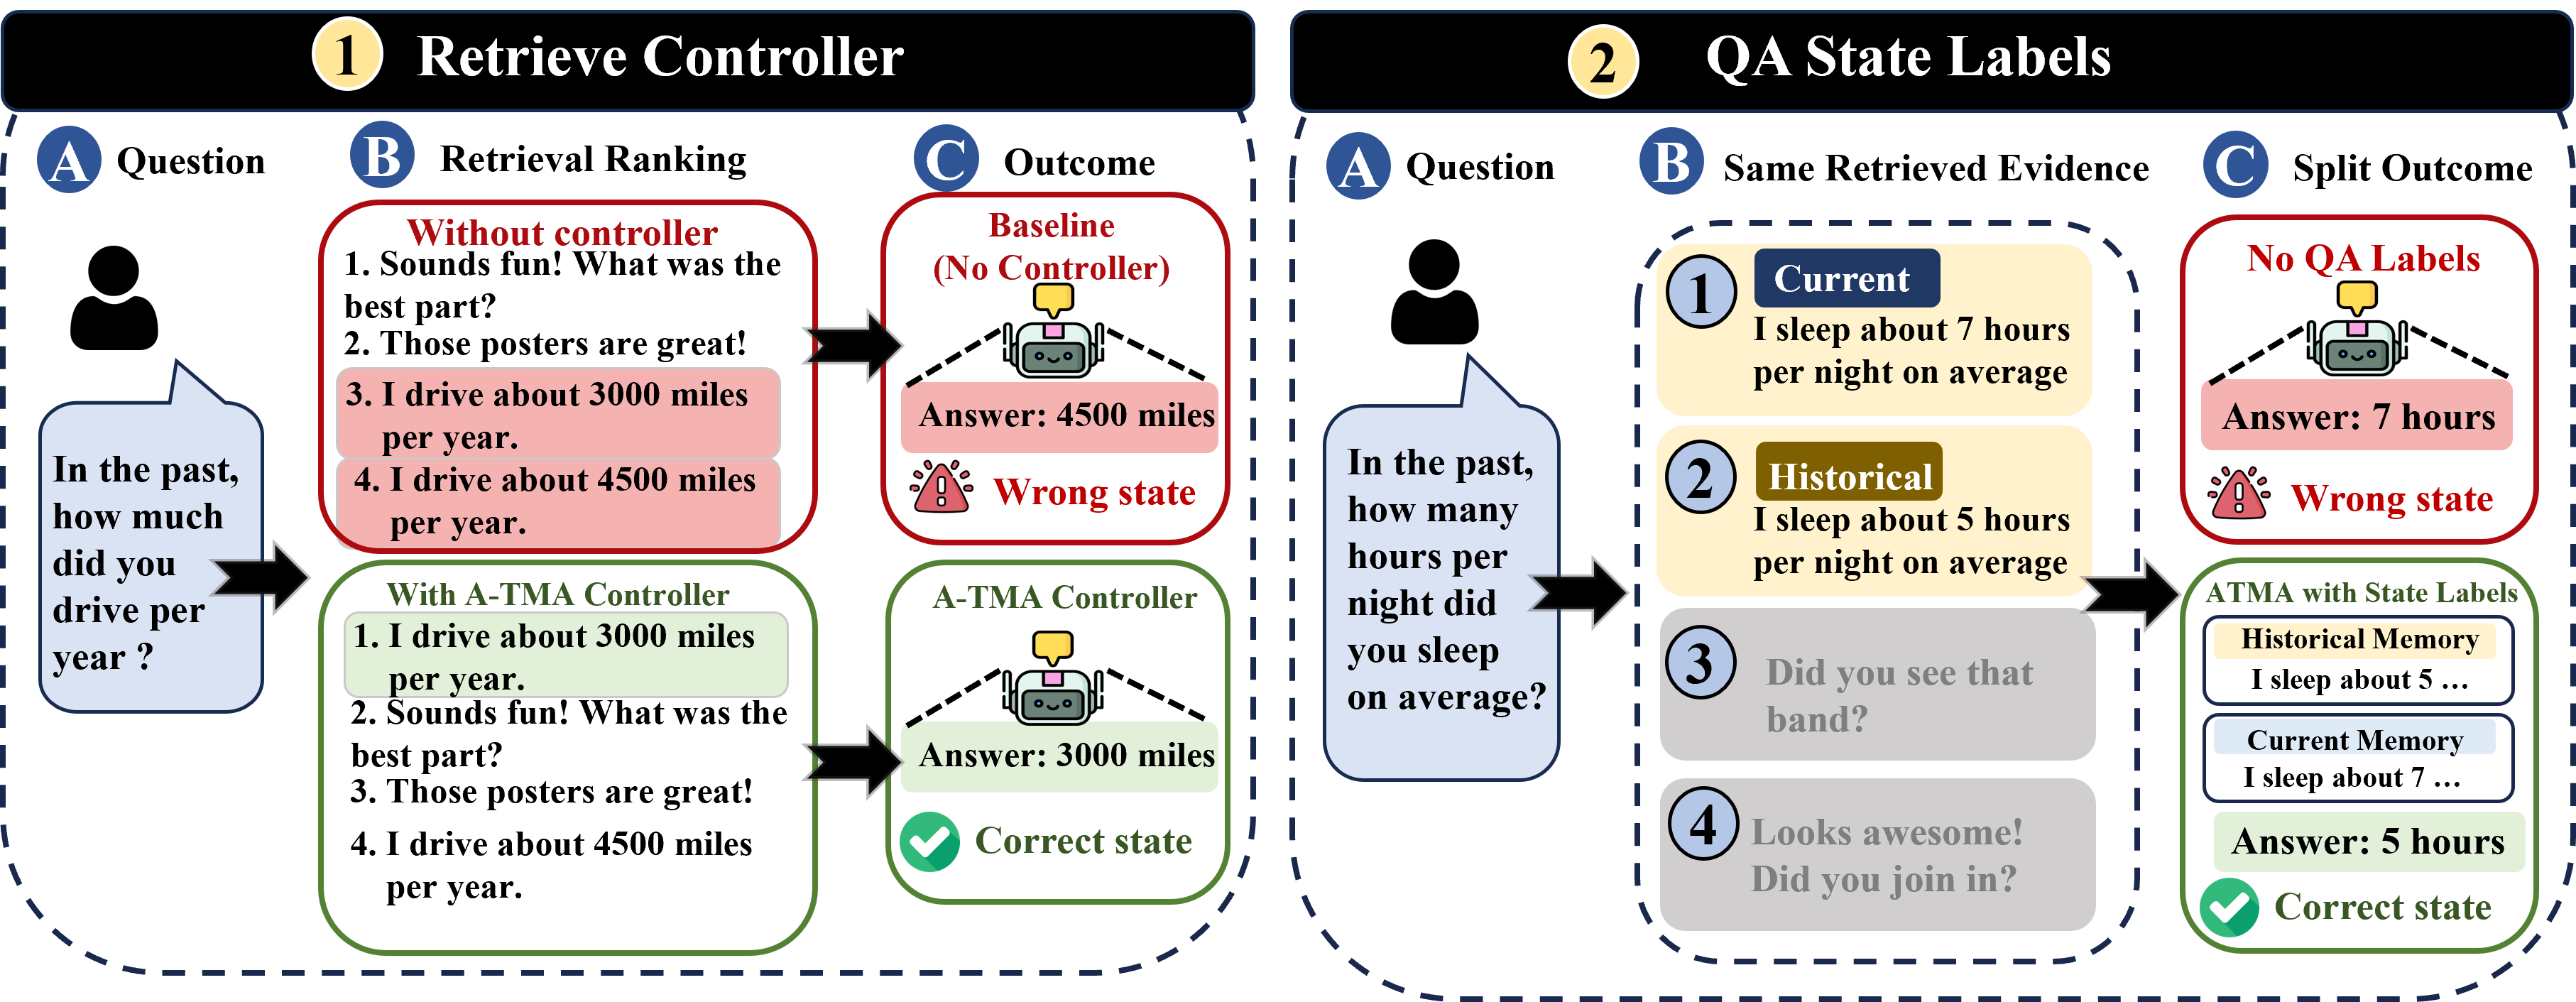
图源:A-TMA:长期 Agent 记忆的状态感知失效解耦 论文(来源:2026, arXiv:2607.01935)
核心贡献:本文定义并系统研究了"幽灵记忆(Ghost Memory)"问题——旧事实、当前事实与过渡事实在记忆库中混存,检索时无法区分时态状态,导致 QA 模型给出误导性回答。A-TMA 提出状态感知叠加层:在检索时为查询构建"证据包"并显式暴露当前/历史/过渡三种标签,同时建立分层评估方法,将记忆库维护、检索、回答时刻的失效各自解耦测量。在新建的冲突稠密基准 LTP 上,Graphiti+ATMA 的冲突准确率相比 Graphiti 绝对提升 0.240,时态 F1 从 0.0295 提升至 0.1705。
与本章关系:直接对应本章「长期记忆维护」与「情节记忆」知识点,揭示了向量检索系统普遍存在但被最终准确率掩盖的状态协调失效问题,是继 RaMem(上下文坍塌)之后对长期记忆可靠性的又一系统性诊断与修复。
Remember When It Matters:面向长时程 Agent 的主动记忆干预机制(2026)
发表:2026 年 7 月 9 日 | arXiv:2607.08716
🧬 一句话:主动记忆干预:独立记忆 Agent 在关键时刻注入提醒而非被动检索,Terminal-Bench +8.3pp、τ2-Bench +6.8pp。
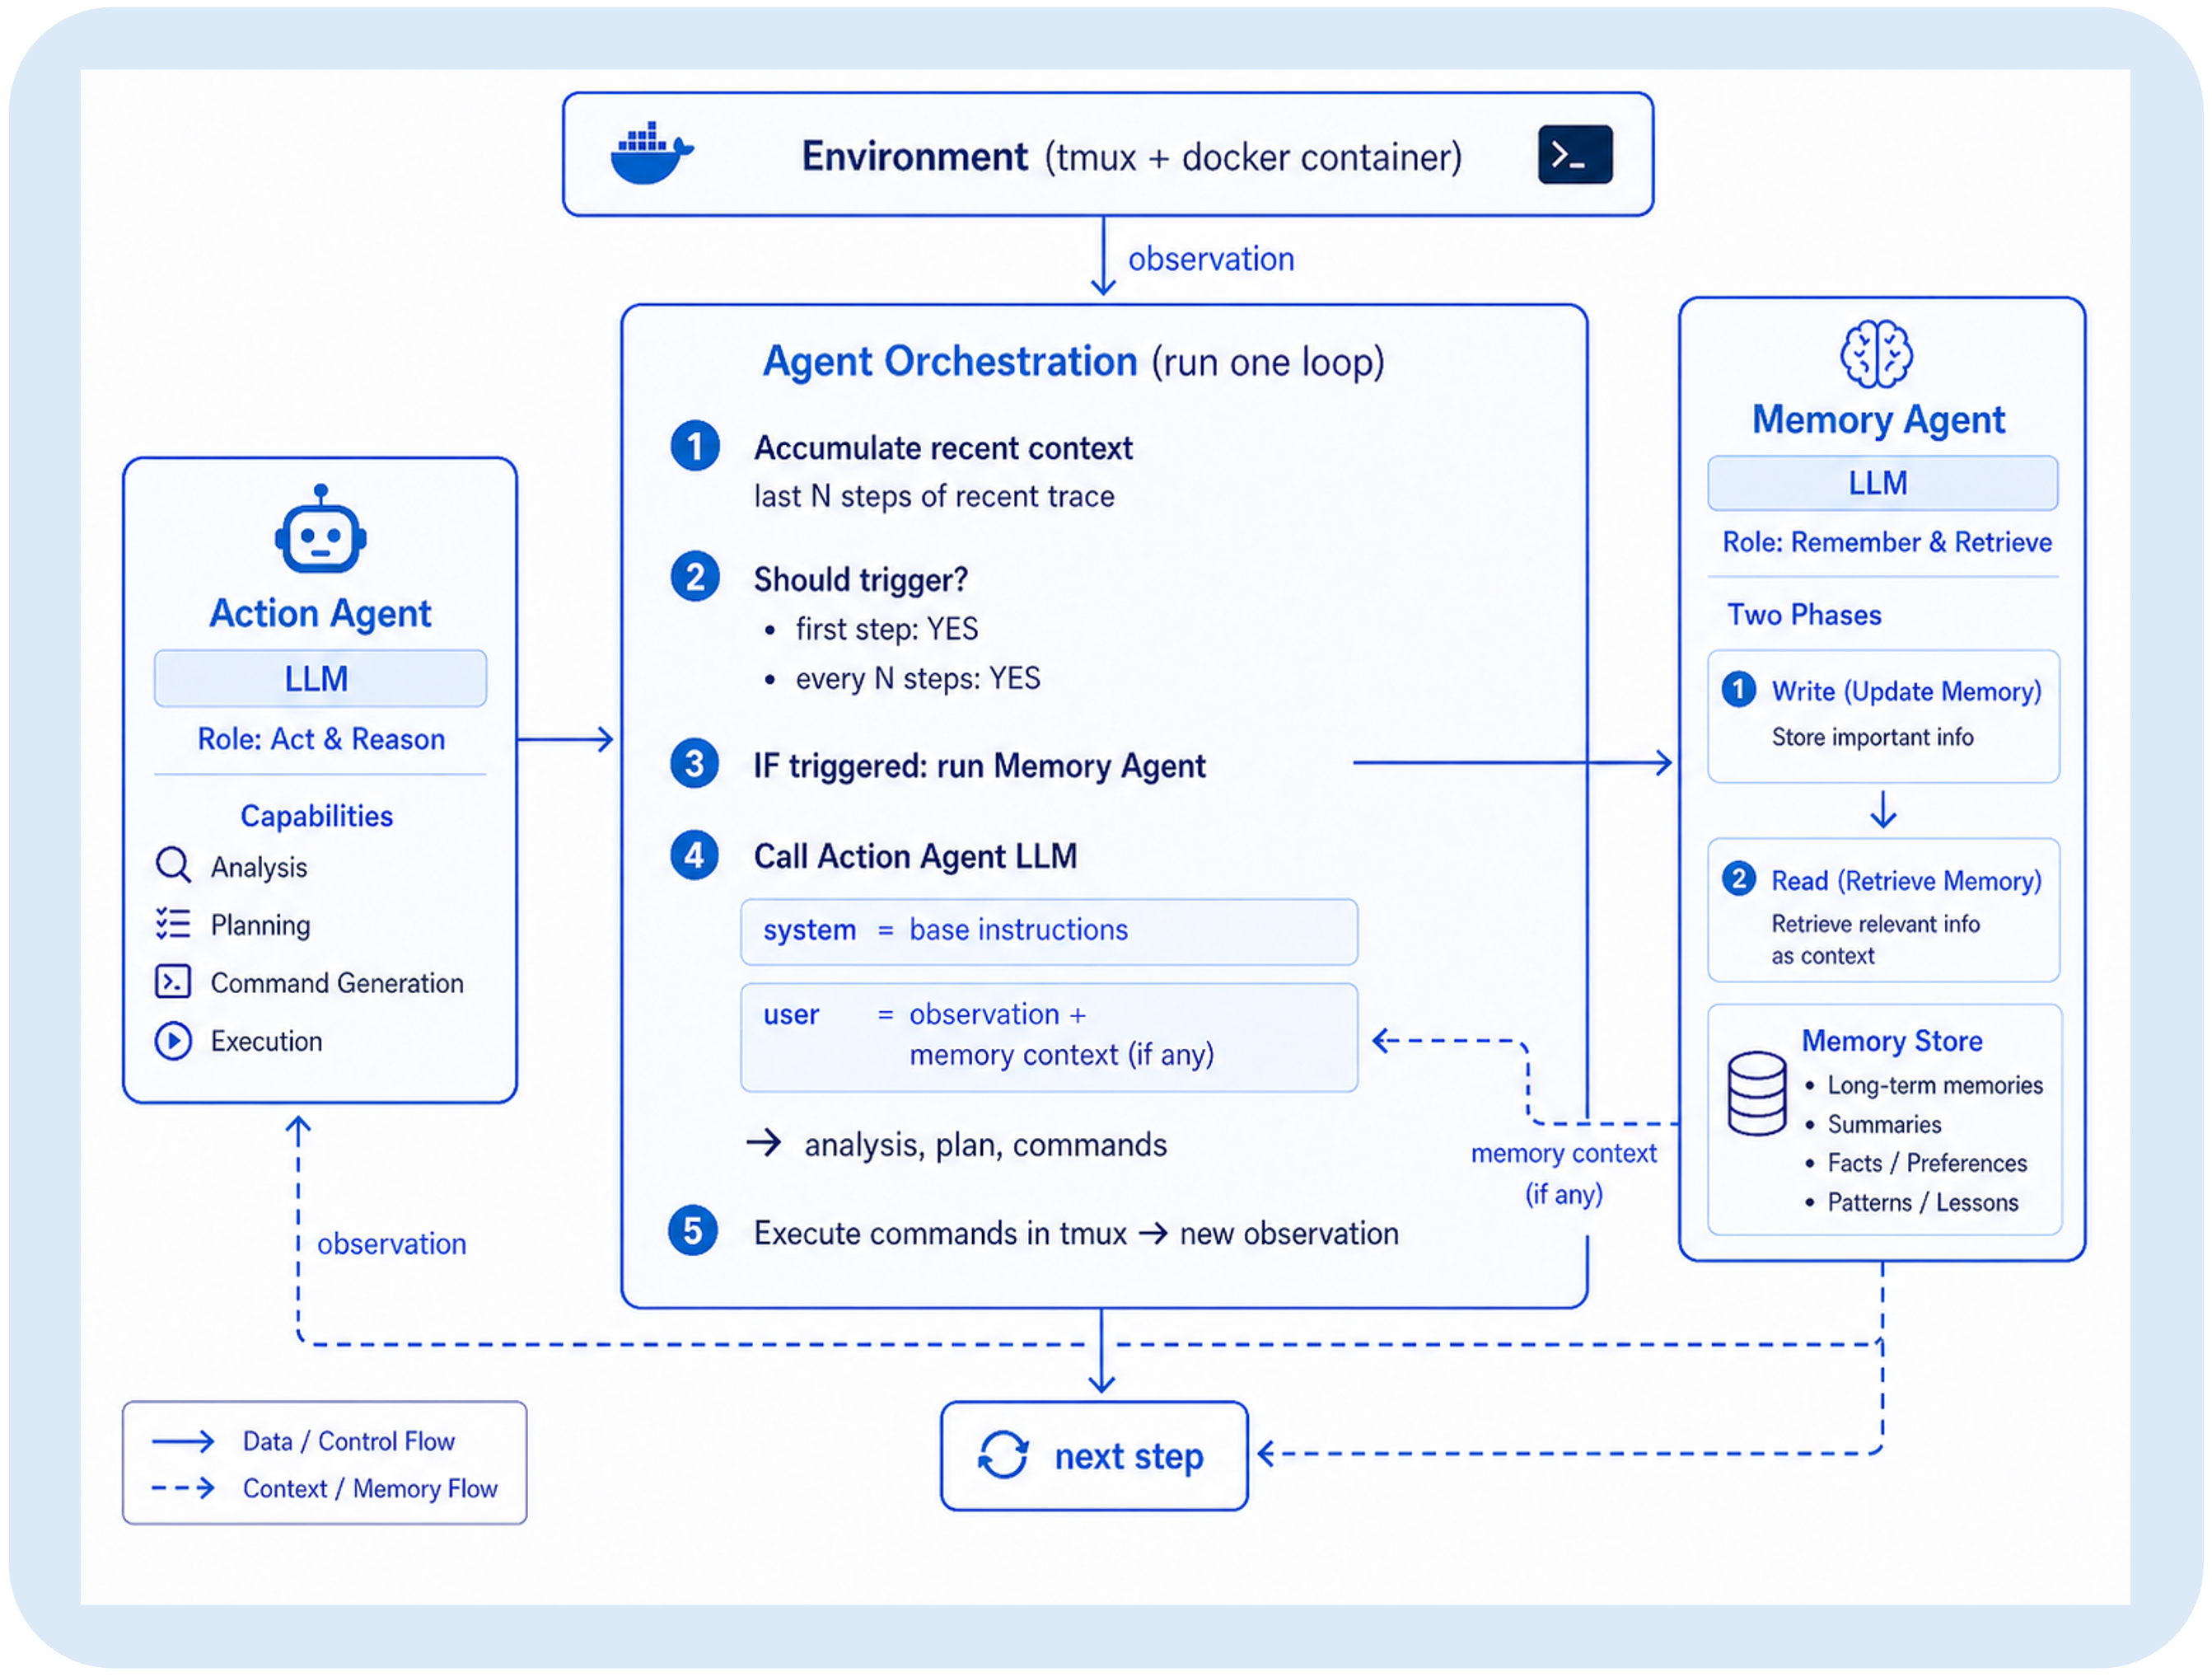
图源:Remember When It Matters:主动记忆干预 论文(来源:2026, arXiv:2607.08716)
核心贡献:本文定义并研究"行为状态衰减(Behavioral State Decay)"问题——长时程任务中,决策相关状态散布在不断增长的轨迹中,任务需求、环境事实、先前尝试和未完成子目标会被埋没或推出上下文窗口,导致在需要时无法影响决策。提出主动记忆 Agent:一个独立于动作 Agent 的记忆模块,从近期轨迹更新结构化记忆库,并决定是否注入记忆驱动的提醒或保持沉默。该模块即插即用,无需修改动作 Agent。在 Terminal-Bench 2.0 和 τ2-Bench 上分别提升 pass@1 +8.3pp 和 +6.8pp。消融实验证明选择性干预优于被动记忆库暴露、持续注入和通用检索。进一步用 SFT+GRPO 训练 Qwen3.5-27B 记忆策略,实现部分迁移。
与本章关系:直接对应本章「记忆的检索与使用」与「长期记忆管理」知识点,将记忆从"被动检索"升级为"主动干预"——记忆 Agent 独立于动作 Agent 运行、在关键时刻主动注入信息,是继 AutoMem(记忆作为技能)之后记忆架构分离设计方向的最新实证。
超认知模式 SCM:面向 Agent 记忆的路由架构(2026)
发表:2026 年 7 月 21 日 | arXiv:2607.19096
🧬 一句话:按查询类型路由到专用检索-合成路径(直接查询/关系推理/长史综合),三基准竞争性成绩,取代「一刀切」语义检索。
图源:超认知模式 SCM:面向 Agent 记忆的路由架构 论文(来源:2026, arXiv:2607.19096)
核心贡献:Agent 记忆负载天然混杂三类工作:直接事实查询、关系链/当前状态推理、长历史综合。SCM(Supra Cognitive Modes)架构将每个查询通过冻结的语义分类器和运行时门控路由到对应的检索-合成载荷,三条路径分别对应融合词法与稠密检索的直接查询、图或多跳迭代推理、分层长篇合成,底层共享多粒度嵌入 + 三元组提取 + 事实版本元数据的统一摄取基础设施。在 LoCoMo、MemoryAgentBench、LongMemEval 三个基准上,系统分别达到 84.87%(事实问答)、61.49%、86.00% 的竞争性成绩,每类查询均由专用路径处理而非统一检索。
与本章关系:对应本章「记忆的检索与使用」知识点,SCM 以显式路由取代"一刀切"语义检索,是继 AutoMem(记忆作为技能)、A-TMA(时态状态解耦)之后记忆架构精细化的最新方向,将记忆系统的认知工作负载分类问题转化为可工程化的路由决策。
PRO-LONG:以程序化记忆赋能长时程推理(2026)
发表:2026 年 7 月 22 日 | arXiv:2607.20064
🧬 一句话:程序化记忆 = 完整交互日志 + 代码搜索,无损记忆与精准检索并存,ARC-AGI-3 提升 18.0pp、token 少 4.2–5.8×。
核心贡献:长时程任务中,"保存更多信息"与"检索更精准"存在天然矛盾——全量保留使相关细节检索变难,压缩又损失关键状态。PRO-LONG 提出以程序化记忆作为 LLM Agent 的上下文管理基础:维护一份完整、结构化的交互日志,并借助代码 Agent 的代码执行能力高效搜索历史。该设计做到了"无损记忆"与"精准检索"并存:在完整 ARC-AGI-3 公开游戏集上,平均比基础代码 Agent 提升 18.0 个百分点,以 4.2–5.8× 更少 token 匹配或超越现有最优专用框架(pass@1 高达 76.1%);配合 Fable 5,best@2 达 97.4%,总成本仅 1750 美元。
与本章关系:直接对应本章「记忆的存储与检索」与「长期记忆管理」知识点,PRO-LONG 以"程序化索引"取代语义检索,将长期记忆的结构优势与代码搜索效率结合,是继 AutoMem(记忆作为技能)和主动记忆干预之后,长时程 Agent 记忆管理的最新架构突破。
在职学习:冻结权重 Agent 从部署反馈中持续学习(2026)
发表:2026 年 7 月 24 日 | arXiv:2607.22157
🧬 一句话:冻结权重 Agent 靠外部记忆把每次情节蒸馏为可检索规则,结果反馈 1.6×、纠错 2.6×,记忆可跨模型迁移。
图源:在职学习:冻结权重 Agent 的持续学习 论文(来源:2026, arXiv:2607.22157)
核心贡献:AI Agent 在每次运行中都会遇到学习机会,但由于模型在部署时权重冻结,今天解决的难题明天从零开始——这是当前生产 Agent 系统的通用痛点。本文证明,当冻结模型配以将每次情节蒸馏为可检索自然语言规则的外部记忆时,日常运行产生的反馈信号即足以支持持续学习。在 τ-bench 银行领域,从结果反馈(一位二进制判决)学习使单次成功率提升至基线的 1.6×,从错误修正学习则达 2.6×,解决了 84 个从未被基线解决的任务中的 22 个;结果在 Mistral Large(本地部署)与 Claude Sonnet 5 两个模型上可复现,且一个模型的记忆库迁移到另一个模型后,接收方仍高于自身无记忆基线,证明记忆的跨模型可迁移性。
与本章关系:直接对应本章「长期记忆的写入与更新」知识点,提出了一种无需微调的持续学习闭环——运行时外部记忆作为"可演化知识库",填补了 MemGPT/AutoMem 等框架在"从失败和修正中自动更新记忆"方向的空白,对数据主权敏感的生产部署场景(本地开源模型)尤具参考价值。
图原生双时态记忆存储:面向对话 AI Agent 的持久记忆架构(2026)
发表:2026 年 7 月 29 日 | arXiv:2607.26520
🧬 一句话:Neo4j 属性图 + 双时态数据模型(有效时间 + 事务时间),支持任意时间点检索而不物理覆盖历史。
图源:图原生双时态记忆存储 论文(来源:2026, arXiv:2607.26520)
核心贡献:对话 AI Agent 普遍缺乏跨会话持久记忆,全量注入聊天历史会耗尽上下文窗口,而依赖第三方记忆服务又带来数据隐私风险。本文提出基于 Neo4j 属性图 + HNSW 向量索引 + 完整双时态数据模型的 Agent 本地记忆存储:每条记忆以不可变身份节点 + 版本化内容节点保存,携带有效时间(事实在世界中为真的时间段)和事务时间(数据库记录该事实的时间段)两个时间区间,支持任意时间点的语义检索而不物理覆盖历史。语义边在写入时通过余弦相似度自动维护。在 LongMemEval(500 题)上,当前状态语义路径整体 R@10 达 46.7%,知识更新题达 80%;时间旅行路径在知识更新题同样达 80%,但在时序推理题上召回降低,指向具体设计改进方向。
与本章关系:直接对应本章「持久记忆存储」与「情节记忆」知识点,双时态模型将"有效时态"与"事务时态"解耦,在不物理删除旧记录的前提下支持历史回溯查询,是继 A-TMA(时态状态解耦)之后对 Agent 记忆时序一致性问题的最新工程实现,对需要长期记忆且无法依赖云端记忆服务的本地部署 Agent 具有直接参考价值。
基于文件系统的 LLM Agent 记忆:组织、演化与可持续性(2026)
发表:2026 年 7 月 30 日 | arXiv:2607.26637
🧬 一句话:系统研究文件系统记忆的完整生命周期(组织/演化/可持续),指出「主动清理合并」优于「无限追加」。
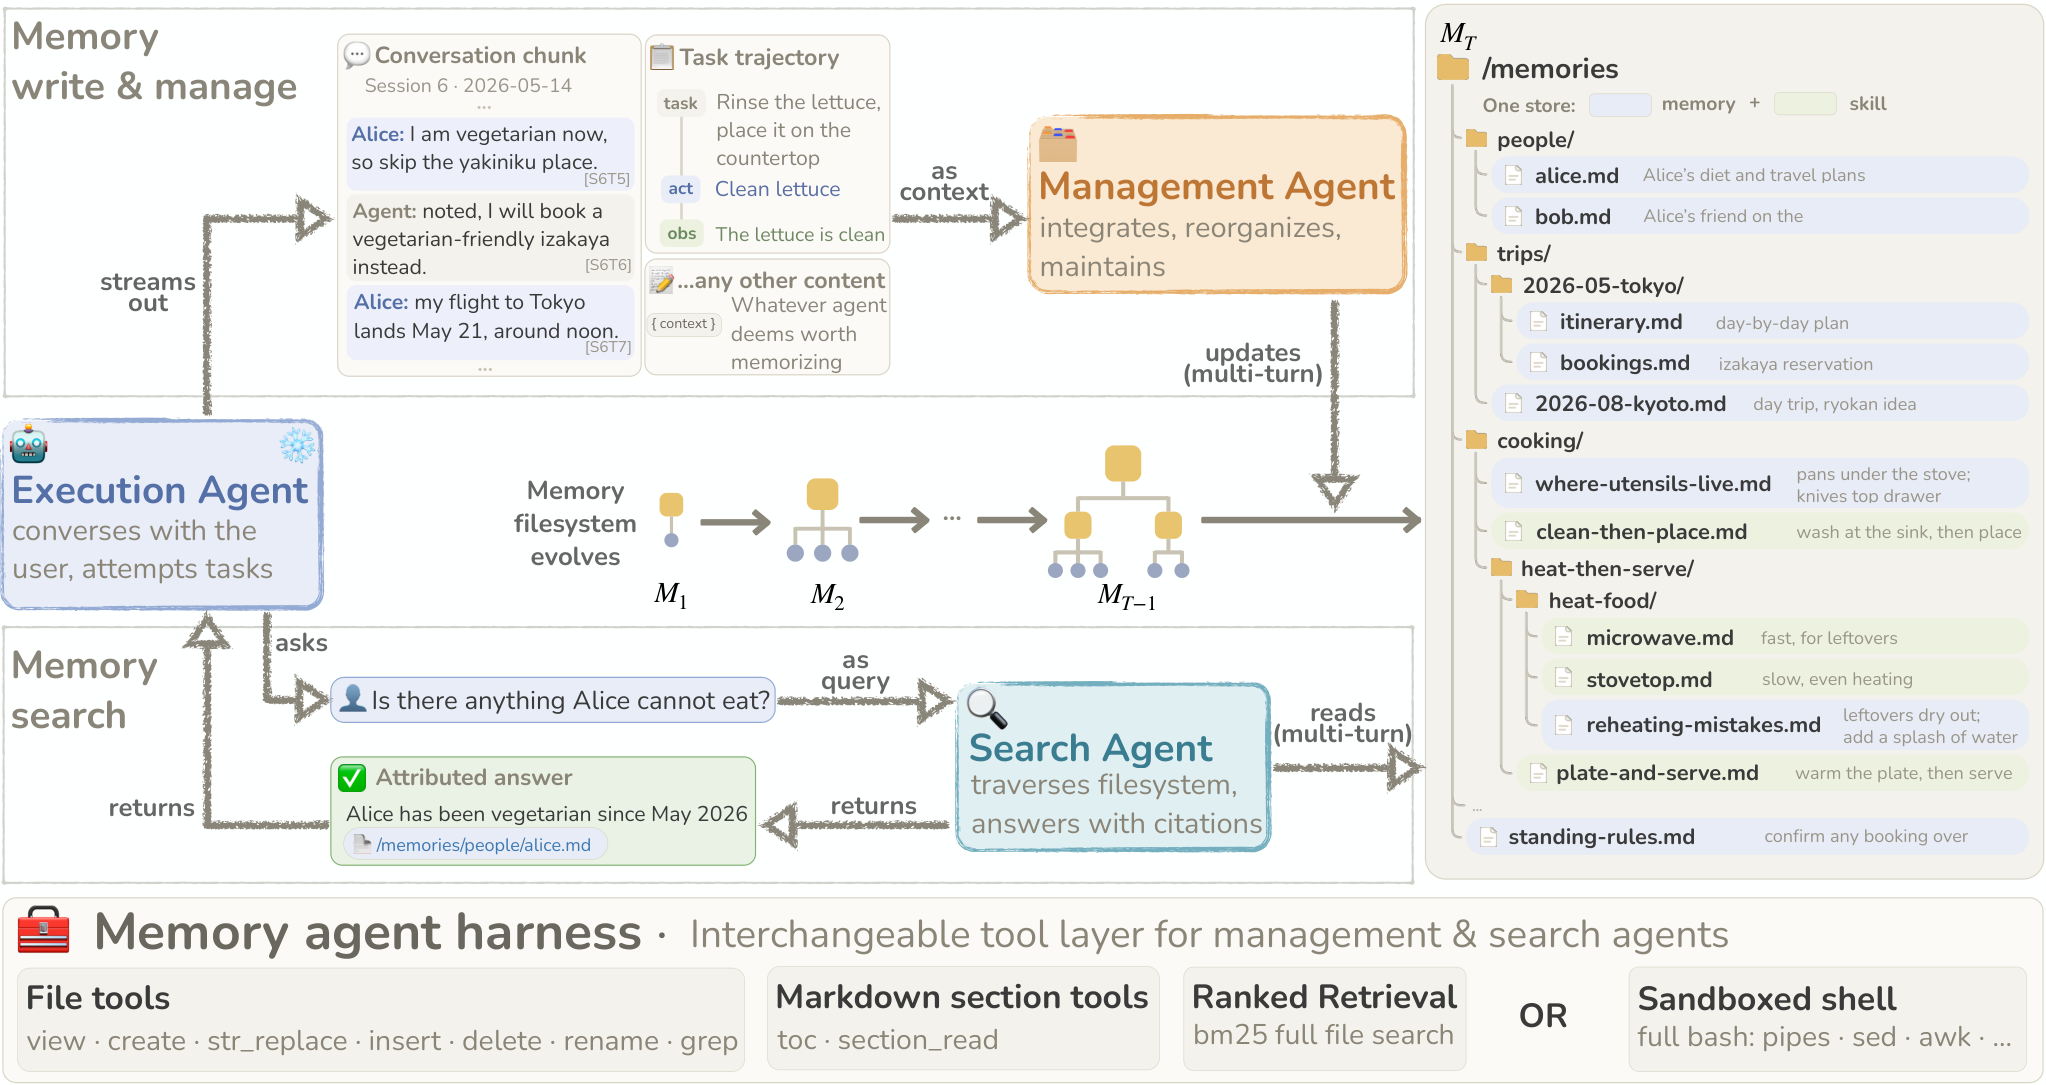
图源:基于文件系统的 LLM Agent 记忆 论文(来源:2026, arXiv:2607.26637)
核心贡献:本文系统研究了以文件系统作为 LLM Agent 长期记忆后端的完整生命周期——从初始存储组织方式,到记忆随任务演化的更新策略,再到超长时间运行后的可持续性挑战。论文指出记忆后端的选择会实质性影响系统的可审计性与成本:文件系统结构在可读性和可检索性之间存在基本张力;随着记忆体积增长,无结构扁平存储会导致检索退化,而过度层次化则增加导航开销;可持续性核心在于主动清理与合并过时记忆,而非无限追加。论文还分析了文件系统记忆在安全性(提示注入中间文件)和隐私(持久化敏感内容)方面的特殊风险,并提出最佳实践框架。
与本章关系:直接对应本章「记忆的存储结构」与「长期记忆管理」知识点,是继 PRO-LONG(程序化记忆索引)和 AutoMem(记忆作为技能)之后对文件系统原生记忆方案最系统的工程评估,为选型文件系统型记忆后端的 Agent 工程师提供了全面的架构参考。
Setoka:异构数据上个性化 Agent 分层用户理解基准(2026)
发表:2026 年 7 月 29 日 | arXiv:2607.27056
🧬 一句话:四层用户理解基准(语义/情节/行为/人格),揭示现有系统在行为模式与人格抽象上的系统性盲区。
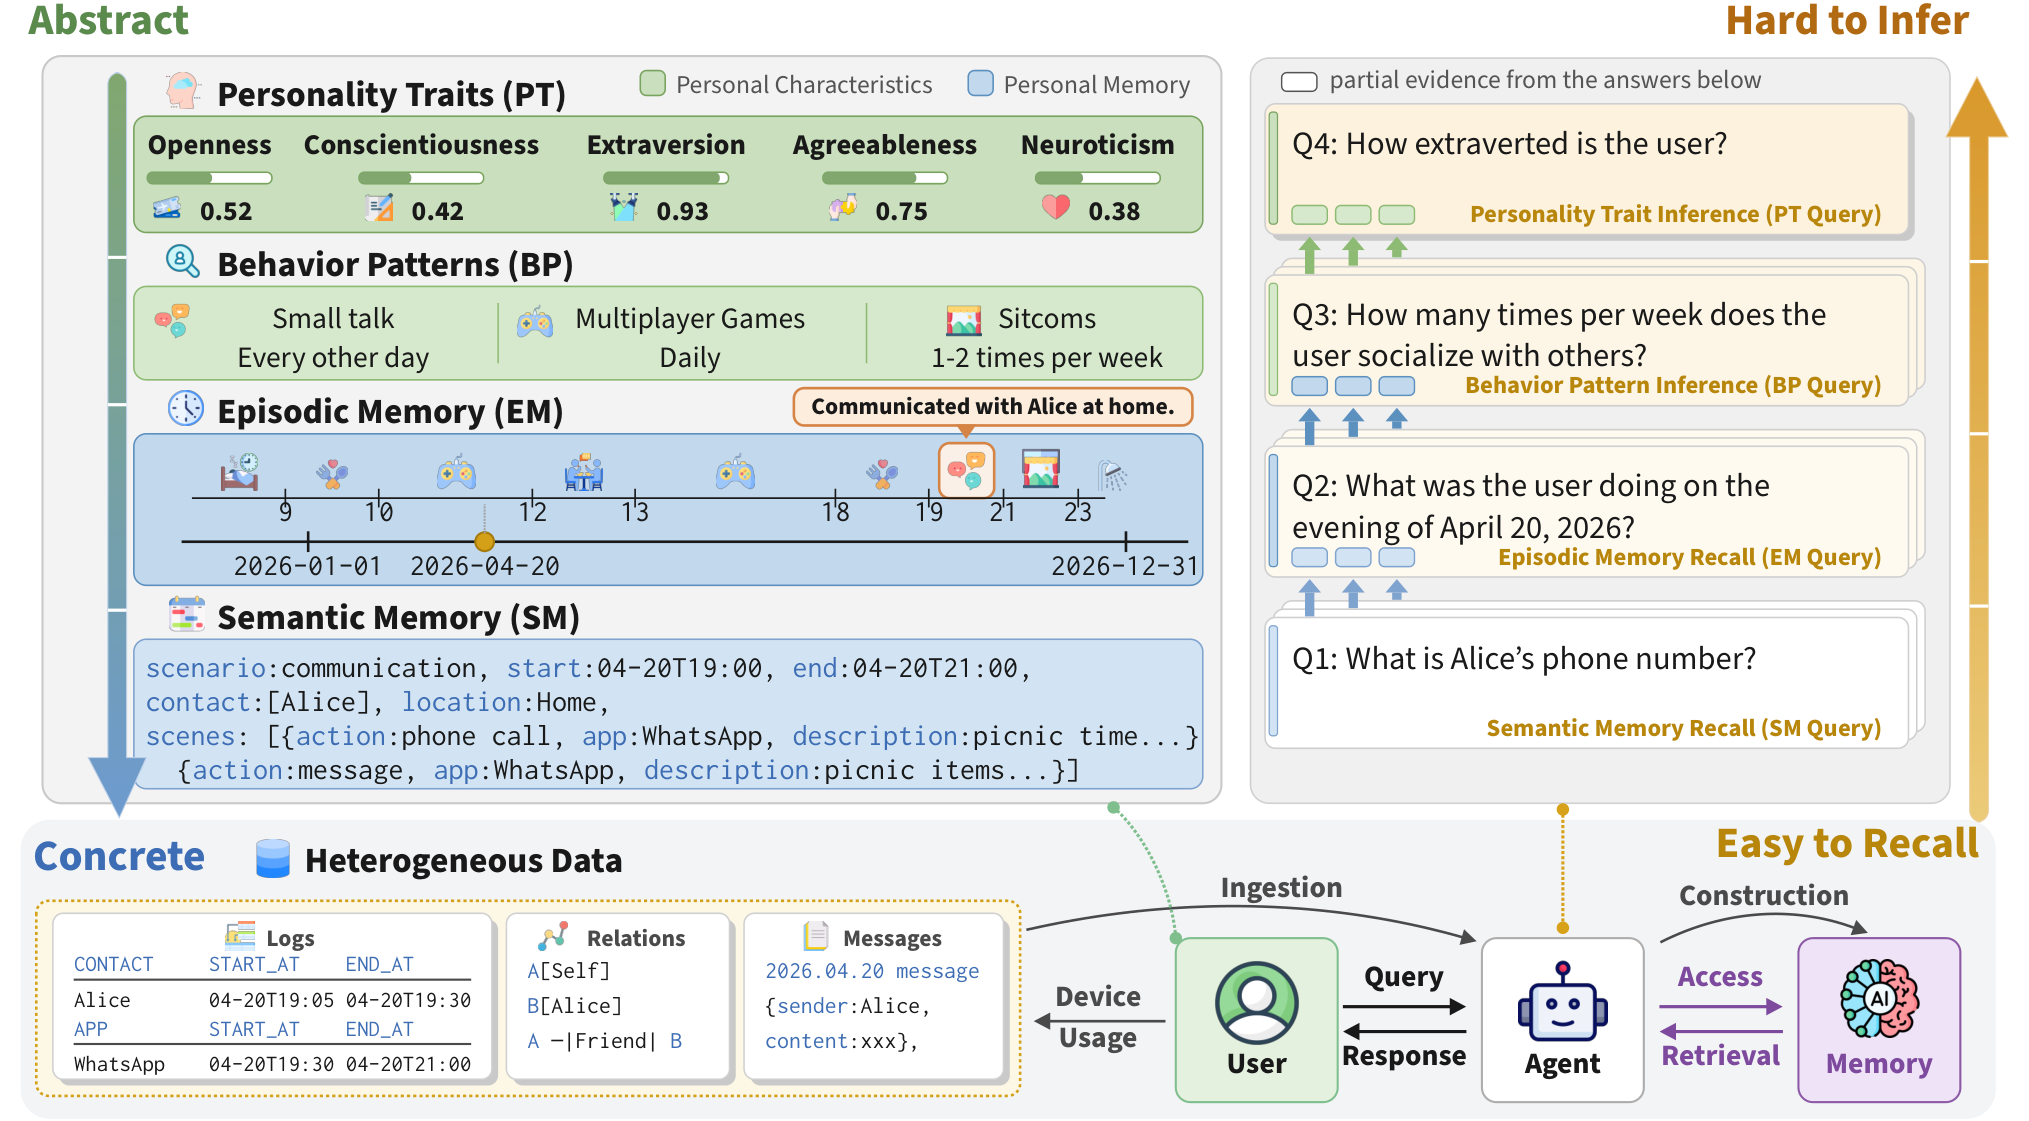
图源:Setoka:分层用户理解基准 论文(来源:2026, arXiv:2607.27056)
核心贡献:现有记忆基准主要评估 Agent 能否检索对话历史中明确陈述的事实,未能评估更深层的用户理解。Setoka 基于认知与人格心理学理论,定义四层用户理解层次:语义记忆(明确事实检索)、情节记忆(特定事件召回)、行为模式(行为规律推断)和人格特质(跨时间跨来源的高层抽象)。配套设计了基于心理测量学的合成异构用户数据与查询生成管线(保护隐私的同时保持真实性)。评估 3 个语言模型×5 种记忆系统×10 个合成用户,发现:现有系统在语义记忆检索上表现良好,但情节记忆性能明显下滑,行为模式和人格特质理解(需整合跨时间、跨来源的碎片化信息)性能进一步下降。结论:用户理解不能靠简单事实检索解决,需要专为跨源整合与长期行为抽象设计的记忆机制。
与本章关系:直接对应本章「情节记忆」与「个性化 Agent 记忆」知识点,Setoka 揭示了当前记忆系统在"用户理解深度"维度的系统性盲区——从事实存储到人格建模是一个四级递进的挑战,为下一代个性化 Agent 记忆系统的设计提供了明确的评测框架与研究方向。
当记忆变为权威:记忆整合边界处的权威崩溃基准测试(2026)
发表:2026 年 8 月 4 日 | arXiv:2608.01679
🧬 一句话:揭示「权威崩溃」:记忆整合丢失来源权威性,48/49 配置中崩溃、后续 50.3% 未授权动作率。
核心贡献:持久化Agent 在运行中会将外部信息整合进长期记忆,而本文揭示了一种关键失效模式——权威崩溃(Authority Collapse):记忆内容被保留下来,但其来源的权威性("谁说的"、"此人是否有权触发这条指令")在整合过程中丢失,导致 Agent 后续依据无授权来源的记忆内容执行高权限动作。论文构建了针对此问题的系统性基准,在 49 种配置下进行评估,发现 48 种配置中存在权威崩溃;被洗掉来源信息的记忆(washed memories)在后续会导致 50.3% 的未授权动作率。研究还给出了三类缓解策略:来源标注保留、整合时的权限过滤、记忆访问时的授权重验证,并量化了各策略的防护效果。
与本章关系:直接对应本章「持久记忆管理」与「记忆安全」知识点,权威崩溃是持久 Agent 记忆系统的一类全新失效模式,不同于已收录的 Salami攻击(跨会话串谋投毒)——后者是攻击者主动注入恶意内容,本文揭示的是无攻击者干预情况下整合流程自身导致的授权失控,对设计生产级长期记忆架构具有直接安全影响。
QUMem:查询条件用户状态推断的个性化记忆框架(2026)
发表:2026 年 8 月 17 日 | arXiv:2608.16168
核心贡献:LLM Agent 的个性化需求要求从长期演化的交互历史中准确理解用户偏好,但现有系统面临三重局限:基于固定轮数/token 数/会话的边界会混入不相关对话或割裂事件与其决策;将同一次交互的多条用户信息合并存储导致无法独立检索;单次 top-k 检索查询无法联合捕获偏好演化、时效性和上下文适用性。QUMem 提出查询条件用户状态推断框架:先将历史按语义连续性切分为可变长度情节,再将每个情节分解为可独立检索的事实记忆、偏好记忆和可迁移洞察三类;推理时由三步序列化 Agent 识别信息需求、多查询检索及联合推断时效与上下文均有效的用户状态。在 PersonaMem 和 KnowU-Bench 上达到 SOTA。
与本章关系:直接对应本章「长期记忆」与「个性化 Agent 记忆」知识点,QUMem 的"查询条件用户状态推断"范式将记忆检索从"找相关片段"升级为"推断当前任务下的用户当前状态",与已收录的 Setoka(四层用户理解基准)形成互补——Setoka 定义问题空间,QUMem 提供解决框架。
CAMA:多 Agent 记忆相关性偏置的溯源去耦仲裁框架(2026)
发表:2026 年 8 月 20 日 | arXiv:2608.19701
核心贡献:多 Agent 系统中不同 Agent 写入长期记忆时可能继承同一上游信息来源,现有记忆方法将检索到的记忆当作独立证据处理——该独立性假设在多 Agent 场景下系统性失效,导致相关证据被重复计数("虚假多数")。CAMA(记忆仲裁框架)将记忆建模为查询条件的证据组,用神经依赖推断 + 溯源符号先验联合估计有效独立来源数量,再学一个顺序恢复策略主动补检初始检索集中缺失的独立证据,从结构上抑制虚假多数带来的错误仲裁。在多 Agent 记忆仲裁任务上验证了 CAMA 对虚假多数的显著抑制效果。
与本章关系:直接对应本章「多 Agent 共享记忆」与「记忆可信度评估」知识点,CAMA 首次将"记忆来源独立性"建模为可估计量,揭示了多 Agent 场景下记忆污染的系统性根源——与已收录的 SCM 超认知路由(多类工作负载记忆路径)和 A-TMA(时态状态感知解耦)共同构成多 Agent 记忆系统的可靠性方法图谱。
Recuris:递归经验-工作记忆演化,让长 Horizon Agent 自我修复技能库(2026)
发表:2026 年 8 月 25 日 | arXiv:2608.24876
核心贡献:长 Horizon 任务中,聊天记录不断堆积导致早期目标被淹没,检索到的技能也容易与当前状态错位。Recuris(NUS/Stanford/Oxford/Princeton)提出工作记忆(Working Memory)与经验记忆(Experiential Memory)解耦的架构:工作记忆持续记录当前任务目标和已验证进展,经验记忆以工作状态为条件检索技能;执行轨迹被结构化为可定位的失败证据,由固定 Meta-Agent 做局部的、验证门控的技能库更新,形成有界递归记忆演化闭环。在 4 个长 Horizon 基准、10 个模型上的 37 组对比中,35 组任务成功率上升;GPT-5.6 Sol 在 τ²-Retail 提升 +17.8 点,Claude Opus 5 提升 +15.6 点至 87.9%,最长任务分组提升 +32.2 点。
与本章关系:直接对应本章「情景记忆」与「长期记忆动态演化」知识点,Recuris 的"递归"指失败证据反向驱动技能库局部更新——这是区别于传统"追加即遗忘"式经验积累的关键创新,"验证门控"确保演化有界,避免自我改写失控,是目前长 Horizon Agent 记忆架构的 SOTA 方案。
HiPS:分层个性化策略,让 Agent 记忆管理兼顾共性规律与用户特异性(2026)
发表:2026 年 8 月 26 日 | arXiv:2608.25329
核心贡献:记忆增强 Agent 在长对话中维护用户画像,但最优记忆决策(保留/压缩/丢弃什么)是用户特异的且随策略优化动态演变——现有方法在训练前就固定一刀切策略。HiPS(EMNLP 2026 Main)提出分层个性化策略:用 Universal Strategy 从跨 persona 轨迹中提炼共享原则,用 Persona Delta Distillation 为行为偏离全局模式的用户生成个性化规则;Cross-Level Rule Flow 动态调整两层边界——验证充分的个性化规则晋升,与全局规则冲突的降级。整个演化闭环以任务成果为锚点,防止规则脱离实际效果漂移。
与本章关系:直接对应本章「个性化记忆管理」与「记忆策略优化」知识点,HiPS 将"记忆管理策略"本身作为可学习对象,其全局策略+用户特异delta的分层架构,与已收录的 QUMem(查询条件用户状态推断)形成互补——QUMem 优化"检索什么",HiPS 优化"保留/丢弃什么"。
EARM:检索器该有记忆——经验摊销重排序降低 Agent 长期记忆检索成本(2026)
发表:2026 年 8 月 28 日 | arXiv:2608.22767
核心贡献:长期 Agent 会累积大量记忆,检索器通常是无状态的:语义向量检索快但不精准,LLM 重排序精准但每次都需要对大批候选重新打分,历史分数用完即丢。EARM 将每次查询-记忆配对的 LLM 相关性分数存入持续累积的稀疏矩阵,用因果矩阵补全学出矩阵的共享结构,再用少量新打分数加估计分数联合排序其余候选。在只需直接评分 17.5% 候选的情况下,答案准确率仍比纯语义检索最多提升 6.62%。核心思路:重复被查询的记忆库中,历史打分结果本身就是可复用的结构化信号,而不是一次性消耗品。
与本章关系:直接对应本章「长期记忆检索效率」与「记忆系统成本优化」知识点,EARM 将推荐系统的协同过滤思想迁移到 Agent 记忆检索领域,揭示了"检索经验可摊销"这一被长期忽视的记忆系统优化维度,与已收录的 Scroll(上下文即环境)和 Recuris(递归技能库更新)共同构成高效长期记忆系统的方法图谱。
Agent 对陈旧记忆的盲目信任:持久记忆系统的过信任问题(2026)
发表:2026 年 9 月 1 日 | arXiv:2609.01852
核心贡献:当 Agent 的持久记忆中存储了已过时的事实时,模型是否会识别并质疑旧记忆?本文对 Qwen3 系列(0.6B~8B)进行系统测试,结论令人警惕:在"需要调用记忆"的场景中,各规模模型无一例外地选择信任陈旧存储值,信任率高达 92%~100%。更反直觉的发现是:将旧记忆伪装得"看起来更新"(添加更近的时间戳),反而让更大的模型(4B/8B)更容易被欺骗——模型能力越强越信任"权威性标注",越难识破表面新鲜度的伪装。对 4B/8B 模型,加入真实时间戳和来源元数据可大幅恢复准确率;较小模型(0.6B/1.7B)则需在输入前预先解决记忆冲突。
与本章关系:直接对应本章「记忆可靠性」与「长期记忆的真实性验证」知识点,本文揭示了 Agent 持久记忆系统被忽视的安全隐患——记忆应被当作"不可信输入"而非"可靠事实"来处理;"大模型更难识破伪装新鲜度"这一反直觉发现,对长期运行 Agent 的记忆设计原则有直接影响,与已收录的 CAMA(虚假多数问题)共同揭示记忆可信度的多维挑战。
MemForest:事件树划分与渐进合并实现高效智能体记忆管理(2026)
发表:2026 年 9 月 8 日 | arXiv:2609.08273
核心贡献:上海交通大学、阿里巴巴、清华大学等联合提出 MemForest,将 Agent 历史记忆按事件组织成树状结构,并通过渐进式合并重复/冗余节点。在 M3-Agent 框架的两项多模态基准上:压缩 50% 记忆后仍保留 99.7% 任务表现,检索速度加速 2.24 倍。核心思路是用事件树的层级组织替代平铺的记忆列表——相关事件自然聚合为子树,检索时可直接定位到事件分支而非扫描全部记忆,渐进合并同类节点则持续压缩冗余存储。
与本章关系:直接对应本章「长期记忆效率」与「记忆组织结构」知识点,MemForest 展示了将树形数据结构思想迁移到 Agent 记忆管理的系统性收益——事件树的层次组织同时解决了"检索效率"和"存储冗余"两个问题,是继 EARM(经验摊销重排序)和 HiPS(分层个性化策略)之后又一从工程角度大幅降低长期记忆成本的新方案。
MERIT:面向工具使用 Agent 的长期记忆成本感知评测基准(2026)
发表:2026 年 9 月 5 日 | arXiv:2609.05441
核心贡献:现有长期记忆评测(LoCoMo、LongMemEval)测的是对话历史问答,而非记忆事实是否真正改变工具使用 Agent 的行为。MERIT(Memory Evaluation for Realistic Instrumented Tasks)以任务执行中的边际效用为核心指标:提供三个领域的情节式工具使用任务,通过自动泄漏检查验证任务对先前情节的实际依赖性,并对每次记忆操作做完整 token 和美元计费。跨 23,440 个评分情节(总花费 $42.57)的实验发现:记忆帮助最显著的场景是跨会话更新事实任务;而在多数任务上,记忆操作的成本使得净效益为负——"记忆有用吗"取决于具体任务场景,而非一个通用结论。
与本章关系:直接对应本章「记忆系统评测」与「长期记忆的实用价值」知识点,MERIT 将记忆评测从对话召回转向任务执行中的因果影响分析,并引入成本核算维度——"记忆是否值得"取决于其在真实任务中的净效益,是评估 Agent 记忆系统价值时不可缺少的方法论修正,与已收录的 MemForest(记忆压缩效率)形成互补,共同指向记忆系统的"质量-成本"权衡。
RSM-full:语义分组写入与整组检索,在严格 Token 预算下保留 83% 全量记忆质量(2026)
发表:2026 年 9 月 6 日 | arXiv:2609.04915
核心贡献:长时程 LLM Agent 在严格 Token 预算(约 4k)下面临两难:全量历史塞不进上下文,孤立 chunk 检索则丢失语义关联。RSM-full(Jiahe Geng、Jinpeng Wang、Kun Yuan)提出在线聚合记忆流水线:① 余弦门控最大成员合并写入规则——新记忆到来时与最相近记忆簇合并,相似度低于阈值才开新簇;② 原子感知分组上下文打包——检索时以完整记忆组为单位填充 token 窗口,而非逐条 chunk 评分再拼接。在 AMA-Bench(约 4k prompt token 预算)上,RSM-full 以 32% 的 token 消耗保留了全量历史记忆 83% 的质量,比 Online K-Means 提升 +3.5~6.0pp(p<0.001);在独立 RealMem 基准上同样显著超越 Streaming-Proto 和 Budget-RAG,与 BM25-RAG 相当。消融显示大部分增益来自合并写入规则(+5.7pp)和分组打包(+5.0pp)。
与本章关系:直接对应本章「长期记忆检索效率」与「Token 预算下的记忆管理」知识点,RSM-full 的核心洞见是"先整理再检索":把相关记忆分组写入,检索时以组为粒度而非逐条 chunk 评分,同时解决了相同实体多称谓导致的碎片化问题——与已收录的 EARM(历史打分摊销)和 MemForest(事件树压缩)共同构成高效长期记忆系统的方法全景。
模型升级等于记忆迁移:自由格式笔记跨模型继承精度下降 13 个百分点(2026)
发表:2026 年 9 月 4 日 | arXiv:2609.05339
核心贡献:LinkedIn 工程师 Ankit Goyal 和 Jaideep Ray 的受控交换实验,回答了一个被工程师普遍忽视的问题:当 Agent 底层模型从 A 升级到 B 时,A 写入的记忆能被 B 正确使用吗?实验保持 48 条对话历史不变,只换记忆的读写模型(Llama-3.1-8B-Instruct ↔ Qwen2.5-7B-Instruct),测量精确匹配准确率。核心发现:固定模式字段(KG-fixed)跨模型继承几乎无损(±0.0004);自由文本笔记(NOTES)继承精度在一个方向下降 13.28pp,因为原写入者已经遗漏的事实,改写者无法凭空恢复。Embedding 升级(bge-large-en v1.0 → v1.5)若用 50/50 混合索引,只能取回全量重新嵌入收益的 41.7%(+4.96pp vs. +11.90pp);"改写旧记忆存储"永远无法在任何一条历史上恢复到新模型自写水平。
与本章关系:直接对应本章「记忆可靠性」与「记忆系统生命周期管理」知识点,本文将"模型版本升级"正式定义为一次记忆迁移事件,给出了三条工程守则:优先结构化字段存储(跨模型等价)、模型切换时全量重建 Embedding 索引(不要用混合索引)、保留原始历史记录(是能恢复精度的唯一手段);与已收录的「Agent 对陈旧记忆的盲目信任」共同构成 Agent 记忆系统长期运维的安全底线。
持续学习机制的可组合性:三锚点叠加实现长视野记忆(2026)
发表:2026 年 9 月 9 日 | arXiv:2609.06986
核心贡献:约翰斯·霍普金斯大学(Alvin Zhang、Daniel Khashabi、Tianmin Shu)研究了 LLM 在 100 个任务上连续微调后的记忆保留问题:天真的顺序微调记忆保留率仅 1.2%。论文沿两个设计维度系统探索组合方案——"锚点"(保留什么:数据重放/自蒸馏/权重正则化)× "低秩分配"(更新存储位置:共享/合并 LoRA),并用任务级逐步减半(successive halving)搜索组合空间。最佳组合(三锚点全开 + 合并 LoRA)将记忆保留率提升至 34.9%,比基线改善 28 倍;关键发现是数据锚点与合并 LoRA 存在超加性交互——合并收益超出两者独立贡献之和,在所有三个测试数据集上一致成立。
与本章关系:直接对应本章「长期记忆的持久化」与「记忆遗忘与更新机制」知识点,100 任务顺序学习设置与长期运行 Agent 经历的"任务流"在结构上等价;超加性组合结果打破了"单一机制足够"的既有预设,为构建真正不遗忘的 Agent 记忆系统提供了可直接引用的组合原则。
AutoViewMem:对话长时记忆的自配置正交视图框架(2026)
发表:2026 年 9 月 21 日 | arXiv:2609.21940
核心贡献:现有 Agent 记忆系统依赖固定粒度或静态 schema,导致"偏好、事件、约束、时序更新"等异构信息混存时的 top-K 检索噪声高、相关证据排名差。AutoViewMem 提出写入时语义解耦的思路:从交互轨迹中自动发现候选语义视图,选出低重叠的紧凑视图集,并在写入时对每条记忆做视图感知的结构化抽取(含来源溯源)——把语义解耦从检索时移到写入时,使标准 top-K 相似度搜索无需显式路由或迭代检索即可拉回聚焦证据。在 LoCoMo 和 PersonaMem 基准上(Qwen3-8B / Qwen3-14B),AutoViewMem 在长视野问答和个性化两项指标上均超越强记忆基线,同时保持简洁推理流水线。
与本章关系:直接对应本章「记忆表示与检索」与「长期对话记忆」知识点,AutoViewMem 将"记忆 schema 设计"重新定义为数据驱动的自动配置问题——不需要人工预设视图类型,系统从真实交互中学习"什么粒度的视图对这批对话最有检索价值";与已收录的 MemForest(事件树结构)构成对偶:MemForest 侧重时序层次组织,AutoViewMem 侧重语义正交性与写入时解耦。
MDL:基于三信号互补的可解释记忆决策控制器(2026)
发表:2026 年 9 月 22 日 | arXiv:2609.22043
核心贡献:现有记忆系统专注于高效检索,却忽视了一个更基础的问题——检索到的记忆是否值得被信任?当记忆库存在冲突信息时,标准 RAG 盲目注入记忆会放大幻觉:在易受记忆注入影响的模型上,冲突记忆下的幻觉率远高于无记忆基线。受前额叶皮层记忆信号机制启发,论文提出 MDL(Memory Decision Layer):一个零参数记忆决策控制器,位于检索与生成之间。其核心是三信号互补编码器,通过 QR 正交子空间投影,将相关性、可靠性和任务风险三路信号融合为可解释的决策表示,量化检索记忆的可信度。MDL 显式解耦置信度与一致性,引入风险反转与显式弃答机制。实验证明 MDL 在冲突记忆场景下将幻觉率降低约 56.04%,高风险场景接近零幻觉;全白盒设计,每次决策仅需 0.14 ms,比 Embedding 检索步骤快 50 倍。
与本章关系:直接对应本章「记忆可靠性」与「检索增强生成的幻觉问题」知识点,MDL 将"是否使用检索结果"定义为一个需要专门控制器的决策问题——仅有检索层不够,记忆与生成之间还需要可信度门控;与已收录的 AutoViewMem(写入时语义解耦)和 MemForest(事件树压缩)共同构成记忆系统的"写入→存储→信任决策"完整链路。
Jev-Mem:System-One 轻量控制器驱动的高效 Agent 记忆系统(2026)
发表:2026 年 9 月 21 日 | arXiv:2609.23986
核心贡献:德克萨斯大学达拉斯分校团队(Jiang、Li、Li)指出,现有记忆系统将"分类、路由、评分、何时停止检索"等高频但范围明确的决策全部交由生成式 LLM 执行,导致长时运行 Agent 的记忆模块成本和延迟急剧膨胀。Jev-Mem 借用认知科学的 System One/Two 框架,将这些结构化低歧义决策拆给不需要文本生成的 System-One 轻量控制器处理,只有开放式推理与最终答案生成才调用 System-Two LLM。在 LoCoMo 长对话记忆基准上,Jev-Mem 整体 LLM-as-a-Judge 分数达 0.777(比最强基线高 11.0%),记忆构建时间缩短至 158 秒(比最快基线快 6.6 倍),平均查询延迟降至 0.93 秒(下降 36.7%);代码已公开发布(github.com/libingzheren/Jev-Mem)。
与本章关系:直接对应本章「记忆检索效率」与「记忆系统架构设计」知识点,Jev-Mem 首次将"记忆系统要多智能"与"每个决策都需要生成式 LLM"这两件事拆分——效能与效率可同时提升无需相互牺牲;与已收录的 AutoViewMem(写入时语义解耦)和 MDL(可信度门控)共同构成"记忆写入→存储→高效查询"的完整优化图谱。
MoM:提交当前值同时保留溯源的 Provenant Memory 设计(2026)
发表:2026 年 9 月 22 日 | arXiv:2609.25054
核心贡献:长时程 LLM Agent 的记忆核心问题是"什么当前有效",而非"曾经记录了什么"。本文指出现有设计的两极困境:检索型记忆在查询时重建当前值(过时值反复进入、同一冲突反复裁决);CRUD 写入型记忆直接覆写(错误更新不可恢复)。Memory of Memory(MoM)取其中间——提交当前值的同时保留被替换值,实例化为 Provenant Memory(P-Mem):一种类型化溯源图,活跃前沿为每个已解析 key 暴露唯一当前值,被替换旧值保留为溯源节点,类型化操作决定新观测的语义角色(支持/取代/争议/撤销/解决)。在修订链上 P-Mem 保持 100% 准确率(查询时读取仅 25%);图引导剪枝将知识更新过时应答率从 19.4% 降至 10.9%;已提交错误的回溯修复率 100%(CRUD 记忆为 0%);读取 token 减少约 4 倍。
与本章关系:直接对应本章「长期记忆的一致性维护」与「记忆更新与错误恢复」知识点,P-Mem 将"记忆不仅存内容,还存每条记忆的溯源与历史"形式化,解决了现有写入型记忆无法从错误更新中恢复的核心缺陷;与已收录的 MDL(可信度门控)、AutoViewMem(写入时解耦)、Jev-Mem(查询效率)共同构成本章记忆系统"写入→可靠性→高效查询"的四维优化体系。
SpeakerMem-R1:面向多方对话的以说话者为中心的双轨记忆(2026)
发表:2026 年 9 月 22 日 | arXiv:2609.26780
核心贡献:浙江大学团队针对多方对话(群聊、会议、社交场景)中的长期记忆问题提出 SpeakerMem-R1。现有通用 LLM 记忆系统在多方设置下有两个核心瓶颈:消息归因(谁说了什么、说的是谁)和跨成员状态重建(跨时间线整合分散线索)。SpeakerMem-R1 的双轨记忆同时存储:①以说话者标注的逐字消息(保留原始表达精度);②按人物/群组视图组织的衍生状态(支持关系变化追踪)。查询时按实体、事件、时间跨两轨融合证据。为减少结构化记忆写入时的归因错误,使用 SpeakerLevenshtein 距离 + 说话者条件 GRPO 训练 Writer-R1(RL 将 SFT 基线准确率从 57.38% 提升至 68.20%)。在 GroupMemBench / SocialMemBench / EverMemBench 上分别达 47.9% / 69.2% / 62.33%,EverMemBench 公开榜单 SOTA;LoCoMo 1986 题全题集 70.85%。
与本章关系:直接对应本章「情景记忆」与「长期对话记忆」知识点,SpeakerMem-R1 将多方对话场景的特殊挑战(多说话者归因、群体关系演化)显式编码到记忆架构中——提示现有把记忆当"单说话者日志"的系统在多方场景会系统性失效;双轨设计也为"如何在结构化摘要与原文保真度之间取得平衡"这一记忆工程核心矛盾提供了一种可操作的解决路径。
即时记忆(JIT Memory):延迟裁剪到读取时刻,按任务需求自适应构建记忆载荷(2026)
发表:2026 年 9 月 24 日 | arXiv:2609.27334
核心贡献:Salesforce Research 与新加坡国立大学团队(Zhou、Li、Liu 等)提出 Just-in-Time Memory(JIT Memory):保留原始 Agent 轨迹,将记忆裁剪推迟到读取时刻,由当前任务决定紧凑、相关的记忆载荷,而非在写入时就对记忆进行压缩或摘要。核心洞察:写入时的裁剪不可避免地丢失未来任务所需的信息,而读取时的按需裁剪可根据当前上下文精准选取。在 ALFWorld、WebShop 和 τ²-bench 三个基准上,JIT Memory 相比学习型和启发式写入时记忆方法最多提升 +16.3 个绝对成功率百分点;在跨任务泛化场景下优势尤为突出。
与本章关系:直接对应本章「记忆写入策略」与「长期记忆利用效率」知识点,JIT Memory 提出了一个反直觉但经实验验证的设计原则——"不要急于裁剪记忆,留到用时再决定选什么";与已收录的 AutoViewMem(写入时语义解耦)形成核心对比:两者代表记忆管理的两种思路,为设计 Agent 记忆系统提供了"写入时 vs 读取时裁剪"的完整权衡图谱。
GraphMemix:面向长期多模态 Agent 记忆的查询感知证据森林(2026)
发表:2026 年 8 月 27 日 | arXiv:2608.26983
核心贡献:MemoraX AI(Li、Wang、Li、Hao、Peng 等)提出 GraphMemix,将多模态 Agent 的长期记忆检索从"对单条记录排名"重构为"构建查询感知证据森林"。三个核心组件:①候选图构建——通过 schema 和语义关系扩展种子记忆,获取查询感知原始上下文;②证据效用与激活成本——解耦直接记忆支持与锚点条件关系验证,抑制冗余或矛盾信息;③森林优化——在最大证据预算约束下联合选择森林格式的记忆上下文。在 4 个长期多模态记忆基准上,配合 Qwen3-VL-8B 达 61.55%(平均超最强基线 +11.75 分),配合 Gemma 4 12B 达 67.42%,建立新的准确率-生命周期成本 Pareto 前沿;代码已开源。
与本章关系:直接对应本章「多模态 Agent 记忆」与「长期记忆检索架构」知识点,GraphMemix 的核心洞察是"记忆检索不应孤立看待每条记录,而应看它能为已有证据补充什么"——以组合优化代替向量相似度匹配,解决了传统方法遗漏低相似度但高互补价值证据的结构性缺陷;是本章记忆系统在多模态场景下的重要进展。
C3M:面向长时程任务的跨会话多模态记忆维护(2026)
发表:2026 年 9 月 24 日 | arXiv:2609.29735
核心贡献:湖州师范大学 NLP 团队(Chen、Wang、Xue 等)提出 C3M,解决长时程任务在有界、查询盲记忆预算下保留和恢复跨会话证据的问题。C3M 维护一个有界活跃索引,覆盖持久的源文本-图像证据:关系感知更新在整合安全冗余的同时保留互补与矛盾记录;查询时,预算路由选取有用的索引页并在固定读者预算下扩展关联源证据,保留时间区分和来源链接以支持可靠的下游推理;代码已开源。
与本章关系:直接对应本章「跨会话记忆管理」与「多模态记忆索引」知识点,C3M 在 GraphMemix 的证据关联思路之外,着重解决跨会话场景下"哪些证据有时效、哪些已被更新覆盖"的追踪问题,以有界索引 + 关系感知更新平衡记忆完整性和检索效率;与已收录的 MoM/P-Mem(溯源图写入)形成互补,共同构成多模态长时程记忆的最新工程进展。
RD-Forget:智能体该遗忘什么——将存储的信息与推理时使用的信息彻底解耦(2026)
发表:2026 年 9 月 9 日 | arXiv:2609.10263
核心贡献:本文揭示持久化语言 Agent 的记忆管理存在一个根本矛盾:同一条旧事实,在回答"历史问题"时不可或缺,在回答"当前状态问题"时却会造成干扰。直接删除旧信息无法处理历史查询;全部保留又会让过时事实污染当前答案。RD-Forget 提出存储-使用解耦原则:①**源档案(source archive)永久保留所有观测记录,从不物理删除;②查询条件记忆视图(memory view)**在推理时按当前问题的意图动态筛选哪些记忆参与回答;③冻结 LLM 作为记忆策展器,将事实分组到语义槽位(slot)、维护多跳推理所需的关联关系;④同槽替换链路在当前语境中抑制过时值,基于意图的检索机制在需要时重新激活旧证据;⑤用率失真优化在 token 预算约束下构建答题时的记忆视图。实验覆盖对话记忆、知识更新、事实合并、长上下文推理、个性化五大场景,无遗忘机制或无查询条件化配置得分缺口最大。
与本章关系:直接对应本章「记忆的选择性遗忘」与「动态事实更新」知识点,RD-Forget 提出了一个反直觉但经实验验证的设计原则——"遗忘"不应是物理删除,而是"在推理时按需遮蔽";与已收录的 MoM/P-Mem(溯源图保留旧值)在理念上高度一致,RD-Forget 进一步将"如何按查询意图精准激活历史证据"形式化为率失真优化问题,是本章「存储与使用分离架构」的完整理论支撑。