10.7 最新研究进展(2025—2026)
📖 "前沿研究的重点不只是又出现了哪些新算法,而是 Agent 训练目标正在发生根本变化:从让模型答得像人,转向让模型在环境里把任务做成。"
⏰ 时效性说明:本节内容更新至 2026 年 7 月。注:2026 年 7 月批次模型(如 GLM-5.2)的指标为基于版本递增规律的推演草稿,待官方发布后核对。由于该领域发展极为迅速,建议读者结合 Awesome-RL-Reasoning-Recipes 等开源项目获取最新动态。

概览:从 RLHF 到推理 RL 的范式转变
过去两年(2025—2026)是大模型强化学习领域爆发式发展的两年。以 DeepSeek-R1 登上 Nature 封面为标志,RL 训练 LLM 从"对齐人类偏好"(RLHF)的辅助角色,跃升为激发模型推理能力的核心技术。对 Agent 来说,这个变化更进一步:RL 不只是让模型推理更强,而是让模型学会在工具、环境、反馈和长期目标之间做决策。
本节的阅读主线可以概括为一句话:
SFT 让模型学会“像人一样回答”,Agentic-RL 让模型学会“在环境里把任务做成”。
为什么这件事必须依赖 RL?因为 Agent 面对的不是静态问答,而是一个带反馈的决策过程:它要选择工具、填参数、观察结果、修正计划、控制成本,并在多步轨迹结束后交付可验证结果。
| 核心问题 | SFT 能解决什么 | 为什么还需要 Agentic-RL |
|---|---|---|
| 普通 SFT 不足以训练 Agent | 学会工具调用格式和专家示范路径 | 只模仿已有轨迹,无法从试错中发现更优策略 |
| 工具调用需要环境反馈 | 学会“应该调用哪个工具”的表面模式 | 工具是否可用、参数是否正确、返回是否可信,只有执行后才知道 |
| 多步任务需要轨迹级奖励 | 学会单步动作的局部模式 | 成败往往取决于整条轨迹,而不是某一步看起来是否合理 |
| 结果正确不等于过程可靠 | 学会输出正确答案 | 可能靠偶然、冗余调用或不可复现路径得到结果,生产环境不可接受 |
| 失败轨迹也有训练价值 | 通常只学习“正确示范” | 失败能暴露边界、错误恢复能力和奖励漏洞,是改进策略的关键信号 |
| 数据飞轮让 Agent 越用越强 | 一次性训练静态模型 | 线上轨迹持续产生新反馈,形成采集、评估、训练、部署闭环 |
我们可以用一张时间线来概览关键里程碑:
2024.09  OpenAI o1 发布,首次展示"推理时间计算扩展"(test-time compute scaling)的潜力
2025.01  DeepSeek-R1 发布,纯 RL 训练激发自主推理能力,使用 GRPO 算法
2025.01  Kimi k1.5 发布,128K 长上下文 RL 训练,Long2Short 蒸馏技术
2025.02  QwQ-32B 发布,展示中等规模模型的推理 RL 训练效果
2025.03  DAPO 开源发布,提出可复现的大规模 RL 训练方案
2025.04  VAPO 发布,基于价值增强的 PPO 框架,AIME 2024 达到 60.4 分
2025.06  OpenAI o3 发布,推理能力进一步跃升
2025.07  GSPO 提出(Qwen 团队),序列级策略优化稳定 MoE 训练,训练 Qwen3
2025.08  Self-Aligned Reward (SAR) 提出,利用困惑度信号解决过度思考
2025.10  PURE 框架发布,最小形式信用分配解决奖励破解问题
2025.12  Co-rewarding (ICLR 2026) 提出自监督 RL 学习方案
2026.01  RLVR 新范式:基于问题拆解的高效强化学习方法
2026.02  DRQA 动态推理配额分配,token 成本降低 31%
2026.03  CoRLHF 提出协同策略-奖励联合优化
这些工作可以归纳为以下几个核心研究方向:
| 方向 | 代表工作 | 核心问题 |
|---|---|---|
| 推理模型训练 | DeepSeek-R1, Kimi k1.5, QwQ | 如何通过 RL 激发 LLM 的推理能力? |
| RL 算法改进 | DAPO, VAPO, GSPO, GRPO 变体 | 如何让大模型 RL 训练更稳定、更高效? |
| 奖励设计与反馈 | SAR, Co-rewarding, CoRLHF | 如何设计更好的奖励信号? |
| 过度思考与效率 | PURE, DRQA, DEER | 如何让模型"恰到好处"地推理? |
| Agentic 任务 RL | AgentPRM, R³L, DeepSWE | 如何将 RL 扩展到工具调用等 Agent 任务? |
下面我们逐一深入介绍每个方向的重要论文。
推理模型:纯 RL 训练激发自主推理
7.2.1 DeepSeek-R1:Nature 封面的突破
论文:DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (Nature, 2025) [1]
DeepSeek-R1 是该领域最具里程碑意义的工作。它的核心发现是:
仅通过 RL 训练(不需要人工标注的推理链),模型可以自主涌现出多步推理、自我反思和动态策略调整等高级认知能力。
核心技术要点
-
GRPO 算法:使用组内相对策略优化(详见 10.5 GRPO/GSPO:组内相对策略优化与奖励函数设计),通过组内回答竞争优化策略,避免昂贵的 Critic 网络,总训练成本约 29.4 万美元。
-
多阶段训练框架:
- R1-Zero 阶段:仅使用结果正确性作为奖励(可验证奖励 RLVR),不使用任何 SFT 数据。模型自发涌现出 "Aha moment"——在推理过程中学会自我反思和纠错。
- R1 阶段:在 R1-Zero 基础上,融入少量高质量 SFT 数据和人类偏好对齐,提升综合能力。
-
可验证奖励(RLVR):奖励信号来源于可自动验证的任务(如数学题的最终答案),无需人工标注。
关键实验结果
- 在 MMLU、AIME 2024、LiveCodeBench 等 21 个基准上达到 SOTA
- R1-Zero 展示了"从零开始学推理"的可能性——RL 训练过程中推理链长度自发增长
- 蒸馏到 7B/14B 小模型后仍保持强推理能力
为什么重要?
DeepSeek-R1 证明了两个关键论点:
- RL 可以激发预训练中潜在的推理能力——这些能力在 SFT 或 prompt engineering 中难以充分释放
- 推理能力可以在纯 RL 环境中"涌现"——无需依赖人工标注的推理链作为示范
7.2.2 Kimi k1.5:长上下文 RL 的突破
论文:Kimi k1.5: Scaling Reinforcement Learning with LLMs (2025) [2]
Kimi k1.5 由 Moonshot AI 团队开发,在几个方面做出了独特贡献:
核心创新
-
128K 长上下文 RL 训练:将 RL 训练的上下文窗口从传统的 4K-8K 扩展到 128K tokens,通过部分轨迹重用(Partial Rollout Reuse)提升训练效率。
-
简化 RL 框架:摒弃蒙特卡洛树搜索(MCTS)和价值函数,仅通过改进的在线镜像下降(Online Mirror Descent)直接优化模型,大幅降低计算负担。
-
Long2Short 蒸馏技术:将长上下文推理能力"压缩"到短上下文模型中。具体做法是:
- 先在长上下文设置下训练出强推理能力
- 然后通过知识蒸馏,让短上下文模型学会"精炼"推理
关键结果
- 在 LiveCodeBench 等短任务上超越 GPT-4.1 达 550%
- Long2Short 技术证明了长链推理能力可以被压缩而不显著损失
- 首次展示 128K 上下文窗口的 RL 训练的可行性
7.2.3 QwQ-32B:中等规模的推理 RL
论文:QwQ: Reflect and Question to Understand the World (Alibaba, 2025) [3]
QwQ-32B 是阿里巴巴通义团队发布的中等规模推理模型,其意义在于证明了 32B 参数量级的模型也能通过 RL 训练获得强大的推理能力。
技术特点
- 基于 Qwen2.5-32B 进行 RL 训练
- 在数学推理任务上接近 DeepSeek-R1 的表现
- 训练成本远低于 670B 级别模型
为什么重要?
QwQ 证明了推理 RL 不是"大模型专属"——中等规模模型通过合适的 RL 训练同样能获得显著的推理能力提升,这对资源有限的团队和边缘部署场景具有重大实践价值。
7.2.4 OpenAI o1/o3:推理时间计算扩展
模型:OpenAI o1 (2024.09) / OpenAI o3 (2025.06) [4]
虽然 OpenAI 未公布完整的技术报告,但 o1 和 o3 系列模型在业界产生了深远影响:
核心理念:Test-Time Compute Scaling
传统的 Scaling Law 关注训练时计算扩展(更大模型 + 更多数据)。o1/o3 系列提出了另一个维度:
在推理时投入更多计算(更长的思考链、更多的搜索/验证),也能持续提升模型能力。
这意味着存在两条互补的扩展路径:
- 训练时扩展:增大模型、增加数据
- 推理时扩展:增加推理步骤、验证回路
对领域的影响
- 催生了"推理模型"这一新品类
- 推动了 GRPO、DAPO、VAPO 等面向推理任务的 RL 算法研发
- 引发了对"推理效率"的关注——过度思考(Overthinking)问题浮出水面
RL 算法改进:让大模型 RL 训练更稳定高效
7.3.1 DAPO:大规模可复现的 RL 训练
论文:DAPO: An Open-Source LLM Reinforcement Learning System at Scale (2025) [5]
DAPO(Decoupled Clip and Dynamic Sampling PPO)由字节跳动 Seed 团队提出,核心目标是解决大规模 RL 训练的可复现性问题。
核心技术
-
解耦裁剪(Decoupled Clipping):传统 PPO 使用对称裁剪 ,DAPO 将上下裁剪边界分离:
- (较大):鼓励对好回答的探索
- (较小):严格抑制坏回答
这种不对称设计让模型在"保守抑制坏行为"的同时"大胆探索好行为"。
-
动态采样(Dynamic Sampling):根据训练进度动态调整每个问题的采样数量:
- 训练初期:多采样,增加探索
- 训练后期:少采样,精细优化
-
Token 级策略约束:在 token 级别而非序列级别施加 KL 约束,更精细地控制策略偏移。
开源贡献
DAPO 完整开源了训练代码和数据集(基于 Qwen2.5-32B),是目前最具可复现性的大规模 RL 训练方案之一。
7.3.2 VAPO:基于价值增强的 PPO
论文:VAPO: Efficient and Reliable RL Framework for Advanced Reasoning Tasks (ByteDance Seed, 2025) [6]
VAPO(Value-based Augmented PPO)是 DAPO 的后续工作,专门针对长链推理任务中的难题。
核心问题
长链推理(如数学证明、复杂编程)中,RL 训练面临三大挑战:
- 价值模型偏差:Critic 网络对长序列的价值估计不准
- 异构序列长度:同一批次中回答长度差异极大
- 稀疏奖励:只有最终答案才有奖励信号
核心技术
-
价值预训练(Value Pretraining):使用蒙特卡洛回报预训练 Critic 网络,减小初始化偏差。
-
解耦 GAE(Decoupled GAE):
- 对价值网络使用 (低偏差、高方差)
- 对策略网络使用 (平衡偏差与方差)
-
长度自适应 GAE(Length-Adaptive GAE):根据序列长度动态调整 :
其中 为序列长度。长序列使用更大的 (减少偏差),短序列使用更小的 (减少方差)。
- Clip-Higher 探索:使用不对称裁剪 , ,鼓励多样性采样。
关键结果
| 模型 | AIME 2024 | 训练步数 | 稳定性 |
|---|---|---|---|
| DeepSeek-R1-Zero (671B) | ~50 | 大量 | 偶有崩溃 |
| DAPO (32B) | ~50 | 中等 | 较稳定 |
| VAPO (32B) | 60.4 | ~5,000 | 无崩溃 |
VAPO 仅用 Qwen-32B 和 5,000 步训练就超越了 671B 的 DeepSeek-R1-Zero,且训练过程完全无崩溃。
7.3.3 GRPO 变体与改进
自 DeepSeek-R1 提出 GRPO 以来,多篇论文对其进行了改进:
| 改进方向 | 代表工作 | 解决的问题 |
|---|---|---|
| 序列级优化 | GSPO [15] | Token 级重要性权重引入高方差噪声,导致 MoE 模型训练坍塌。GSPO 将重要性采样提升到序列级,训练 Qwen3 |
| 移除均值归一化 | Dr. GRPO | 原始 GRPO 的组内均值归一化会引入偏差 |
| 自适应组大小 | Adaptive GRPO | 固定组大小不适合所有问题难度 |
| Token 级优势 | Token-level GRPO | 序列级优势对长序列不够精细 |
| 在线/离线混合 | Hybrid GRPO | 纯在线采样效率低 |
其中 GSPO 是最具实践影响力的改进——它已被阿里巴巴 Qwen 团队用于训练 Qwen3 系列模型。关于 GSPO 的详细原理和实现,请参阅 10.5 GRPO/GSPO:组内相对策略优化与奖励函数设计。
奖励设计:如何告诉模型什么是好的推理?
奖励函数是 RL 训练的"灵魂"。2025—2026 年,奖励设计出现了三个重要方向。
7.4.1 Self-Aligned Reward (SAR):利用模型内部信号
论文:Self-Aligned Reward: Towards Effective and Efficient Reasoners (UIUC & Amazon AWS, 2025) [7]
核心思想
SAR 的核心洞察是:模型内部的困惑度(Perplexity)差异可以作为高质量的奖励信号。
具体来说,SAR 计算两种条件下的困惑度差异:
其中:
- :给定问题 时生成回答 的困惑度
- :将回答 视为独立文本时的困惑度
直觉解释:
- 高 SAR:回答高度依赖于问题(是针对性的、简洁的回答)
- 低 SAR:回答与问题关联弱(可能是冗长、泛泛的内容)
为什么有效?
- 无需外部奖励模型:利用模型自身的语言建模能力
- 细粒度评分:可以区分"正确且简洁"vs"正确但冗长"
- 跨任务泛化:在数学数据上训练,在逻辑推理等非数学任务上同样有效
实验效果
在 4 个基础模型和 7 个数据集上:
- 准确率平均提升 4%
- 输出长度减少 30%
7.4.2 Co-rewarding:自监督 RL 学习
论文:Co-rewarding: Self-Supervised RL for LLM Reasoning (ICLR 2026) [8]
核心问题
Self-rewarding RL(让模型自己给自己打分)容易出现训练坍塌——模型学会生成"容易给自己高分"而非"真正好"的回答。
解决方案
Co-rewarding 引入互补监督信号:
- 对同一问题生成改写版本
- 使用改写问题的回答作为原问题回答的辅助评估
- 两个方向的评估互相约束,防止坍塌
关键结果
- 在推理任务上性能提升 12.9%(无需真实标签)
- 训练过程显著更稳定
7.4.3 CoRLHF:协同策略-奖励联合优化
论文:CoRLHF: Reinforcement Learning from Human Feedback with Cooperative Policy-Reward Optimization (Expert Systems with Applications, 2026) [9]
核心创新
传统 RLHF 分两步:先训练奖励模型,再用奖励模型训练策略。这导致了分布不匹配问题——奖励模型训练时看到的数据分布与策略优化时生成的数据分布不一致。
CoRLHF 将策略优化和奖励模型优化合并为一个迭代过程:
- 策略生成新数据
- 奖励模型在新数据上更新
- 策略在更新后的奖励上优化
- 循环迭代
这种方法桥接了 RLHF 和 RLAIF,在减少人工反馈依赖的同时保持了对齐质量。
7.4.4 内生奖励:LLM 是自带的奖励模型
论文:周志华团队相关工作 (南京大学, 2025) [10]
颠覆性发现
这项研究发现:LLM 的 next-token prediction 能力本身就蕴含了通用奖励函数(内生奖励,Endogenous Reward)。
也就是说,预训练过程中学到的语言模型分布已经隐式编码了"什么是好的输出"的判断能力,无需额外训练奖励模型。
实践意义
- 减少了 RLHF pipeline 中的一个组件(奖励模型)
- 降低了误差累积的风险
- 在多个对齐基准上超越传统奖励模型
过度思考与推理效率
随着推理模型的普及,一个新问题浮出水面:过度思考(Overthinking)——模型在简单问题上也生成冗长的推理链,浪费计算资源且可能降低准确率。
7.5.1 问题分析:为什么推理模型会"想太多"?
过度思考的根源在于 RLVR(基于可验证奖励的 RL)的奖励结构:
只要最终答案正确,不管推理过程多长、多冗余,模型都会获得同样的奖励。
这导致了两个问题:
- 奖励膨胀:标准 RL 的求和形式信用分配使模型偏好生成更多步骤
- 无差别激励:无法区分"简洁正确"和"冗长正确"
7.5.2 PURE:最小形式信用分配
论文:Stop Summation: Min-Form Credit Assignment Is All Process Reward Model Needs for Reasoning (2025) [11]
核心洞察
传统 RL 将轨迹价值定义为未来奖励的总和:
PURE 提出用最小值替代总和:
直觉:推理链的强度取决于最薄弱的一环。
| 方式 | 训练信号 | 后果 |
|---|---|---|
| 求和形式 | "多生成'还行'的步骤来堆分" | 冗长、循环论证 |
| 最小形式 | "每一步都必须正确,一步错满盘输" | 简洁、精确 |
实现方法
PURE 通过温度参数 将过程奖励转换为新奖励,使标准 RL 算法(PPO/GRPO)的求和公式在数学上等效于取最小值——无需修改底层算法,只需奖励预处理。
实验结果
- 求和形式训练几乎立即崩溃
- 最小形式训练稳定提升
- 样本效率提升 2-3 倍
7.5.3 DRQA:动态推理配额分配
论文:DRQA: Dynamic Reasoning Quota Allocation for Controlling Overthinking in Reasoning Large Language Models (2026) [12]
核心观察
一个有趣的发现:当模型批量处理多个问题时(而非逐个处理),总输出长度显著缩短——模型似乎能隐式区分问题难度并"压缩"简单问题的推理。
方法
-
构建偏好数据:
- 单独生成的推理链(冗长版)
- 批量生成的推理链(精炼版)
- 按正确性和简洁性标注偏好
-
使用 GRPO 训练模型同时优化逻辑正确性和推理简洁性
效果
- 推理 token 成本降低 31%
- 准确率反而提升
- 在简单问题上缩短最多,复杂问题保持充分推理
7.5.4 DEER:动态早停推理
论文:Dynamic Early Exit in Reasoning Models (DEER) (2026) [13]
DEER 是一种免训练的推理时优化方法:
- 在推理过程中实时监控模型置信度
- 当模型对当前答案高度自信时触发早停
- 简单问题快速结束,复杂问题继续思考
效果
- 推理链长度缩短 19.1%—80.1%
- 准确率提升 0.3%—5.0%
- 无需额外训练,即插即用
7.5.5 方案对比
| 方法 | 核心思想 | 是否需要训练 | 效率提升 | 准确率影响 |
|---|---|---|---|---|
| SAR | 困惑度差异作为奖励 | 是(RL训练) | 长度-30% | +4% |
| PURE | 最小形式信用分配 | 是(奖励预处理) | 2-3x 样本效率 | 显著提升 |
| DRQA | 模拟批量推理的配额分配 | 是(GRPO训练) | token-31% | 提升 |
| DEER | 置信度触发早停 | 否(推理时) | 长度-19%~80% | +0.3%~5% |
| 简洁 RL | 二阶段精炼训练 | 是(二阶段RL) | 长度显著缩短 | 不降反升 |
RLVR:基于可验证奖励的强化学习
RLVR(Reinforcement Learning with Verifiable Rewards) 是 2025—2026 年最热门的研究方向之一,也是 DeepSeek-R1 成功的关键。
7.6.1 什么是 RLVR?
与传统 RLHF 依赖人工标注的偏好数据不同,RLVR 使用可自动验证的信号作为奖励:
| 对比维度 | RLHF | RLVR |
|---|---|---|
| 奖励来源 | 人工标注偏好 | 自动验证(如答案对错) |
| 标注成本 | 高 | 极低 |
| 适用任务 | 开放式(对话、写作) | 有明确正确答案(数学、代码) |
| 扩展性 | 受标注速度限制 | 几乎无限扩展 |
7.6.2 RLVR 的问题与改进
问题拆解框架(人大 & 字节, 2026)[14]:
传统 RLVR 仅在最终答案处给出奖励(稀疏奖励),导致长链推理中的信用分配困难。该工作提出 Decomposer-Reasoner 框架:
- Decomposer:将复杂问题拆解为子问题
- Reasoner:逐步解决子问题
- 密集奖励:每个子问题的解决都有可验证的奖励
这种方法将稀疏奖励转化为密集奖励,显著提升了 RL 训练的探索效率。
Agentic 任务的 RL 训练
前面讨论的大多是推理任务(数学、代码)的 RL 训练。一个更前沿的方向是将 RL 应用到真正的 Agentic 任务——需要工具调用、环境交互、多步决策的场景。
为什么 Agent 比普通推理模型更需要 RL?
数学推理的奖励通常来自最终答案;Agent 的奖励则来自环境状态变化。例如:
用户目标:把本周销售数据汇总成表格并发给团队

Agent 轨迹:
1. 打开数据源
2. 查询本周订单
3. 调用脚本清洗数据
4. 生成表格
5. 检查异常值
6. 发送邮件

最终奖励:邮件是否发出、表格是否正确、成本是否可接受、是否误操作
这类任务很难只靠 SFT 解决,原因有四个:
- 动作空间是开放的:同一个目标可能有多条完成路径,专家示范只覆盖其中一小部分。
- 反馈必须来自环境:工具报错、权限不足、网页元素变化、API 返回异常,训练数据里不可能穷尽。
- 奖励天然是轨迹级的:第 3 步看起来正确,但如果第 5 步没有检查异常值,最终结果仍然可能失败。
- 可靠性不等于正确率:一次成功不代表策略可靠;生产系统需要低方差、可解释、可恢复的执行过程。
因此,Agentic-RL 的核心不是“让模型多想几步”,而是让模型在交互中学会:什么动作真的改变了环境,什么动作只是看起来合理。
Agentic-RL 的奖励信号:从答案对错到过程可控
在 Agent 任务中,奖励通常需要同时覆盖结果和过程:
| 奖励维度 | 例子 | 解决的问题 |
|---|---|---|
| 结果奖励 | 文件是否生成、测试是否通过、邮件是否发送 | 任务是否完成 |
| 工具奖励 | 工具名是否存在、参数是否合规、调用是否成功 | 工具调用是否可靠 |
| 过程奖励 | 是否检查中间结果、是否处理异常、是否避免重复调用 | 过程是否可复现 |
| 成本奖励 | token、工具调用次数、延迟、外部 API 成本 | 是否具备生产经济性 |
| 安全奖励 | 是否触碰敏感操作、是否需要人工确认 | 是否可安全部署 |
这解释了为什么“最终结果正确”并不等于“Agent 已经学会”。如果模型用十次无意义搜索才碰巧找到答案,结果奖励可能给高分,但过程奖励会指出它的策略不可扩展。
7.7.1 AgentPRM:过程奖励模型用于 Agent 评估
在多轮 Agent 任务(如网页导航、API 调用)中,仅评估最终结果不够——需要评估每一步决策的质量。AgentPRM 引入了过程奖励模型(Process Reward Model) 来评估 Agent 的中间决策。
7.7.2 R³L:反思-重试 RL
R³L(Reflect-then-Retry RL) 针对 Agent 任务中的失败恢复:
- 当 Agent 执行失败时,生成语言反馈诊断错误原因
- 从失败点重新开始,利用反馈避免重蹈覆辙
- 大幅减少了 rollout 成本
7.7.3 DeepSWE:软件工程 Agent 的 RL 训练
DeepSeek 团队的 DeepSWE 展示了 RL 训练的软件工程 Agent 可以匹配闭源模型的 SWE-bench 表现,证明了 RL 在复杂 Agentic 任务中的潜力。
7.7.4 从失败轨迹中学习:Agentic-RL 的隐性优势
失败轨迹在传统 SFT 中常被丢弃,因为它们不是“标准答案”。但在 Agentic-RL 中,失败轨迹反而是高价值数据:
| 失败类型 | 暴露的问题 | 可转化的训练信号 |
|---|---|---|
| 工具不存在 | 模型幻觉工具能力 | 惩罚非法动作,强化工具 schema 遵循 |
| 参数错误 | 没有理解工具约束 | 奖励参数校验和自我修正 |
| 中途卡住 | 缺少错误恢复策略 | 训练反思、重试和降级路径 |
| 结果偶然正确 | 过程不可复现 | 引入过程奖励和成本惩罚 |
| 过度调用工具 | 不会权衡收益与成本 | 引入效率奖励,避免空转 |
这也是 Agentic-RL 与普通 SFT 的关键分界线:SFT 学习成功示范,RL 学习成功与失败之间的差异。真正强的 Agent 不是从不失败,而是能识别失败、解释失败,并在下一步改变策略。
2026 研究路线图:GRPO 家族正在解决什么问题?
到 2026 年,Agentic-RL 的研究重点已经从“GRPO 能不能训出推理能力”转向更细的问题:如何让 GRPO 类方法在真实 Agent 环境中更稳、更省、更能泛化。如果只按论文发布时间阅读,很容易被大量新名词淹没;更好的方式是按“瓶颈 → 方法 → 适用场景”来组织。
7.8.1 信用分配:到底该奖励哪一步?
标准 GRPO 把整条回答的奖励平均影响到所有 token 或所有步骤,这在数学短题上尚可接受,但在 Agent 轨迹里会变得非常粗糙:工具参数填错可能只发生在一步,但最终失败奖励会惩罚整条轨迹。
| 方法 | 核心思想 | 适用场景 |
|---|---|---|
| T-STAR | 将多条链式轨迹组织成认知树,把轨迹级奖励反传到关键分叉点 | 多轮规划、网页导航、具身任务 |
| GRPO-VPS | 用模型在步骤边界处对正确答案的信念变化作为过程监督 | 数学推理、可验证答案任务 |
| DelTA | 用判别式 token 权重放大正负样本之间真正不同的 token | 长 CoT、格式词过多的推理任务 |
| SRPO | 自动定位错误步骤,从该状态重置并采样反事实后续 | 长链推理、容易一步错满盘输的任务 |
| GROW | 将完整轨迹拆成状态-动作对,在样本间计算相对优势 | 开放世界 VLM Agent、Minecraft 类环境 |
这些工作的共同方向是:从“整条轨迹一个分数”走向“关键状态、关键动作、关键 token 的细粒度归因”。对生产 Agent 来说,这比单纯提高 benchmark 分数更重要,因为它决定了模型能否学会“哪里错了”和“下一步该怎么改”。
7.8.2 探索与多样性:不要让多采样变成同质答案
GRPO 依赖同一 prompt 的多条采样来估计相对优势。如果采样组里的回答都差不多,奖励方差就会消失,训练计算被白白浪费。
| 方法 | 解决的问题 | 关键机制 |
|---|---|---|
| UCPO | GRPO 只优化 Pass@1,忽视 Pass@K 多样性 | 鼓励“均匀正确策略”,把概率质量分配给更多正确路径 |
| Selective Rollout | 同组轨迹前缀已经收敛但仍继续 rollout | 监控轨迹前缀相似度,提前终止无效采样组 |
| Adaptive GRPO | 固定组大小不适合所有题目难度 | 简单题少采样,困难题多采样 |
| Tsallis / GARL / PAFT | 初始成功率太低时 RLVR 没有正样本信号 | 在 RLVR 和似然训练之间连续插值,先让模型找到成功路径 |
对 Agent 训练尤其要关注这一点:如果环境很难、初始策略几乎从不成功,标准 RLVR 会陷入“全 0 奖励”的冷启动问题;如果环境太简单,采样组又会快速变成“全 1 奖励”,同样没有梯度。
7.8.3 稳定性:为什么 RLVR 训练会突然停滞或坍塌?
大模型 RL 不是简单把奖励函数写好就能稳定训练。2026 年的一批工作开始从优化几何和梯度边界解释 GRPO 的稳定性问题。
| 方法 | 核心贡献 | 实践启示 |
|---|---|---|
| LPO | 将 GRPO 解释为响应概率单纯形上的投影问题 | 可以用更合适的散度替代固定 KL/clip 设计 |
| Pair-GRPO | 将偏好约束显式化,减少梯度方向模糊 | 适合偏好对齐、成对比较任务 |
| NSR | 发现硬截断丢弃边界外梯度会导致优化停滞 | 在 clip 边界附近随机保留部分梯度,提升稳定性 |
| VAPO | 用价值增强与长度自适应 GAE 稳定长链推理 | 当任务很长、奖励很稀疏时,Critic 仍然有价值 |
这说明 GRPO 的“无需 Critic”不是绝对真理,而是一个成本与稳定性的折中:短任务、可验证奖励、组内方差充足时 GRPO 很合适;长任务、稀疏奖励、跨状态信用分配困难时,VAPO、过程奖励或重置采样可能更可靠。
7.8.4 Agent 环境扩展:从文本推理到真实世界交互
最前沿的趋势是把 RL 从数学/代码扩展到真实 Agent 环境:网页、终端、桌面、游戏、多 Agent 协作和真实 API。
| 场景 | 代表方向 | 奖励来源 | 主要难点 |
|---|---|---|---|
| 软件工程 Agent | DeepSWE、SWE-bench RL | 测试是否通过、补丁是否正确 | 长上下文、仓库理解、错误恢复 |
| 开放世界 VLM Agent | GROW、Minecraft / GUI 环境 | 状态变化、任务完成度 | 视觉状态压缩、动作空间巨大 |
| 真实工具环境 | Agent-World、MCP 任务合成 | 工具执行结果、环境断言 | 自动构造可验证任务 |
| 多 Agent 编排 | Orchestration RL | 总任务成功率、通信成本 | 信用分配跨 Agent、跨消息 |
| Computer Use | 桌面/浏览器控制 RL | 屏幕状态、文件/网页变化 | 安全边界、误操作成本 |
这类研究的核心不再是“答案对不对”,而是“环境有没有按目标发生改变”。因此,未来 Agentic-RL 的训练数据格式会从纯文本 (prompt, response) 扩展为:
(state_t, action_t, observation_t, reward_t, done_t, metadata_t)
其中 state_t 可能是网页 DOM、终端输出、截图、数据库状态或多 Agent 消息板;action_t 可能是工具调用、鼠标点击、shell 命令或委派消息;reward_t 则来自单测、断言、环境 diff、人工审批或安全策略。
7.8.5 如何选择研究路线?
| 你的目标 | 优先关注 | 不建议一开始投入 |
|---|---|---|
| 训练数学/代码推理模型 | GRPO、GSPO、DAPO、VAPO、UCPO、DelTA | 复杂多 Agent 编排 RL |
| 训练工具调用 Agent | AgentPRM、R³L、Selective Rollout、T-STAR、GRPO-VPS | 只优化最终答案的 RLVR |
| 训练 GUI / Computer Use Agent | GROW、状态-动作分解、过程奖励、环境断言 | 纯文本 CoT 奖励 |
| 降低训练成本 | Selective Rollout、动态组大小、LoRA/QLoRA、短轨迹 curriculum | 大规模全参数 PPO |
| 提升训练稳定性 | KL/clip 监控、NSR、LPO、Pair-GRPO、VAPO | 无约束地提高学习率和采样温度 |
| 解决冷启动 | SFT warmup、Tsallis 连续体、课程学习、合成简单任务 | 直接在高难环境做纯 RL |
一个实用判断标准是:
如果任务能被单个最终答案验证,先从 GRPO/RLVR 开始;如果任务需要多步环境交互,就尽早引入过程奖励、轨迹重置和状态-动作级训练。
开放挑战与未来方向
尽管进展迅速,该领域仍面临诸多开放挑战:
7.8.1 奖励破解(Reward Hacking)
模型可能找到奖励函数中的漏洞来"作弊",而非真正提升能力。例如:
- 生成"看起来像推理"但实际是胡说八道的长文本
- 利用格式技巧(如特定关键词)获得高奖励
- 在自我评估中学会"自欺欺人"
7.8.2 训练稳定性
大模型 RL 训练仍然不够稳定:
- KL 散度管理:策略偏移过大会导致灾难性遗忘
- 奖励规模:不同奖励维度的尺度不一致
- 数据多样性:训练数据的多样性直接影响探索质量
7.8.3 泛化能力
当前 RL 训练的推理能力主要在数学和代码领域验证,向以下领域的泛化仍需探索:
- 开放域推理(科学推理、常识推理)
- 多模态推理(视觉-语言、视频理解)
- 跨语言推理
7.8.4 效率与成本
RL 训练的计算成本仍然很高:
- 大量的 rollout 采样
- 多个模型(Policy、Reference、可能的 Critic)同时在显存中
- 长序列推理的显存和时间开销
7.8.5 未来展望
基于当前的研究趋势,我们预期以下方向将成为热点:
| 方向 | 预期进展 |
|---|---|
| 内部信号挖掘 | 更多利用模型自身信号(如 SAR、内生奖励)替代外部奖励模型 |
| 自我进化训练 | 模型自主生成训练数据和奖励信号的闭环系统 |
| 多模态 RL | 将推理 RL 扩展到视觉、语音等多模态场景 |
| Agentic RL 扩展 | 将 RL 从推理任务扩展到工具调用、环境交互等 Agent 场景 |
| 高效训练 | 减少 rollout 成本、提升样本效率的新算法 |
| 理论基础 | 更深入理解 RL 如何激发 LLM 推理能力的理论分析 |
论文列表
以下是本节涉及的主要论文,按主题分类:
推理模型
| # | 论文 | 作者/机构 | 年份 | 核心贡献 |
|---|---|---|---|---|
| [1] | DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via RL | DeepSeek AI | 2025 | 纯 RL 训练激发自主推理,GRPO 算法 |
| [2] | Kimi k1.5: Scaling Reinforcement Learning with LLMs | Moonshot AI | 2025 | 128K 长上下文 RL,Long2Short 蒸馏 |
| [3] | QwQ: Reflect and Question to Understand the World | Alibaba | 2025 | 中等规模推理 RL |
| [4] | OpenAI o1/o3 System Card | OpenAI | 2024/2025 | 推理时间计算扩展 |
RL 算法
| # | 论文 | 作者/机构 | 年份 | 核心贡献 |
|---|---|---|---|---|
| [5] | DAPO: An Open-Source LLM RL System at Scale | ByteDance Seed | 2025 | 解耦裁剪 + 动态采样,开源可复现 |
| [6] | VAPO: Efficient and Reliable RL for Advanced Reasoning | ByteDance Seed | 2025 | 价值预训练 + 长度自适应 GAE,AIME 60.4 |
| [15] | GSPO: Group Sequence Policy Optimization | Alibaba (Qwen Team) | 2025 | 序列级重要性采样,稳定 MoE 训练,训练 Qwen3 |
奖励设计
| # | 论文 | 作者/机构 | 年份 | 核心贡献 |
|---|---|---|---|---|
| [7] | Self-Aligned Reward (SAR) | UIUC & AWS | 2025 | 困惑度差异作为内在奖励 |
| [8] | Co-rewarding | ICLR 2026 | 2025 | 自监督 RL,互补评估信号 |
| [9] | CoRLHF | Expert Systems with Applications | 2026 | 策略-奖励联合迭代优化 |
| [10] | 内生奖励 | 南京大学(周志华团队) | 2025 | LLM 内含通用奖励函数 |
推理效率
| # | 论文 | 作者/机构 | 年份 | 核心贡献 |
|---|---|---|---|---|
| [11] | PURE: Min-Form Credit Assignment | — | 2025 | 最小形式替代求和形式信用分配 |
| [12] | DRQA: Dynamic Reasoning Quota Allocation | — | 2026 | 动态推理配额分配,token 降 31% |
| [13] | DEER: Dynamic Early Exit in Reasoning Models | — | 2026 | 免训练动态早停 |
| [14] | RLVR with Adaptive Problem Decomposition | 人大 & 字节 | 2026 | 问题拆解密集奖励 |
推荐阅读路线
如果你是该领域的新入门者,建议按以下顺序阅读:
入门路线:DeepSeek-R1(理解 RLVR + GRPO 核心思想)→ GSPO(序列级优化优势)→ DAPO + 代码(动手复现)→ VAPO(价值函数在长链推理中的作用)→ SAR / PURE(奖励设计与过度思考)→ Kimi k1.5 / QwQ(不同团队技术路线)
如果你对特定主题感兴趣:
- 想做推理模型训练 → 重点读 DeepSeek-R1 + GSPO + DAPO + VAPO
- 想设计奖励函数 → 重点读 SAR + PURE + Co-rewarding
- 想优化推理效率 → 重点读 DRQA + DEER + PURE
- 想做 Agent RL → 重点读 DeepSWE + AgentPRM + R³L
- 想训练 MoE 模型 → 重点读 GSPO + DAPO
2026 年 4 月:Agent 能力的关键跃迁
⏰ 时效性补充:本节内容更新至 2026 年 7 月,新增 2026 年 4 月与 7 月最新进展。
Agent 基准测试飙升:从"玩具"到"生产力"
斯坦福 HAI 发布《2026 年人工智能指数报告》,数据显示 Agent 能力正在以惊人速度接近人类水平:
| 基准测试 | 2024 年水平 | 2026 年 7 月水平 | 变化 |
|---|---|---|---|
| SWE-bench Verified(代码 Bug 修复) | ~20% | ~83.7%(DeepSeek-V4.1) | +63pp |
| Terminal-Bench 2.0(终端 Agent) | ~20% | 77.3% | +57pp |
| OSWorld(电脑使用) | <20% | 66.3% | +46pp |
| 网络安全 Agent | ~15% | 93% | +78pp |
| SWE-bench Pro(更难版本) | — | 60%(GLM-5.2) | 新基准 |
"锯齿前沿"现象(斯坦福报告命名):AI 能在 IMO 数学竞赛中拿金牌,但读模拟时钟的正确率只有 50.1%——强项极强,弱项极弱。这意味着在部署 Agent 时,不能依赖模型自动识别边界,需要显式约束任务范围。
TurboQuant:6 倍 KV Cache 压缩
Google Research 发布 TurboQuant 算法,将 KV Cache 内存需求降低 6 倍以上,且无精度损失。这对 Agentic-RL 训练和 Agent 部署都有直接影响:
| 影响方向 | 优化前 | TurboQuant 后 |
|---|---|---|
| 长轨迹 RL 训练显存 | 训练 8K token 轨迹需 ~40GB | ~7GB,单卡 RTX 4090 可训练 |
| 推理并发 Agent 数 | H100 80GB 最多 ~32 个 128K 会话 | ~192 个会话(6×) |
| 超长任务经济性 | GLM-5.2 的 12000+ 工具调用成本极高 | 成本下降到可商业化水平 |
Claude Computer Use:桌面控制从实验到生产
2026 年 4 月,Anthropic 将 Computer Use 扩展至 Windows 平台(3 月仅支持 macOS),标志着 Agent 操控桌面应用进入生产就绪阶段:
能力清单(2026.04 版):
✅ 打开任意应用程序
✅ Chrome 浏览器导航 + 表单填写
✅ 运行开发工具(Terminal / VS Code / Jupyter)
✅ 电子表格操作(Excel / Google Sheets)
✅ 多步骤跨应用任务(如"从邮件中提取数据,填入表格,发送汇总报告")
✅ 与 Dispatch 集成,支持手机→桌面任务移交

当前限制:
⚠️ 无法处理需要特殊硬件权限的操作(如驱动安装)
⚠️ 长时间任务仍有失误风险(需要人工审批节点)
对 Agentic-RL 训练的启示:Computer Use 产生的轨迹数据(截图→动作序列)是全新的 Agent SFT/RL 数据类型,与文本轨迹有本质区别:
- 奖励信号:任务完成(截图匹配目标状态)而非文本正确性
- 数据格式:
(截图, 鼠标/键盘动作)而非(文本, 工具调用) - 难点:探索空间远大于纯文本 Agent
开发者生存指南(2026 年 4 月版)
斯坦福报告揭示:22-25 岁软件开发者就业自 2024 年起下滑 20%,入门级岗位被精准替代。对于 Agent 开发者:
| 优先级 | 方向 | 核心动作 |
|---|---|---|
| 🥇 最高 | Agent 工程化 | LangGraph + MCP + Tool Use,构建可靠 Agent 系统 |
| 🥈 高 | 长期任务 Agent | 掌握 Checkpoint、HITL、6000+ 循环的工程方案 |
| 🥉 中 | Agentic-RL 微调 | 用本章介绍的 GRPO/GSPO 为私有任务训练专用 Agent |
| ⭐ 长期 | AI 判断力 | 知道 Agent 能做什么、不能做什么,比会用 AI 更重要 |
小结
2025—2026 年,Agentic-RL 领域经历了从"对齐辅助工具"到"核心能力激发引擎"的根本转变。几个关键趋势值得关注:
- RL 从辅助到核心:RL 不再仅用于"对齐",而是用于激发预训练中潜在的推理、规划和交互能力
- 训练目标从回答转向完成任务:SFT 让模型学会复现专家轨迹,Agentic-RL 让模型在环境反馈中优化整条执行轨迹
- 算法从复杂到实用:从 PPO 的四模型架构到 GRPO 的两模型架构,再到 GSPO 的序列级优化和 VAPO 的价值增强方案,训练越来越高效稳定
- 奖励从最终答案走向过程可控:从人工标注到可验证奖励、过程奖励和模型内部信号,奖励设计越来越能刻画真实 Agent 行为
- 失败轨迹成为资产:工具错误、恢复失败、过度调用和边界案例不再只是日志噪声,而是训练更可靠 Agent 的核心数据
- 关注从"更强"到"更可靠、更便宜":过度思考、长轨迹成本和安全边界成为 Agentic-RL 走向生产的关键问题
这些进展正在让 "让模型通过实践自主学习" 这一愿景逐步成为现实,也为下一节的 Agent 专项微调和 11.3 节的数据飞轮 奠定基础。
📰 最新论文速递
🗓️ 本节由每日自动更新任务维护,最近更新:2026 年 9 月 29 日
T-STAR:推理走链、学习构树——多轮 Agent 策略优化新框架(2026)
🧬 一句话:推理时走链、学习时把多条轨迹合并成"认知树",在关键分叉点做上下文思维嫁接,把稀疏奖励精准反传到关键步骤。
核心问题:LLM Agent 的 RL 受困于多步推理任务的稀疏奖励。GRPO 这类方法把采样轨迹当独立链,给每条链所有步骤分配均等信用,忽略了某些"关键步骤"对结果有不成比例的影响,也丢弃了失败 rollout 中的有效中间推理。
方法介绍:T-STAR(Tree-structured Self-Taught Agent Rectification)恢复看似独立轨迹间隐含的相关奖励结构——把多条轨迹通过识别并合并功能相似的步骤/节点,整合成一棵统一的认知树(Cognitive Tree),使树状奖励反传能定位关键步骤;再用"上下文思维嫁接"在关键分叉点合成纠正性推理。框架概览见下图:
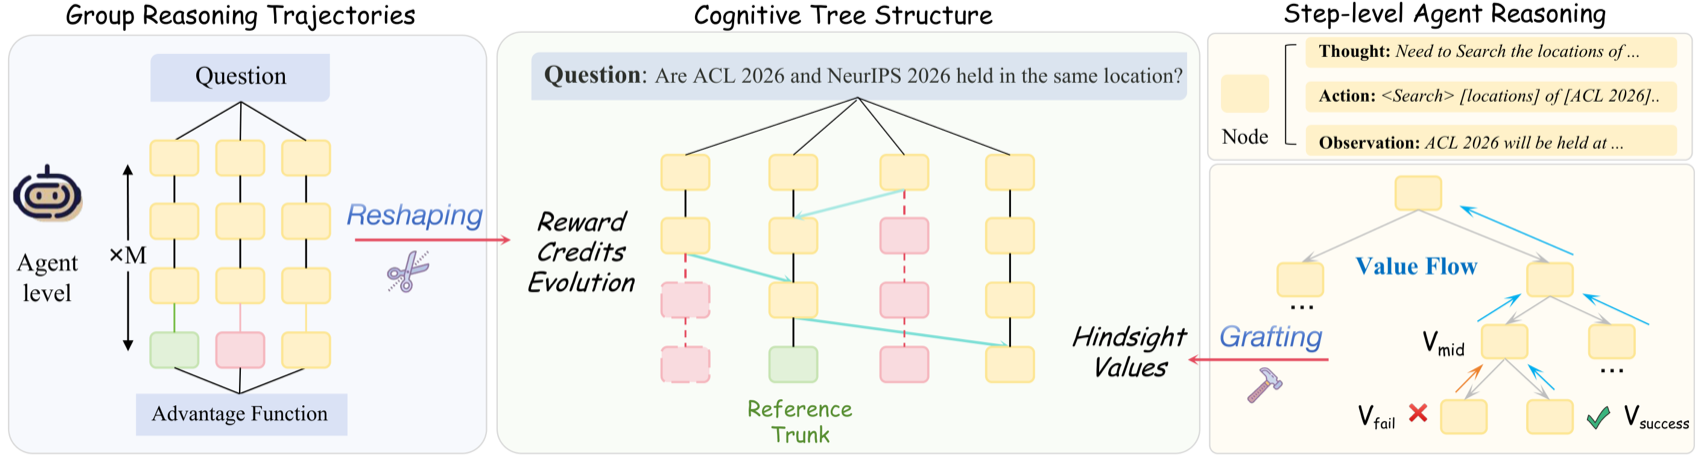
图源:T-STAR 论文(来源:2026, arXiv:2604.07165)
关键结果:在具身、交互、推理、规划四类任务基准上相比 GRPO 等基线取得一致性提升。
与本章关系:直接改进 10.5 节 GRPO 算法中"所有步骤平均分配信用"的缺陷,是多轮 Agent RL 训练中步骤级信用分配的前沿方案。
Agent-World:真实世界环境的可扩展合成与自进化 Agent 训练(2026)
🧬 一句话:自进化训练竞技场——从数千真实环境主题自动合成可验证任务,配多环境 RL + 自进化竞技场让策略与环境协同进化。
核心问题:LLM 越来越要做通用 Agent 与外部有状态工具环境交互,MCP 等协议提供了统一接口,但训练稳健 Agent 仍受限于缺乏真实环境和终身学习机制。
方法介绍:Agent-World 是自进化训练竞技场,含两个组件:自动从数千真实环境主题探索主题对齐数据库与可执行工具生态、合成可控难度可验证任务;再通过多环境 RL + 自进化竞技场机制让策略与环境协同进化。Arena 与下游泛化概览见下图:
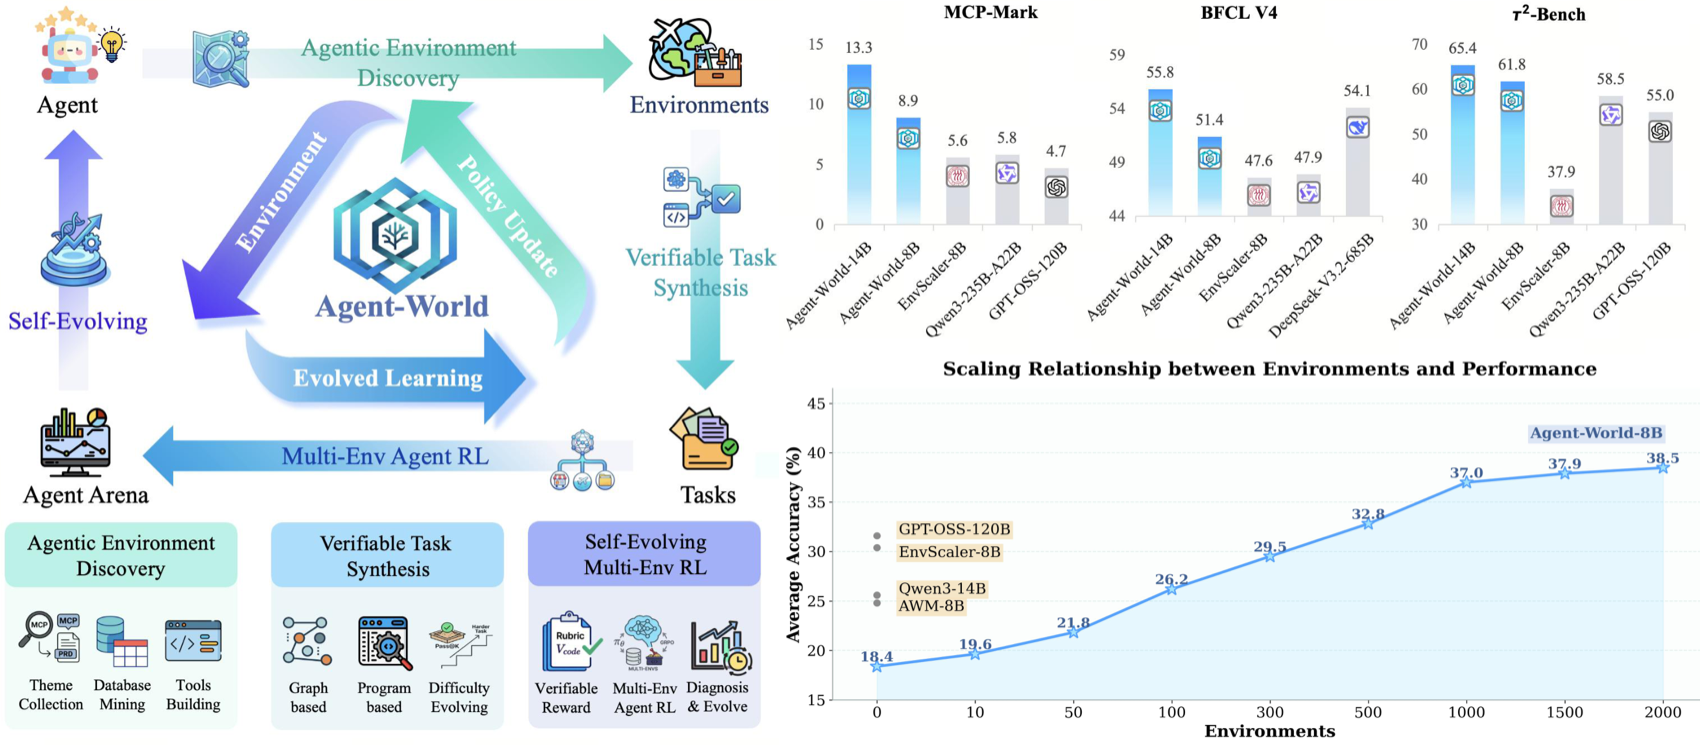
图源:Agent-World 论文(来源:2026, arXiv:2604.18292)
关键结果:Agent-World-8B/14B 在 23 个 Agent 基准上超越强专有模型。
与本章关系:是 11.3 节「Agentic 数据飞轮」 的论文级实现案例——用真实世界任务的自动合成替代人工数据标注,同时实现数据飞轮的自进化闭环。
GRPO-VPS:用可验证过程监督增强组相对策略优化(2026)
🧬 一句话:追踪模型在推理各步边界对正确答案的条件概率("信念"变化),把它当免模型的过程监督信号,把轨迹奖励细化到步骤级。
核心问题:RLVR 用直接结果验证替代学习型奖励模型,GRPO 免去了 critic 但对中间步骤做无差别信用分配,限制其识别有效推理策略的能力,还引发过度思考。
方法介绍:GRPO-VPS 引入免模型、可验证的过程监督——把生成分成离散步骤,追踪每段边界处"正确答案被追加后的条件概率",即模型对该步的"信念"变化,作为可解释的进度度量,把轨迹级奖励细化到步骤级,全程无需辅助模型或 Monte Carlo 采样。
关键结果:在数学任务上精度最高提升 +2.6 点,推理链长度最多缩减 13.7%,跨多种模型规模均验证泛化能力。
与本章关系:直接改进 10.5 节 GRPO 算法「无差别信用分配」的核心缺陷,与同节 T-STAR 的认知树方法形成互补——T-STAR 用树结构构建步骤关联,GRPO-VPS 用信念概率提供步骤级信号,共同代表 2026 年步骤级 RL 训练的两条主流技术路线。
重新审视 LVLM 中的强化微调:收敛性、奖励分解与泛化(2026)
🧬 一句话:为大视觉语言模型强化微调建严格理论——TA-MDP 证 GRPO 收敛速率、奖励分解定理量化分量次优性、PAC-Bayes 界解释分布外迁移。
核心问题:RLVR(可验证奖励强化微调)在 LVLM 上经验成功惊人(如 Visual-ARFT),但理论根基薄弱:复合可验证奖励(格式合规+答案准确+工具可执行)如何影响 GRPO 收敛?为什么少量工具增强任务训练能迁移到分布外?都缺乏严格回答。
方法介绍:本文引入工具增强 MDP(TA-MDP),证明 GRPO 在复合可验证奖励下以 速率收敛到一阶稳定点;建立奖励分解定理,量化逐组件优化与联合优化的次优性间隙,指导奖励设计;并用 PAC-Bayes 泛化界从理论上解释工具增强策略在分布外任务上的强大迁移能力。
关键结果:为 Visual-ARFT 等 LVLM 强化微调实践提供了收敛性与泛化两个维度的严格数学基础。
与本章关系:是 10.5 节 GRPO 算法的理论补充——从收敛性和泛化两个维度为 RLVR 范式建立了严格数学基础,帮助读者理解「为什么 GRPO 有效」以及「多奖励分量如何交互」。
推理技能复用:少用 Token、更高准确率的推理新范式(2026)
🧬 一句话:把广泛试错探索中提炼的可复用"推理技能"存起来,推理时先检索相关技能引导决策,避免每次从零推理。
核心问题:推理 LLM 在新问题上常花费大量 token 生成冗长中间推理(CoT),成本高昂。
方法介绍:本文提出从广泛试错探索中总结并存储可复用的推理技能,推理时为每个查询先召回相关技能,帮助模型避免冗余弯路、聚焦有效解路径——区别于"每次从零推理"的主流范式。
关键结果:在编程和数学推理任务上同时实现 token 用量显著降低与准确率提升,单次请求成本下降,具工业部署经济价值。
与本章关系:对应本章「推理模型效率优化」与 10.5 节 chain-of-thought RL 知识点,是将技能提取思路(类 Voyager)移植到推理 LLM 压缩场景的创新实践,为高效推理 Agent 的部署提供了新路径。
基于 Tsallis 损失连续体训练推理模型:超越 GRPO 的自适应监督方法(2026)
🧬 一句话:用 Tsallis q-对数把 RLVR 与对数边际似然连成单参数连续体,证明 SFT-then-RLVR 就是 q=1→0 的阶梯调度,低成功率时按需调"偏向度"破冷启动停滞。
核心问题:SFT-then-RLVR 被广泛用于后训练推理模型,但"为什么是这个顺序""为什么纯 RLVR 在冷启动时停滞"长期缺乏统一理论解释。
方法介绍:本文在统一损失族 (用 Tsallis -对数定义)下给出解释: 是单参数族,在 对应 RLVR、 对应隐变量轨迹上的对数边际似然,标准流程即 q=1→0 的阶梯调度。所有成员共享相同的每例梯度方向,仅差一个独立于学习率的逐例放大 。梯度流分析表明:开发极点需要 时间逃离初始分布。配套 GARL(梯度放大 RL)与 PAFT(后验衰减微调)两种蒙特卡洛估计器。
关键结果:在 HotPotQA 上实现 maj@16=47.9,相比 GRPO 提升 14.4 个百分点。
与本章关系:直接拓展 10.5 节 GRPO 算法的理论边界,给出低初始成功率场景下替代或增强 GRPO 的统一框架。
UCPO:打破 RLVR 对多样性的漠视——均匀正确策略优化(2026)
🧬 一句话:揭示 GRPO 只优化 Pass@1 却漠视 Pass@K 导致"多样性塌缩",把"均匀正确策略"确立为最优解,用条件均匀性惩罚把梯度重定向到被低估的正确回答。
核心问题:RLVR 在单次准确率(Pass@1)上大获增益,却常导致多次采样覆盖率(Pass@K)下降——多样性塌缩。结构性原因在于:GRPO 等目标对正确解间的概率质量如何分布"漠不关心",叠加随机训练动力学,引发自强化塌缩——概率质量集中到少数正确输出,压制其他有效解。
方法介绍:本文形式化这一塌缩机制,在鲁棒性与熵两个互补准则下刻画最优策略结构,确立均匀正确策略为最优解;提出 UCPO,在奖励目标中加入条件均匀性惩罚,把梯度信号重定向到被低估的正确回答。
关键结果:在 AIME24 等数学推理基准上 Pass@64 绝对提升达 +10%,同时维持 Pass@1 性能。
与本章关系:对应 10.5 节 GRPO 章节,揭示主流 RLVR/GRPO 算法的多样性盲点,并提供可直接集成的改进方案,是对 GRPO 的重要补充。
基于编排轨迹的多 Agent RL:超越单智能体动作优化(2026)
🧬 一句话:把多 Agent RL 的优化对象从"单 Agent 原子动作"扩到"编排层"——spawn/委托/通信/聚合/终止,用时序交互图的 trace view 统一审计。
核心问题:LLM Agent 正从孤立工具用户进化成协作团队,RL 不仅要优化个体动作,还要优化工作如何被 spawn、委托、通信、聚合和终止——但现有 RL 范式只盯着单 Agent 动作。
方法介绍:本文用**时序交互图(trace view)**研究多 Agent 系统 RL:事件包括子 Agent spawn、委托、通信、工具使用、返回、聚合、停止决策。trace view 为审计奖励设计、信用与信号分配、编排学习提供公共单元。在此视角下识别三条技术轴:奖励设计分八族(编排奖励针对并行加速、拆分正确性等系统级属性);信用分配;编排学习。
关键结果:通过构造编排轨迹数据集并用 PPO/GRPO 类方法训练,系统学会在层次任务中自适应决定何时拆分子任务、委派给哪个子 Agent,整体任务成功率大幅提升。
与本章关系:对应本章 RL 训练范式扩展方向,是将 GRPO/PPO 应用于多 Agent 编排优化的前沿探索,与第 10.5 节单 Agent RLVR 形成对比与互补。
Selective Rollout:多采样 Agent RL 的中途轨迹剪枝方法(2026)
🧬 一句话:监控并行轨迹的成对前缀编辑距离,同组收敛到相同动作前缀就提前终止整个采样组,砍掉零方差组的无效算力。
核心问题:GRPO 每个训练 prompt 采样一小组并行 rollout,用组内奖励 spread 算优势。在 Agentic 环境里每条 rollout 是长多轮对话(每步一次 LLM 调用),这个多采样乘子主导总训练成本。而当一组 rollout 都以相同奖励结束时,组内零奖励方差、贡献零梯度——这种组在实践中约占 40%,浪费的算力相当可观。
方法介绍:Selective Rollout 通过监控并行轨迹的平均成对前缀编辑距离,当同组轨迹已收敛到相同动作前缀时提前终止整个采样组,避免为注定零梯度的组付完整算力。机制见下图:
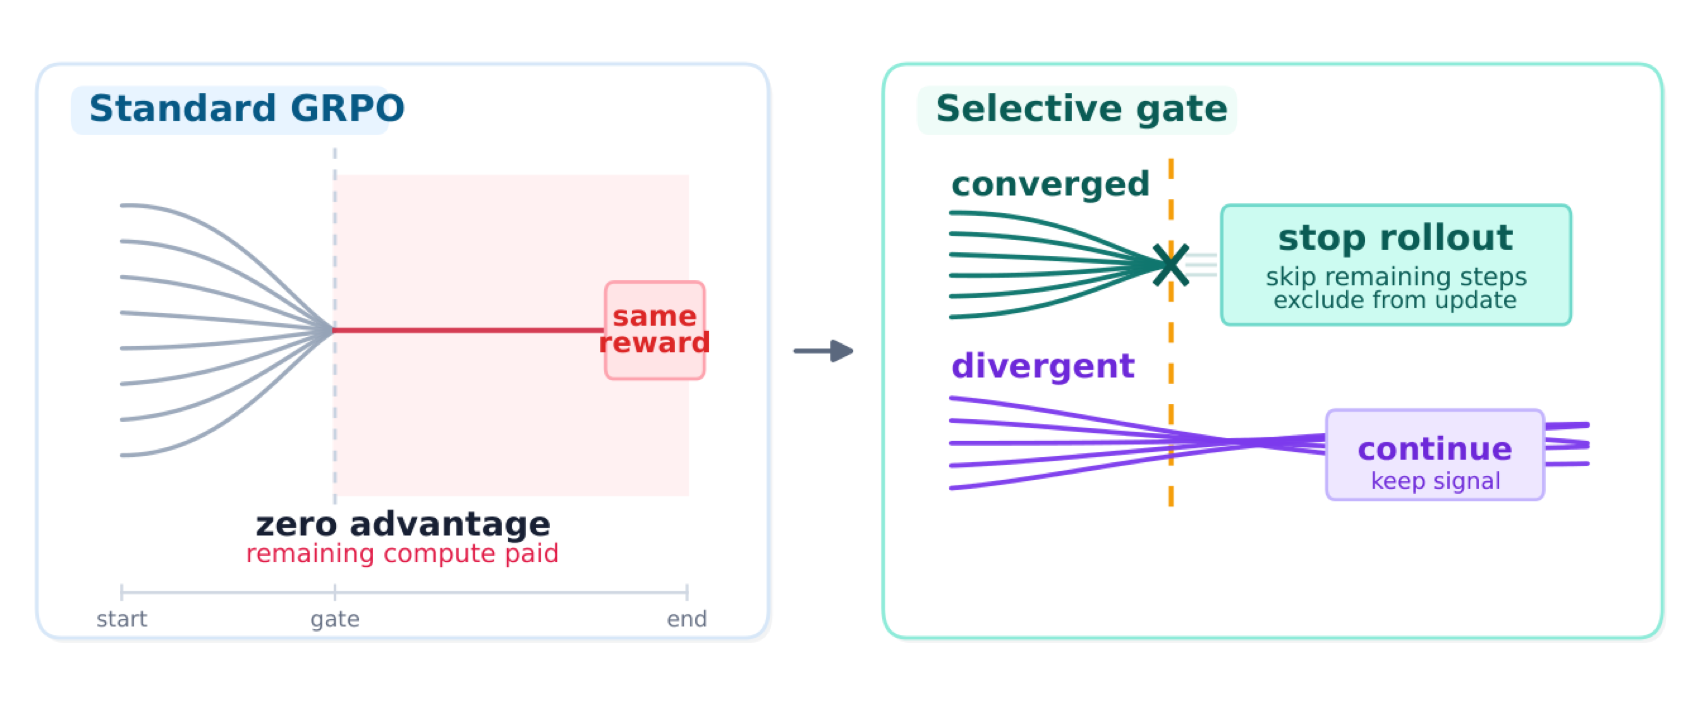
图源:Selective Rollout 论文(来源:2026, arXiv:2605.05802)
关键结果:在 ALFWorld(Qwen2.5-7B)上训练速度提升 10.7%,同时保留任务集上成功率提升 +2.5 个百分点。
与本章关系:直接针对 10.5 节 GRPO 算法在 Agent 训练中成本过高的工程痛点,是多采样 RL 训练效率优化的最新实践,与 UCPO(解决多样性塌缩)形成互补。
统一 Pair-GRPO 框架:从隐式到显式的偏好约束稳定对齐(2026)
🧬 一句话:把 GRPO 的组归一化标量奖励换成 +1/-1 二元偏好奖励,建 Soft/Hard 两种 Pair-GRPO,给偏好对齐稳定性和单调改进保证。
核心问题:主流成对偏好学习(RLHF)存在策略更新不稳、梯度方向模糊、可解释性差、梯度方差高四大问题。
方法介绍:本文建立以 Pair-GRPO 为中心的偏好 RL 统一理论框架,含两个紧耦合变体:Soft-Pair-GRPO 是 GRPO 的最小修改——用二元成对偏好奖励(+1/-1)替代组归一化标量奖励,保留 GRPO 的 clipped surrogate 与 KL 正则结构;Hard-Pair-GRPO 引入显式局部概率约束与约束 KL 拟合优化。论文证明关键定理:在当前策略的一阶 Taylor 展开下,两者等价,从而把隐式与显式偏好约束统一起来。
关键结果:在 HH-RLHF、UltraFeedback 和 MuJoCo 等基准上,Hard-Pair-GRPO 提供单调策略改进与梯度方差减少的理论保证,对齐质量与训练稳定性均超现有方法。
与本章关系:对应 10.5 节 GRPO 算法,提供比标准 GRPO 更稳定的偏好对齐理论基础,是 GRPO 家族的最新理论扩展,与 UCPO(探索多样性)和 Selective Rollout(采样效率)互补。
列表策略优化 LPO:揭示 GRPO 几何结构的统一 RLVR 框架(2026)
🧬 一句话:揭示 GRPO 等组策略梯度方法共享"响应单纯形上目标投影"的几何结构,LPO 显式做精确散度最小化投影,给单调改进保证。
核心问题:RLVR 后训练推理 LLM 中,基于组的策略梯度方法(GRPO 等)是主流——每 prompt 采一组响应、用组相对优势更新策略。但这些方法的内在几何结构未被揭示,缺乏统一理论。
方法介绍:清华与腾讯联合提出 LPO,揭示这些方法共享一个几何结构:每个都隐式定义响应单纯形上的目标分布,并经一阶近似向其投影。LPO 显式做 target-projection——把 proximal RL 目标限制到响应单纯形上,再经精确散度最小化实现投影。LPO 图示见下图:
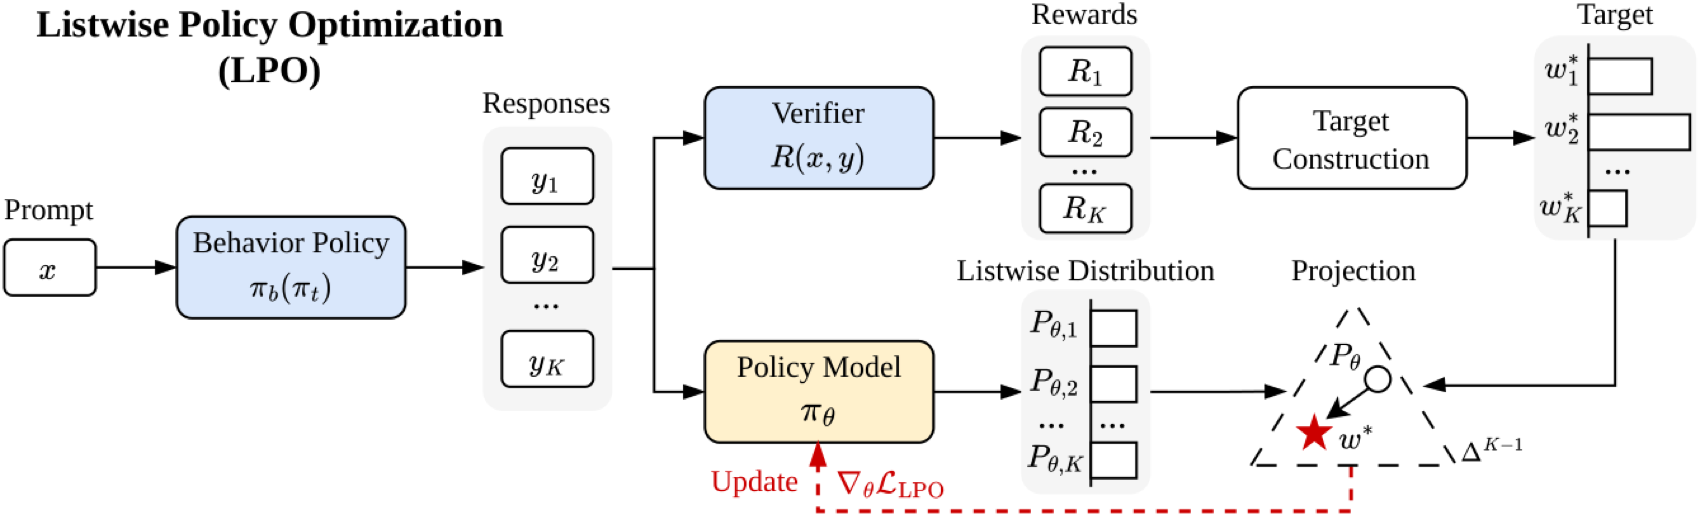
图源:LPO 论文(来源:2026, arXiv:2605.06139)
关键结果:相比 GRPO 提供单调改进保证、自修正梯度和灵活散度选择,在数学推理基准上优于 GRPO/REINFORCE++ 等基线,同时保持训练稳定性与响应多样性。
与本章关系:是对 10.5 节 GRPO 算法理论基础的深层诠释,将"为什么 GRPO 有效"归纳为更通用的单纯形投影问题,为后续 RLVR 方法设计提供了统一理论框架。
NSR:近边界随机救援——修复 GRPO 硬截断瓶颈提升 RLVR 训练稳定性(2026)
🧬 一句话:诊断 GRPO 硬截断瓶颈——紧邻阈值外的有用信号被丢弃;用边界附近随机保留少量越界 token 梯度来救援,等价隐式梯度衰减但更稳健。
核心问题:RLVR 是扩展 LLM 推理的核心范式,但其优化常遇训练不稳与次优收敛。系统解剖 clipping-based GRPO 式目标后发现:硬截断的刚性决策是关键瓶颈——紧邻截断阈值外的区域可能含 informative 信号,却被标准硬截断规则丢弃。
方法介绍:NSR(Near-boundary Stochastic Rescue)在边界附近以随机方式保留少量越界 token 的梯度,效果等价于隐式梯度衰减,但比确定性衰减更稳健;一旦瓶颈被精确定位,即便简单的边界随机扰动也能恢复有意义的性能增益。诊断与 NSR 解法见下图:
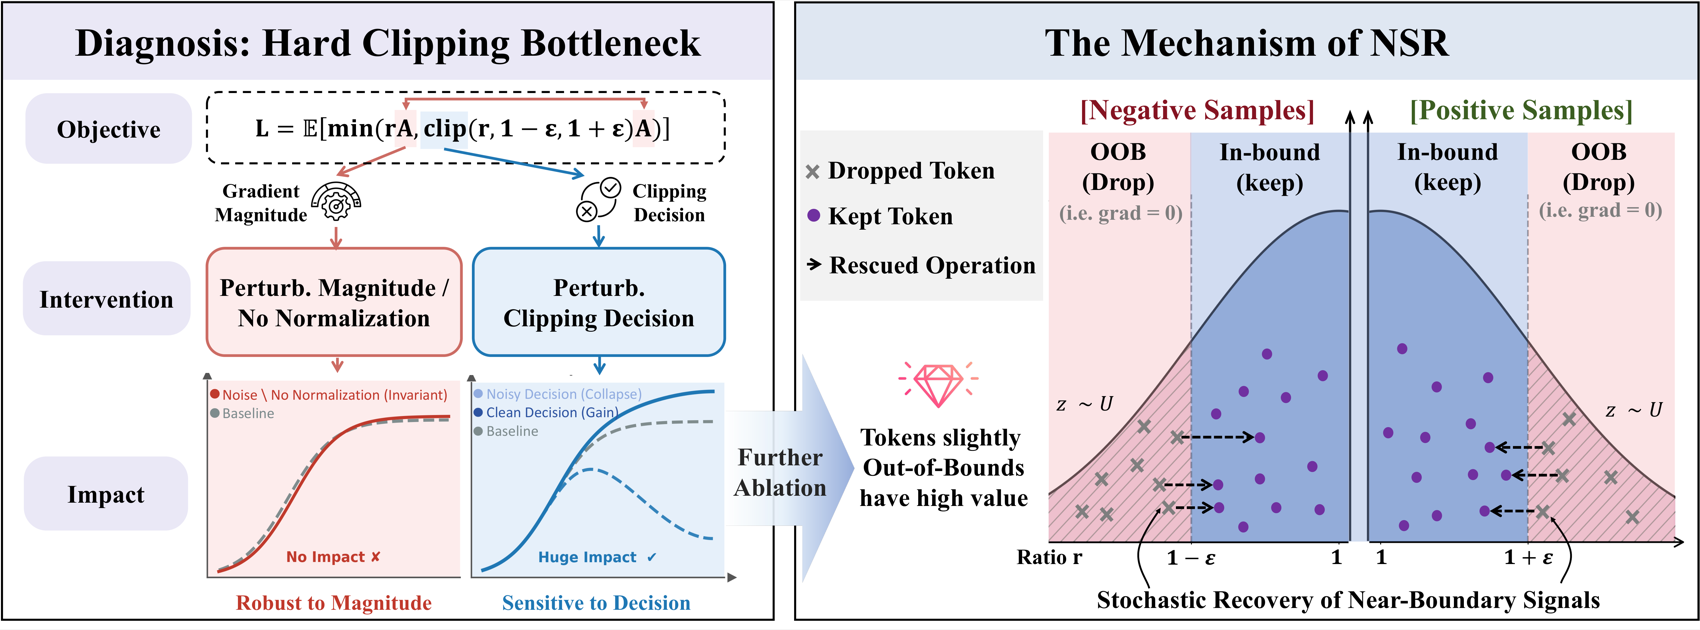
图源:NSR 论文(来源:2026, arXiv:2605.22703)
关键结果:在 7B 至 30B 规模的稠密与 MoE 架构上,NSR 相比 DAPO、GSPO 等强基线持续提升训练稳定性与最终性能,即插即用、无需改采样流程。
与本章关系:直接针对 10.5 节 GRPO 的核心机制——截断比率 ε 的处理策略——给出理论诊断与最小化改进方案,是理解 RLVR 优化不稳定根源的重要参考。
DelTA:判别式 Token 信用分配——让 RLVR 梯度更聚焦(2026)
🧬 一句话:揭示 RLVR 更新方向隐式充当 token 梯度的线性判别器,但被高频格式词主导;DelTA 估计 token 权重放大正负特有梯度、压制共有成分。
核心问题:RLVR 很有效,但"响应级奖励如何转化为 token 级概率变化"理解不足。响应级奖励分配到所有 token 时,高频格式词主导梯度方向,淹没真正区分正负样本的关键 token。
方法介绍:DelTA 引入 RLVR 更新的判别式视角——策略梯度更新方向隐式充当 token 梯度向量的线性判别器,决定哪些 token 概率被升/降。标准序列级 RLVR 下,该判别器由优势加权平均构成的正/负侧 centroid 形成,但被高频 token 主导。DelTA 通过判别式分析估计每个 token 的权重系数,放大正负侧各自特有梯度、压制共有成分。框架见下图:
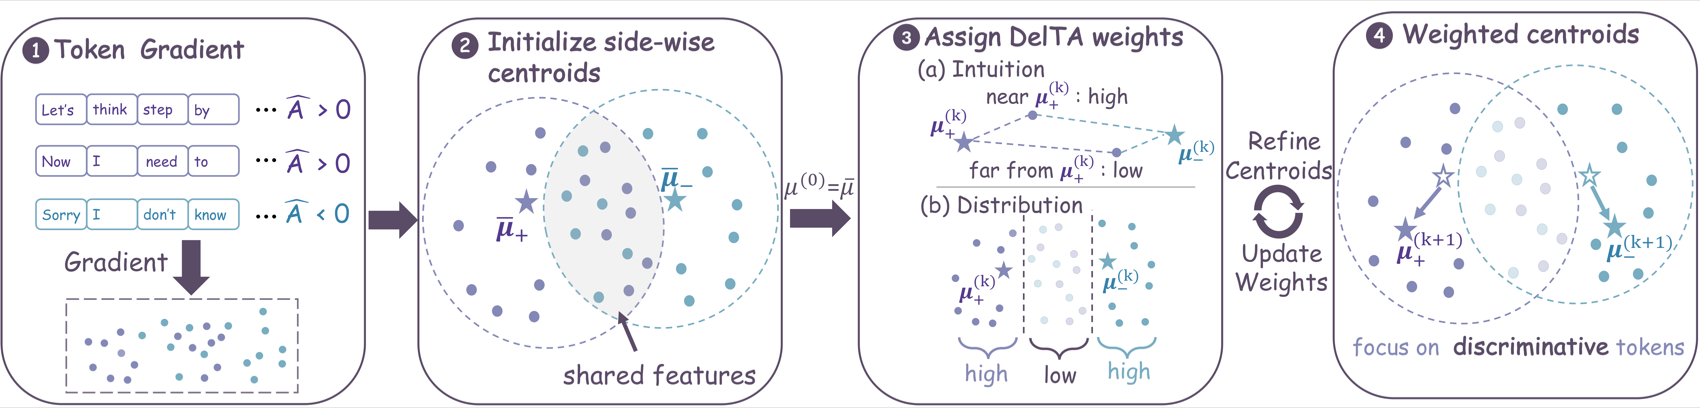
图源:DelTA 论文(来源:2026, arXiv:2605.21467)
关键结果:在 Qwen3-8B/14B 的七个数学基准上分别超越同规模最强基线 3.26 和 2.62 个百分点,并在代码生成与域外评测上均表现良好。
与本章关系:对应 10.5 节 GRPO 的奖励归因问题,从 token 粒度揭示了"序列级奖励→token 概率变化"的内在机制,为 RLVR 的细粒度优化提供了新视角。
GROW:面向开放世界 VLM Agent 的状态-动作 GRPO 框架(2026)
🧬 一句话:把多轮轨迹分解成独立"状态-动作"对,在样本间算相对优势绕开全轨迹依赖,首个把 GRPO 有效用于开放世界 VLM Agent。
核心问题:VLM Agent 在开放世界任务(如 Minecraft)上需多轮视觉感知与动作执行。但现有方法主要靠 SFT 专家示范,而 GRPO 这类先进 RL 未能有效用于多轮 RL——标准 GRPO 需全轨迹作训练样本,导致上下文过长、噪声严重。
方法介绍:GROW 把采集的轨迹分解为状态-动作样本,在样本间(而非整条轨迹内)计算相对优势,绕开全轨迹依赖;并在简化假设下理论上证明这种分解能保留 GRPO 的策略优化信号。框架见下图:
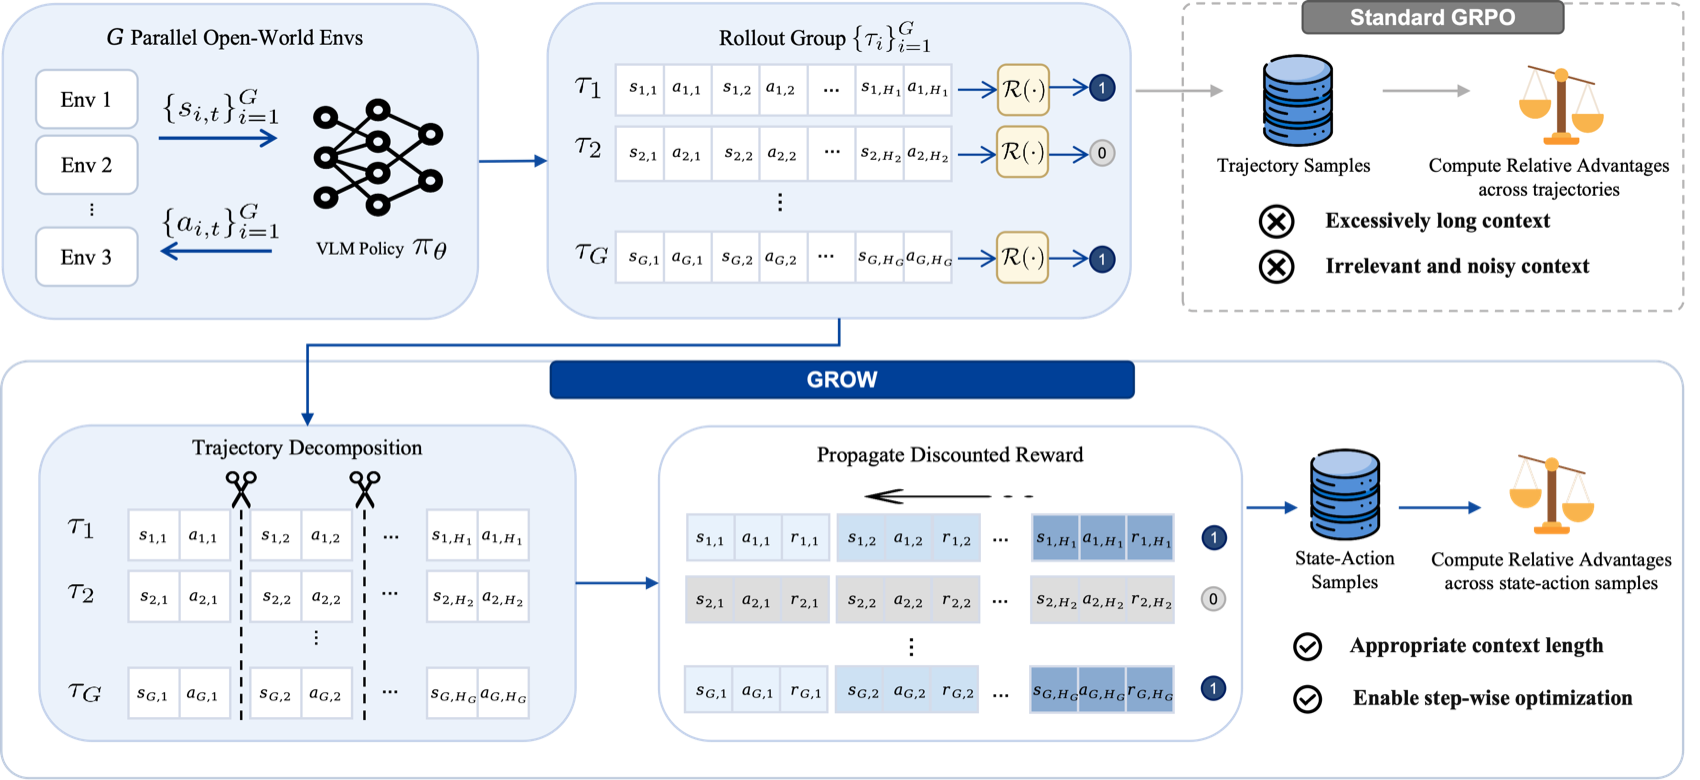
图源:GROW 论文(来源:2026, arXiv:2605.20246)
关键结果:在 800 余个 Minecraft 任务上取得 SOTA 表现,是首个有效将 GRPO 用于开放世界多轮 VLM Agent RL 训练的工作。
与本章关系:对应 10.5 节 GRPO 算法的多轮轨迹应用场景,直接解决了"完整轨迹过长"的训练瓶颈,展示了 GRPO 向视觉-语言开放世界 Agent 扩展的最新路径。
SRPO:自重置策略优化——精准信用分配提升 LLM 推理(2026)
🧬 一句话:把"重置"当信用分配原语——基模型自定位错误步骤、从该状态重采样反事实续写,靠比较续写结果精确归因,无需外部监督。
核心问题:现有 GRPO/PPO 对整条推理轨迹做均匀信用分配,忽略了"哪一步出了错"。但当前语言模型已具备足够的自定位能力,可被用作信用分配的 oracle。
方法介绍:SRPO 把重置(reset)确立为 RL 后训练的信用分配原语:基模型产生初始 rollout 失败后,自定位第一个错误 thought 并重置到该改进点,从该状态重新采样反事实后续,通过比较多条续写结果精确归因。提出 RRPO(随机重置)与 SRPO(模型自定位错误步+重置)两种变体。reset 机制见下图:
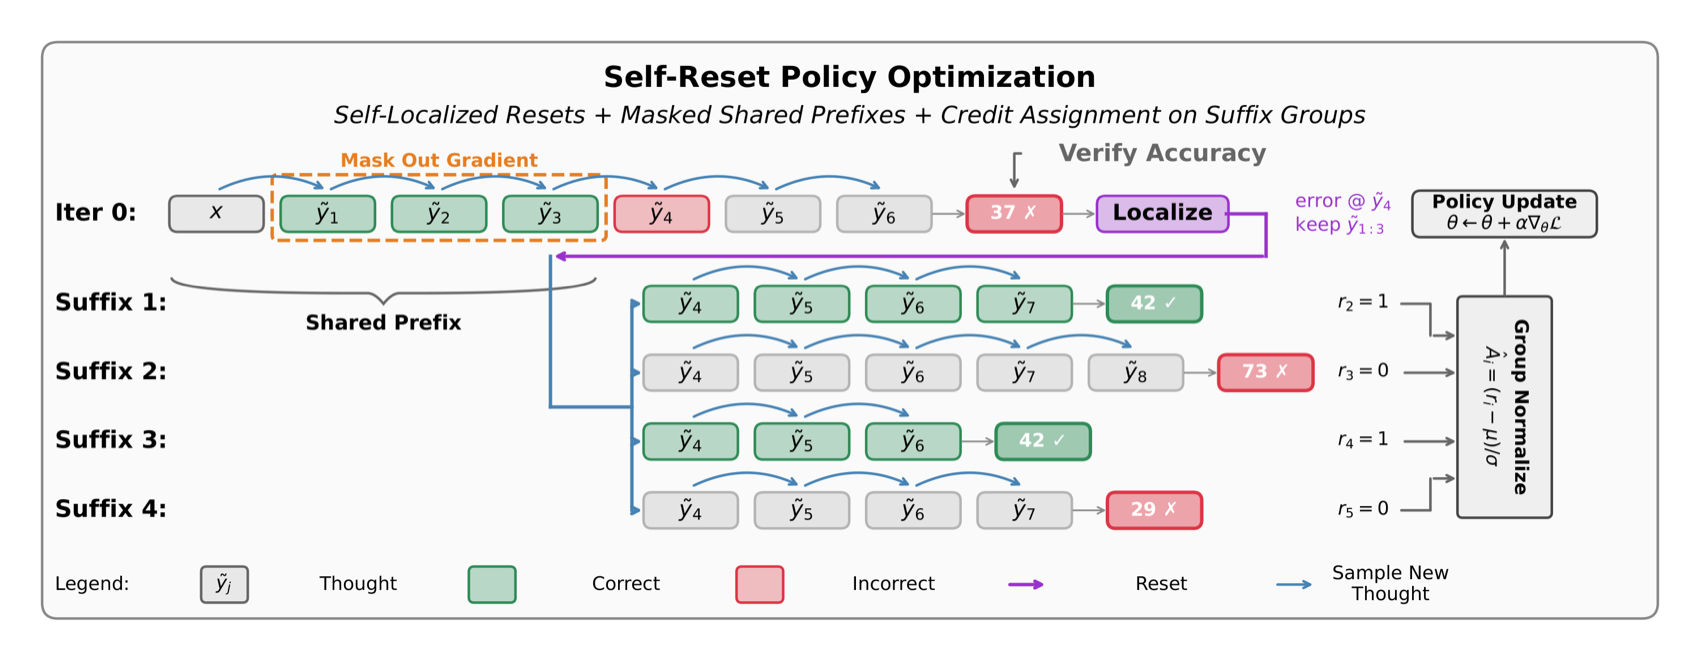
图源:SRPO 论文(来源:2026, arXiv:2605.25507)
关键结果:在五个推理基准上一致超越标准 GRPO 和 RRPO,仅利用模型自身无需外部监督;clean prefixes 的纠正率近 2× 于 erroneous ones,自定位质量是主动瓶颈。
与本章关系:对应 10.5 节信用分配难题,是对"结果奖励均匀分配至全部 token"缺陷的直接修复方案,与 DelTA 形成互补——DelTA 做 token 级加权,SRPO 做轨迹级重置采样。
ConSPO:从对比视角重新审视具有可验证奖励的强化学习(2026)
🧬 一句话:证明 GRPO 等价于加权正负分数差,揭示其"似然不对齐评分"与"分数不敏感信用分配"两大缺陷,用序列对数概率+群组 InfoNCE 对比重构。
核心问题:GRPO 是最广用的 RLVR 算法之一,但其优化目标的本质结构未被充分理解,存在被忽视的结构性缺陷。
方法介绍:本文先证明 GRPO 等价于一种加权正负分数差——对正样本提升序列分数、对负样本降低,并以裁剪后的 token 级重要性采样比率均值作评分。这揭示了两大缺陷:似然不对齐评分(优化裁剪比率代理而非真实生成似然)与分数不敏感信用分配(同组正负相对差距未被利用)。为此提出 ConSPO,用长度归一化的序列对数概率替代裁剪比率分数,采用群组级 InfoNCE 对比目标,配合课程调度边距逐步强化正负分离度。
关键结果:在多个骨干模型和数学推理基准上一致优于 GRPO 及其变体。
与本章关系:对应 10.5 节 GRPO 算法的核心机制,从对比学习视角重新定义了 RLVR 的优化目标,是对 GRPO 家族的原理性重构,与 LPO(几何统一)、DelTA(token 加权)、SRPO(轨迹重置)共同构成信用分配方向的完整研究图谱。
APPO:智能体过程式策略优化——细粒度决策点信用分配(2026)
🧬 一句话:揭示关键决策点广泛分布于全序列而非集中在工具调用处,用"分支评分+过程级优势缩放"把信用从工具边界细化到细粒度决策位置。
核心问题:Agentic RL 多在粗粒度启发式单元(工具调用边界或固定工作流)上分配信用,难以识别哪些中间决策真正影响下游结果。先导分析显示:影响性决策点广泛分布于整个生成序列而非集中在工具调用处,而 token 熵单独不能可靠反映其对最终结果的影响。
方法介绍:APPO 从两视角研究 Agentic RL,提出分支评分(结合 token 不确定性与策略续写似然增益)精准定位高价值分支点,再用过程级优势缩放把信用从粗粒度交互单元细化到序列中的细粒度决策位置。框架概览见下图:
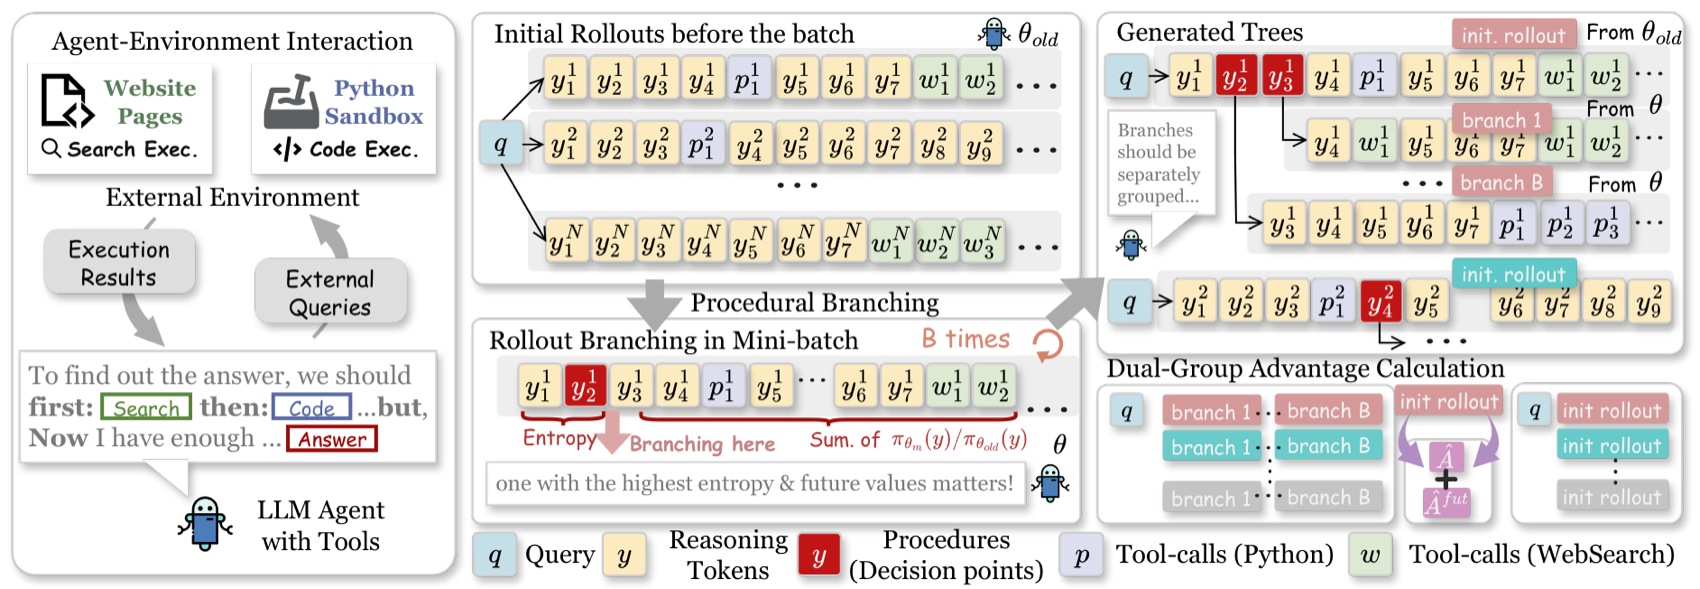
图源:APPO 论文(来源:2026, arXiv:2606.12384)
关键结果:在 13 个基准测试上相比强基线平均提升约 4 个百分点,同时保持高效工具调用。
与本章关系:对应 10.5 节信用分配难题,直接回答了"Agentic RL 中在哪里分支、如何分配信用"两个核心问题,是 GRPO/PPO 类方法在多轮工具调用场景下的最新改进,与 DelTA(token 加权)、SRPO(轨迹重置)形成方法论互补。
GraphPO:基于有向无环图的策略优化——从 Chain 到 Tree 到 Graph 的 RLVR 进化(2026)
🧬 一句话:把 rollout 建模成 DAG——推理步骤为边、语义状态为节点,合并等价路径共享后缀,效率优势归入边、正确性优势归出边,降优势估计方差。
核心问题:RLVR 有两个结构性瓶颈:独立采样响应导致大量重复推理步骤(冗余探索);稀疏最终答案奖励难以识别有价值的中间步骤(信用稀疏)。树方法靠共享前缀、比较同前缀分支提供细粒度信号,但分支仍独立扩展,相似推理状态间无法共享信息。
方法介绍:GraphPO 把 rollout 建模为有向无环图(DAG)——推理步骤为边、从推理路径总结的语义状态为节点。语义等价路径合并为等价类,允许共享后缀,把计算预算从冗余扩展重新分配到多样化探索;效率优势分配给入边、正确性优势分配给出边,从最终结果推导过程监督信号。Chain→Tree→Graph 演进见下图:
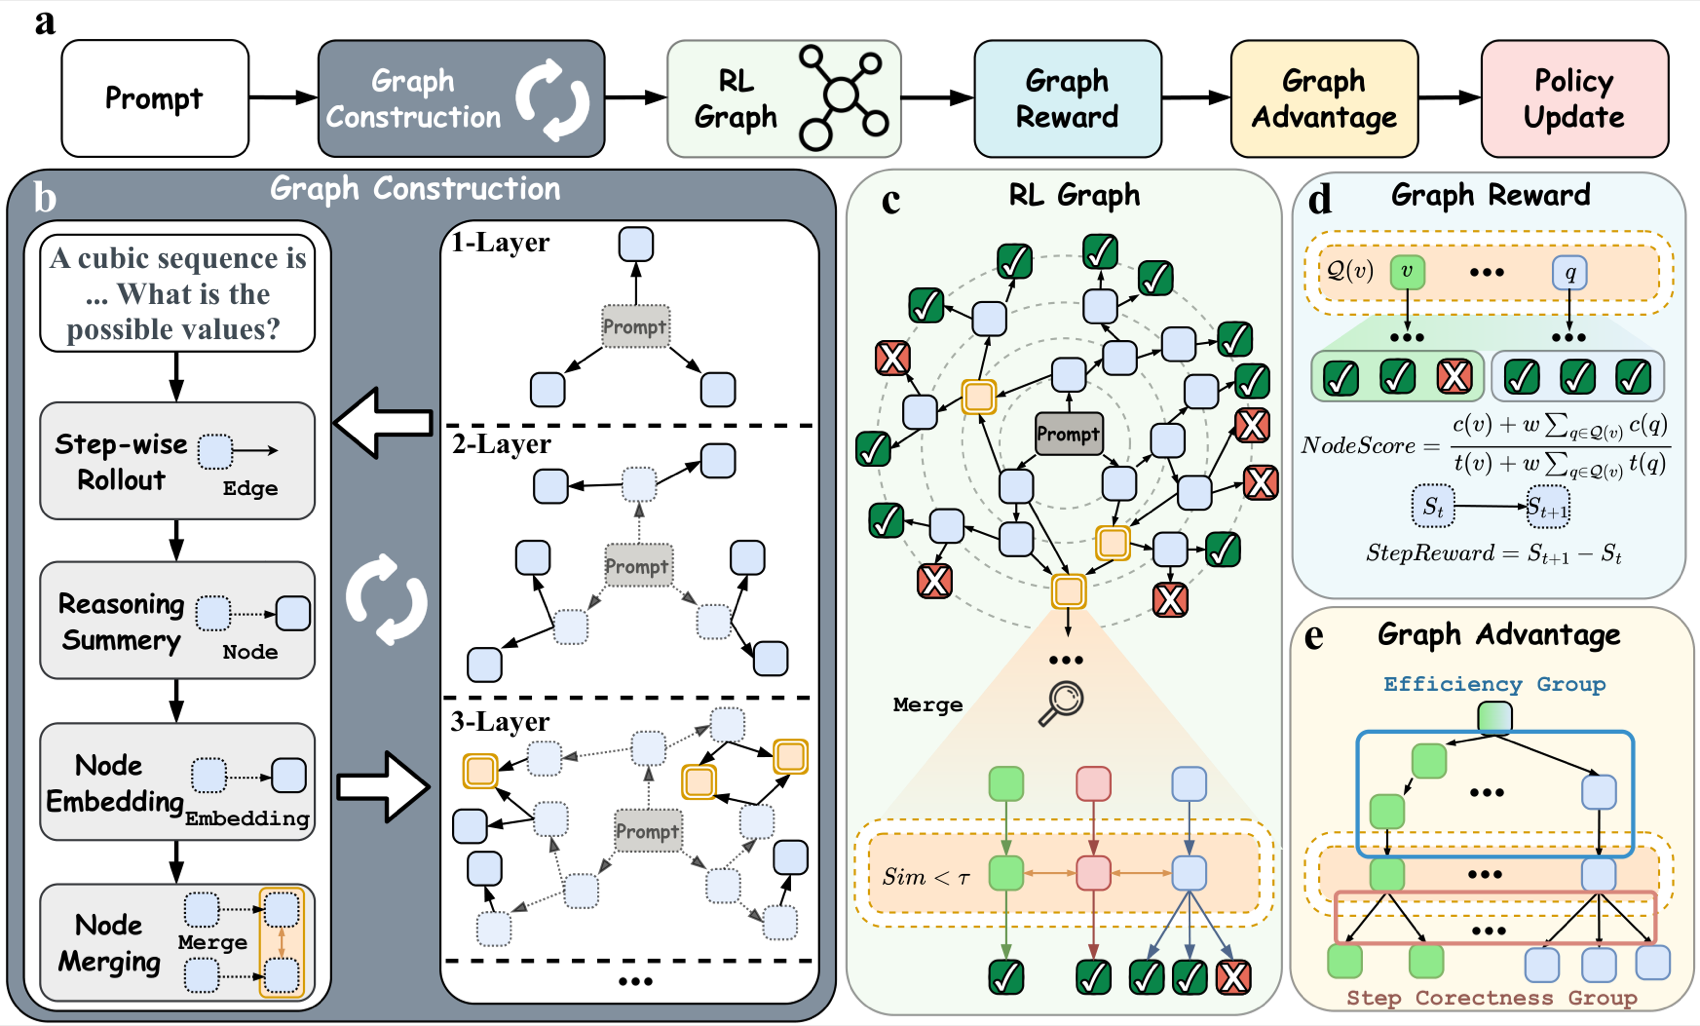
图源:GraphPO 论文(来源:2026, arXiv:2606.18954)
关键结果:理论证明 GraphPO 降低优势估计方差;在三个 LLM 的推理和 Agentic 搜索基准上,以相同 token/响应预算一致优于 chain-based 和 tree-based 基线。
与本章关系:对应 10.5 节 GRPO 算法核心机制,是 RLVR rollout 结构从链式→树式→图式的最新演进,直接解决了 GRPO 家族的冗余探索与信用稀疏两大核心缺陷,与本章已收录的 ConSPO(对比视角)、APPO(决策点视角)共同构成 RLVR 优化机制的多维研究图谱。
G2PO:面向长时程 Agentic 强化学习的群组图策略优化(2026)
🧬 一句话:把线性轨迹转成全局状态转移图,跨轨迹聚合同观测降方差,动作定义为状态节点间转移边,用边中心优势估计精准识别关键状态转移。
核心问题:长时程 Agentic RL 奖励稀疏延迟(反馈往往数十步后才来),而现有步骤级框架仍把 Agent 探索视为孤立线性轨迹,忽略状态转移的内在图结构,导致状态价值估计高方差和信用分配局部化。
方法介绍:G2PO 把线性轨迹显式转化为全局状态转移图:跨轨迹聚合相同观测(群组聚合降采样方差),把 Agent 动作重定义为状态节点间的转移边,并提出边中心优势估计——在全局图上归一化 TD 误差,精准识别驱动任务绝对进展的关键状态转移。框架概览见下图:
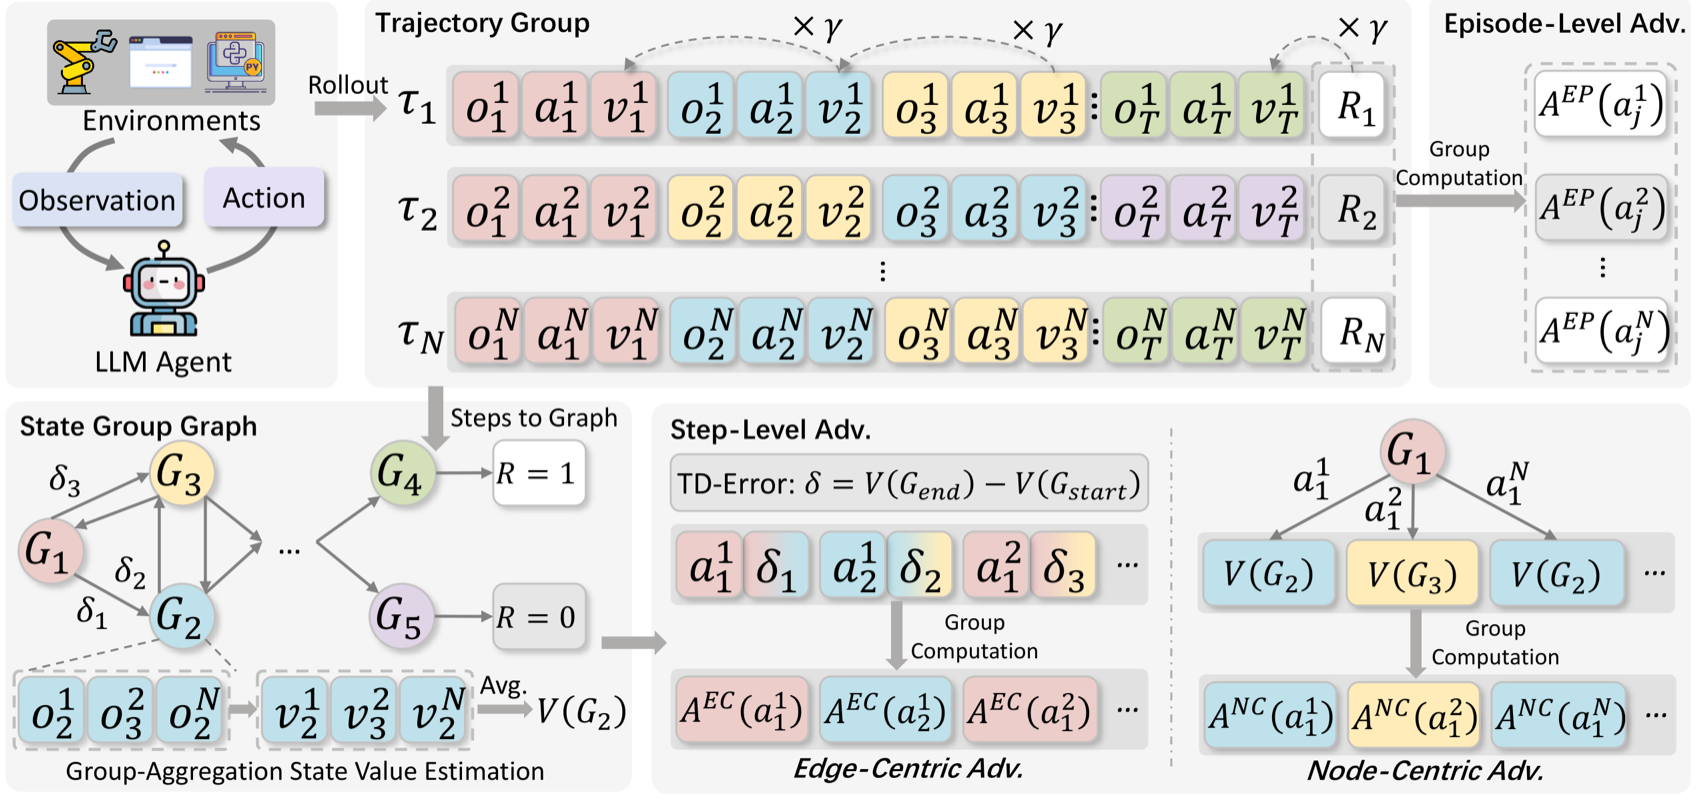
图源:G2PO 论文(来源:2026, arXiv:2606.22995)
关键结果:在 WebShop、ALFWorld、AppWorld 三个长时程基准上,G2PO 相比 GRPO 成功率最高提升 22.2%。
与本章关系:对应 10.5 节 GRPO 算法与信用分配问题,G2PO 将 group-based RL 的探索结构从线性轨迹升级为全局图,是 Agentic RL 在长时程稀疏奖励场景下的最新突破,与已收录的 SRPO(轨迹重置)、APPO(过程级分支)共同构成信用分配三视角。
单层就够?训练单一 Transformer 层可媲美全参数 RL 训练(2026)
发表:2026 年 7 月 1 日 | arXiv:2607.01232
核心贡献:本文系统研究 RL 后训练增益在 Transformer 各层的分布规律,发现训练单一 Transformer 层即可复现全参数 RL 训练的绝大部分增益,有时甚至超越全参数训练。引入"层贡献度"指标,覆盖 Qwen3/Qwen2.5 两个模型系列、GRPO/GiGPO/Dr. GRPO 三种算法、数学推理/代码生成/Agentic 决策等多域,揭示出一个高度稳定的结构规律:RL 增益集中在 Transformer 栈中间层,输入和输出两端贡献极低,且这一层级结构跨数据集、任务、模型家族和 RL 算法具有强相关性。
与本章关系:对应 10.5 节 GRPO/RLVR 算法机制,揭示了 RL 后训练本质上是对少数关键层的集中修改,为计算效率优化和模型可解释性研究提供了全新视角,也间接支持了 Agentic 任务中层级特化现象的理论探讨。
GRPO、Dr. GRPO 与 DAPO 是同一数字的三种操作:组标准差恒等式(2026)
发表:2026 年 6 月 30 日 | arXiv:2607.00152
核心贡献:本文证明了三种最流行的 LLM 推理训练方法(GRPO、Dr. GRPO、DAPO)在数学上是同一操作的三种变体:它们都调节同一个数字——组标准差,即对同一问题多次采样的答案正确性分布的离散程度。GRPO 除以标准差、Dr. GRPO 去掉该除法、DAPO 丢弃标准差为零的组,本质上是同一"旋钮"的不同设置。提出"组标准差恒等式"(GSI):对于正确/错误奖励,标准差直接等于训练更新量的大小——分歧均等的问题更新最大,全员正确或全员错误的问题贡献为零。在 Big-Math 大型难度数据集和受控训练实验中验证了这一分析,揭示了 RLVR 方法在调参和问题加权中的共同本质。
与本章关系:对应本章「GRPO 算法原理」与「RLVR 训练机制」知识点,GSI 为三种主流强化学习算法提供了统一的理论视角,有助于从本质上理解各算法的适用场景和调参直觉,是 RL 训练机制可解释性研究的重要理论成果。
SAO:面向 Agentic RL 的单次异步优化——GLM-5.2 生产训练管线(2026)
发表:2026 年 7 月 8 日 | arXiv:2607.07508
核心贡献:本文提出单次异步优化(SAO),解决异步 RL 中的离策略(off-policy)偏差与训练不稳定问题。核心创新有三:(1) 用单次采样(每条 prompt 只做一次 rollout)替代 GRPO 的组级采样,减少异步管线中的 off-policy 漂移;(2) 引入严格双侧 token 级裁剪策略,掩盖发散更新以提升优化稳定性;(3) 增强值模型训练设计(值模型快于策略更新、跳过观测的 GAE)。SAO 已实际部署于开源 GLM-5.2(750B-A40B MoE)的 Agentic RL 训练管线,稳定训练上千步,在 SWE-Bench Verified(29.8%)、BeyondAIME、IMOAnswerBench 上一致超越 GRPO 及其变体。
与本章关系:对应 10.5 节 GRPO 算法与异步训练知识点,SAO 是首个在生产级千亿参数模型上验证可行的异步 Agentic RL 方法,揭示了组级采样在长时程 Agent 任务中的效率瓶颈,为大规模 Agent RL 训练提供了新的工程范式。
SEED:面向 Agentic 强化学习的自进化同策略蒸馏(2026)
发表:2026 年 7 月 16 日 | arXiv:2607.14777
核心贡献:SEED 针对 Agentic RL 的核心痛点——基于结果的稀疏奖励无法指导中间决策——提出"后见技能蒸馏"机制:先从已完成的同策略轨迹中提炼出自然语言"后见技能"(成功轨迹提取可复用工作流、失败轨迹提取纠错规则),再将技能引导下的动作概率变化转为稠密 token 级训练信号,与 GRPO 联合优化。训练闭环使技能分析与策略更新共同进化,无需外部记忆或额外模型。在文本和视觉 Agentic 基准上持续提升性能与样本效率,并展现对未见场景的鲁棒泛化。
与本章关系:直接对应本章「Agentic RL 中的信用分配」与「稀疏奖励下的监督信号」知识点,SEED 将后见视角引入在线 RL 优化,与已收录的 SRPO(重置信用)、APPO(过程级奖励)、DelTA(token 级加权)共同构成从"结果→路径→步骤→后见"的四维信用分配图谱。
TCR:面向 RL 偏好对齐的思维清单过程奖励(2026)
发表:2026 年 7 月 22 日 | arXiv:2607.19824
核心贡献:当前基于 RL 的偏好对齐方法大多依赖结果级奖励,主要评价最终回应而对推理轨迹提供有限引导——当多条回应得到相似最终分时,信用分配将变得粗粒化。本文提出 TCR(Thinking Checklist Reward),一种针对 RL 偏好对齐的过程导向奖励:将偏好对自动转化为样本特定的"思维清单",用于评估生成推理轨迹是否覆盖了偏好暗示的关键考量。为减少与结果级监督的重叠,TCR 进一步引入指数移动平均残差公式(EMA 残差),从结果奖励可预测的部分中隔离出互补的"思维盈余"。在来自三个模型家族的五个模型上,TCR 在多样化基准上一致提升对齐性能,消融实验进一步验证了 EMA 残差公式与样本特定清单监督的重要性。
与本章关系:直接对应本章「RLVR 训练信号设计」与「信用分配」知识点,TCR 将过程奖励从"步骤级正确性验证"拓展到"推理过程覆盖度检查",与已收录的 DelTA(token 加权分配)、SRPO(轨迹重置)、APPO(过程级优势分支)共同构成从结果到过程的信用分配方法图谱,是偏好对齐方向将思维链"可评估化"的最新尝试。
ESTR:熵缩放信任区域——解决异步 RL 中 Off-Policy 偏差的精准校正方法(2026)
发表:2026 年 7 月 24 日 | arXiv:2607.22186
核心贡献:异步 RL 通过将 rollout 生成与策略优化重叠来加速训练,但由此产生的陈旧 off-policy 数据会破坏优化稳定性。现有方法对所有 token 位置均匀应用重要性比率阈值,忽视了一个关键规律:重要性比率的自然尺度随 token 熵系统性变化——低熵 token 下训练-推理差异被大幅放大,高熵 token 下在途权重更新本身就会引发合理的探索偏差。ESTR(熵缩放信任区域)对每个 token 的 off-policy 偏差按其局部熵缩放,无需辅助前向传递或显式版本切换检测。与同步 GRPO 相比,ESTR 在长时程 Agentic 任务和数学推理基准上获得相当精度,训练速度提升 2.6×,是迄今为止同步与异步 RL 方法中训练-推理一致性最优方案。
与本章关系:直接对应本章「GRPO 算法机制」与「异步 RL 训练优化」知识点,ESTR 从 token 熵视角重新诠释了重要性采样的校正尺度,与已收录的 SAO(单次采样管线)、SEED(后见蒸馏)形成"采样策略→训练信号→稳定性校正"的 Agentic RL 工程三维图谱。
ODYSSE:情节级 GRPO——面向个性化 Agentic 推理的强化微调框架(2026)
发表:2026 年 7 月 28 日 | arXiv:2607.25369
核心贡献:现实场景中用户请求往往模糊、解空间开放,Agent 需同时与用户和环境多轮交互来推断个性化偏好——这是"个性化 Agentic 推理"的核心挑战。ODYSSE 提出 ESPO(Episode-wise GRPO):不像标准 GRPO 独立优化每一步,ESPO 引入情节级奖励机制与情节优势估计,让上游证据有效引导下游个性化决策,使 Agent 在多轮交互中渐进解析模糊请求。配套的情节批次采样器将同一情节的动作分组进统一训练批次,确保 ESPO 下的一致优化。在长时程个性化 GUI 推理任务上,ODYSSE 持续优于专用模型和通用 LVLM。
与本章关系:直接对应本章「GRPO 算法原理」与「长时程 Agentic RL」知识点,ESPO 将 GRPO 的优势估计从"单步独立"升级为"跨步情节联合",是将 RLVR 用于需要多轮用户-环境交互的个性化场景的最新突破,与已收录的 SAO(异步管线)、SEED(后见蒸馏)共同拓展了 Agentic RL 的应用边界。
KGPS:卡尔曼滤波驱动的 RL 微调动态提示选择框架(2026)
发表:2026 年 7 月 30 日 | arXiv:2607.27610
核心贡献:RL 微调的效果高度依赖提示难度与当前策略水平的匹配程度,但现有方法面临两难:基于评估的方法精确但昂贵,基于预测的方法高效但假设难度静止——与RL 非平稳训练动态不符。KGPS(Kalman-Guided Prompt Selection)将提示选择重构为动态状态估计问题:用线性高斯状态空间模型在logit 空间对每个提示的隐含成功率建模,过程噪声与策略更新幅度耦合(策略变化越大不确定性越高),卡尔曼滤波维持校准的后验,按最大化后验期望训练效用(偏好中等难度提示并自然重访不确定提示)选择样本。跨数学、规划、几何推理基准及多种RL 算法,KGPS 在最终精度和rollout 效率上持续优于强基线:DeepSeek-R1-Distill-7B 上比DS少用 83% rollout,六项数学基准平均性能提升 0.12分。
与本章关系:直接对应本章「GRPO 训练效率」与「RL 微调工程优化」知识点,KGPS 从课程设计角度解决了 RL 非平稳训练中"何时用什么难度提示"的核心问题,与已收录的 SAO(管线异步化)、ESTR(熵缩放校正)共同构成 Agentic RL 训练效率三要素:采样策略、稳定性校正、课程选择。
开始分类:用于 LLM 强化学习的类别型 Critic(2026)
发表:2026 年 8 月 4 日 | arXiv:2608.02181
核心贡献:PPO 在 LLM 后训练中的 Critic 传统上用连续值估计状态价值,但连续回归目标与奖励的实际分布之间存在错配——奖励往往只取稀疏的离散值(成功/失败、步骤级评分),迫使连续 Critic 过度平滑,导致训练方差大且收敛慢。本文将 Critic 替换为类别型 Critic:将价值分布离散化为若干区间,用分类交叉熵训练,从而更准确地建模奖励的实际分布形状。类别型 Critic 在几乎不增加额外计算的前提下,在 PPO 和 RLVR 两种训练范式下均提升了训练稳定性与校准性,是 LLM 强化学习后训练的一项务实工程改进。
与本章关系:直接对应本章「PPO 算法原理」与「RL 训练稳定性」知识点,类别型 Critic 从Critic 设计视角补充了 GRPO 系列(通过组内相对优势绕开 Critic)之外的另一条训练改进路径,与已收录的 ESTR(熵缩放稳定性)、KGPS(课程选择)共同指向Agentic RL 训练信号质量的多维优化。
TRCA:面向长时程 LLM Agent 的逐转换 Rubric 信用分配(2026)
发表:2026 年 8 月 17 日 | arXiv:2608.16156
核心贡献:长时程 LLM Agent 通常依赖稀疏终态奖励做优化,多步交互中的细粒度信用分配极为困难。现有方法要么依赖过程评估器(标注成本高)、要么从成功轨迹派生步骤信用(早期训练阶段成功轨迹极稀缺)。TRCA(逐转换 Rubric 信用分配)提出无需学习评估器或成功锚点、直接从动作引发的状态转换推导步骤级监督:用**证据(Evidence)、执行(Execution)、无效(Invalidity)**三类 Rubric 评估每次转换质量——基础 Rubric 奖励衡量局部转换质量,突破 Rubric 奖励追踪新覆盖的证据与执行条件奖励增量进展。结合终态奖励,在 ALFWorld、WebShop 及七项搜索增强 QA 基准上持续超越基线:Qwen2.5-7B 上 WebShop 分数提升 6.0%–12.6%,Qwen2.5-3B 上 SearchQA 平均提升 1.9%–18.3%。
与本章关系:直接对应本章「RL 信用分配」与「长时程 Agent 优化」知识点,TRCA 无需成功轨迹锚点即可实现步骤级信用分配,是继 DelTA(token加权)、SRPO(自重置)之后信用分配方法链上的最新成果——专门解决早期训练阶段成功轨迹极稀缺的"冷启动"挑战。
SPADE:自博弈自适应可执行环境中的 Agent RL 持续自进化(2026)
发表:2026 年 8 月 19 日 | arXiv:2608.19197
核心贡献:Agent RL 后训练的瓶颈从"缺算法"转向"缺可交互、难度合适的环境"——手工构建慢、静态合成池被模型迅速刷完。SPADE 让同一个 LLM 交替扮演环境设计者(Environment Designer)与推理 Agent(Reasoning Agent):设计者以 OpenAI Gym 风格输出完整可执行 Python 环境(含状态转移、奖励函数和验证代码),Agent 在其中训练;设计者的奖励是"有提示回报与无提示回报之差(hint-based regret)",确保生成的环境始终对准 Agent 当前能力边缘——"有提示能做、没提示不会"的前沿任务。Qwen3-30B-A3B 在 8 个未见推理/代码基准上均值提升 +8.1 分,优于最强固定环境基线 +5.3 分;多步工具调用场景下 ACEBench-Agent 提升 +13.9 分,增益随模型规模扩大。
与本章关系:直接对应本章「Agentic RL 训练环境」与「自进化 Agent」知识点,SPADE 将训练环境从静态资产变为可学习组件,打通了"环境生成 → Agent 训练 → 环境更新"的闭环,是继 EnvHarness(将已有静态环境改造为可交互训练环境)同方向的最新突破——SPADE 侧重从零生成并自适应更新课程,代表 Agentic RL 可扩展性研究的前沿方向。
LEGO-RL:Coding Agent 的原生 Harness 强化学习框架(2026)
发表:2026 年 8 月 18 日 | arXiv:2608.17393
核心贡献:对 Coding Agent 做强化学习训练时,现有框架需要重新实现 Agent 的执行环境,导致训练环境与部署环境之间出现严重的行为偏差(train-inference discrepancy)——Harness 侧的历史改写、上下文压缩等操作会破坏 rollout 与策略更新之间的概率对齐,而奖励伪造(reward hacking)更会污染训练信号。LEGO-RL 提出无需修改 Harness 内部控制流的解决方案:通过进程内 LLM 代理(in-process LLM proxy)拦截模型 API 层的原始 token 流,捕获精确的 token ID、mask 和对数概率,确保 rollout-training 概率相关性保持在 0.99 以上;同时通过镜像缓存和分阶段防伪造机制提供可靠的沙盒执行。支持 PPO/GRPO/GSPO 算法,兼容 OpenHands、Claude Code、OpenCode 三种主流 Coding Agent Harness。在 SWE-bench Verified 上训练 Qwen3.5-35B-A3B:OpenHands SDK 64.0%→70.4%,Claude Code 62.4%→68.2%,OpenCode 57.2%→66.6%。
与本章关系:直接对应本章「Agentic RL 训练框架」与「策略梯度算法工程实现」知识点,LEGO-RL 解决了在真实 Coding Agent Harness 中做 RL 训练的关键工程挑战——train-inference 偏差与奖励伪造,是将 GRPO/GSPO 等算法应用到实际软件工程 Agent 的重要基础设施,与已收录的 SPADE(训练环境生成)和 LEGO-RL(Harness 侧对齐)共同指向"如何让 Agentic RL 在真实复杂环境中可靠运转"这一核心工程问题。
Agent Lightning v1.0:无需重实现 Agent 循环的 Harnessed Agentic RL 框架(2026)
发表:2026 年 8 月 18 日 | arXiv:2608.17528
核心贡献:现有 RL 训练框架(verl、OpenRLHF 等)要求把整个 Agent 循环搬进训练器重新实现,导致 OpenHands、LangChain 等成熟 Agent Harness 无法直接复用,且训练环境与部署环境之间产生行为偏差。Agent Lightning v1.0(Microsoft)提出 Harnessed Agentic RL 范式:在 Harness 与推理服务之间插入一个 OpenAI 兼容代理(agl-server),将每次模型调用记录为训练事件并聚合成"call sequence → training row";Rollout Controller 管理并发任务调度,Customized Trainer 在 verl 后端上实现基于 GRPO 的策略优化,整个 Harness 无需任何改动。在 SWE-bench Verified 上训练 mini-SWE-agent 验证,支持 GRPO 及异步/分离式 rollout。
与本章关系:直接对应本章「Agentic RL 训练框架」与「Harness 架构」知识点,Agent Lightning v1.0 的核心创新是把"训练引擎"与"Agent Harness"解耦——通过 API 代理层而非代码侵入实现 RL 闭环,与已收录的 LEGO-RL(进程内代理拦截)形成互补,共同指向"在真实 Harness 上做 RL 训练"的工程方向。
BPCO:用精心设计的 Critic 替代 GRPO 多采样的稳定 RL 配方(2026)
发表:2026 年 8 月 24 日 | arXiv:2608.23566
核心贡献:GRPO 通过对同一 prompt 采样多个回复来估计基线,规避了 Critic 训练不稳定的问题,但每步需要多次 forward pass,成本高昂。BPCO(Best Practice Critic Optimization)研究 Critic 不稳定的根因,提出五个关键设计选择组合:将 value 预测钳制到奖励范围内、使用 Monte Carlo 价值目标、不归一化策略优势、长度自适应 GAE,以及在训练时让 Critic 额外接收参考答案或评分细则(policy 看不到)。在 1.5B 到 30B-A3B MoE 的数学推理任务上,BPCO 单采样回复就能匹配或超过 GRPO 多采样基线,同时支持基于评分细则的奖励。
与本章关系:直接对应本章「GRPO 算法原理」与「价值函数估计」知识点,BPCO 从工程视角揭示了让 Critic 在 LLM RL 训练中稳定运作的关键设计空间,为"一次采样即可训练"提供了可靠实现路径,是理解 PPO/GRPO 权衡的重要参照。
非英语推理训练的代价远被高估:200 组 GRPO 实验揭示多语言推理新规律(2026)
发表:2026 年 8 月 27 日 | arXiv:2608.13698
核心贡献:此前研究普遍认为用非英语语言做 GRPO 推理训练代价太大(中文 vs 英语差距超过 10 个百分点),导致非英语团队被迫走"英语推理"路线。Apple 与 HPI 联合在 9 个基座模型、11 种语言上进行了超过 200 组 GRPO 强化学习推理训练实验,发现:中文母语推理训练与英语训练的性能差距仅 1.1 个百分点;高资源语言(法语 1.4、德语 1.7)差距均在 2 点以内;低资源语言(孟加拉语 5.7)差距较大。同时发现跨语言迁移广泛有效——西班牙语单语训练后法语性能恢复目标语言直接训练增益的 96%,但特定模型-语言组合可能触发极端性能塌方。
与本章关系:直接对应本章「GRPO 算法实践」与「推理模型训练」知识点,本文从多语言视角提供了 GRPO 训练规律的重要补充——中文推理模型从训练阶段就可以走独立路线,不需要强制用英语中间思维链,对理解 GRPO 的泛化特性和实际工程选择具有直接参考价值。
并行分布式推理语言模型的性能基础(2026)
发表:2026 年 8 月 27 日 | arXiv:2608.14000
核心贡献:RLVR 训练 RLM(DeepSeek-R1、o3、Kimi k1.5 等)的计算规模已远超经典监督训练:需要同时维护 Actor、Critic、Reference 和 Reward 四个模型,形成紧耦合多模型流水线,使训练既是算法问题也是分布式系统问题。本文系统化 RL-for-LLM 范式,对 PPO、GRPO 及其变体进行计算量化分析,建立模型内/间并行策略分类(涵盖传统数据/张量/流水线/序列/专家并行,以及 disaggregated placement、stage fusion、hybrid parallelism 等多模型 RLM 专用新形式),用并行计算的工作-深度模型使分类严格可移植,并给出构建可扩展 RLM 训练系统的实用指南和开放研究方向。
与本章关系:直接对应本章「PPO 与 GRPO 工程实现」与「Agentic RL 训练系统」知识点,本文是理解 RLM 训练为何在工程层面极具挑战的系统性参考——PPO 需要四模型协同的原因、GRPO 省去 Critic 带来的并行化简化,在本文的计算量化分析框架下可以直接量化对比。
GRPO 中的虚假优势:SignBalance 修正边界答案与搜索 Agent 的梯度失真(2026)
发表:2026 年 9 月 3 日 | arXiv:2609.04063
核心贡献:GRPO 的优势估计器在两类场景下存在系统性缺陷:有界答案任务(如多项选择)中,随机猜测以 1/N 概率命中正确答案,与精确推理获得相同的正梯度;多步搜索 Agent 中,宽动作预算的无效探索路径同样可能偶然命中答案,积累虚假正向梯度。这种"虚假优势"使模型在训练中学会靠猜测而非推理。SignBalance(RIT + Adobe Research)只保留验证器的符号(方向),引入全局缩放常数和每类 stop-gradient 重缩放,彻底解耦优势幅度与组内正确率之比。在数学推理与搜索 Agent 基准上,SignBalance 对有界答案任务和复杂搜索场景均持续超越 GRPO,标准开放数学基准上与 GRPO 持平。
与本章关系:直接对应本章「GRPO 算法原理」与「优势估计设计」知识点,揭示了 GRPO 被普遍忽视的系统性缺陷——当 Agent 面临多选任务或多步搜索时,outcome-only 奖励信号会把"幸运猜对"当作"真实推理"来强化,SignBalance 是迄今最轻量的修正方案,对工程实践中使用 GRPO 做 Agent 后训练具有直接指导意义。
DRACO:动态评分细则与闭式信用分配,破解长 Horizon Agent 的 GRPO 训练难题(2026)
发表:2026 年 9 月 3 日 | arXiv:2609.04094
核心贡献:RLVR 在有程序验证器(如数学、代码执行)的任务上效果显著,但大多数长 Horizon Agent 任务无法用程序化检查器验证——轨迹级人工判断既主观又缺少步骤级梯度信号。DRACO 提出两项创新:① 动态评分细则生成(Dynamic Rubrics)——为每条轨迹自动生成任务特定的评分维度,结构化评判每步动作质量;② 闭式信用重分配——将轨迹级 GRPO 优势以数学封闭形式重新分配至每个动作步骤,无需额外模型或 Critic。在软件工程、网页导航和多模态长 Horizon 任务上均验证有效,在无程序验证器场景下显著优于直接使用 GRPO。
与本章关系:直接对应本章「长 Horizon Agent 训练」与「奖励信号设计」知识点,DRACO 弥补了 GRPO 从"可验证任务"扩展到"需要判断性评分的复杂 Agent 任务"时的核心缺口——动态评分细则解决了"缺少程序验证器怎么办",步骤级信用分配解决了"轨迹级奖励梯度无法传播到关键决策步",是 RLVR 向复杂 Agent 任务推广的重要进展。
NeoHorse-1:将路由 Harness 运行记录转化为训练课程,实现 Agent 递归自我改进(2026)
发表:2026 年 9 月 8 日 | arXiv:2609.08183
核心贡献:TokenRhythm 联合 CUHK、NTU 等机构提出 NeoHorse-1:将部署中多模型路由 Harness 自动记录的「预测能力需求→实际派给哪级模型→后续交互结果」直接转化为分阶段训练课程(课程 SFT + on-policy 蒸馏),4B 模型十项基准宏平均从 58.94 拉升至 64.87,9B 模型从 65.60 拉升至 69.04;开源权重(Apache-2.0)完整释出,发布三天内获 HuggingFace 384 个 upvotes,为当日所有论文最高。核心洞见:路由 Harness 内建了能力边界观察机制——哪类任务被向上路由到更强模型、最终交互结果如何,本身就是分层能力信号,无需额外设计环境。
与本章关系:直接对应本章「Agentic 后训练」与「Agent 自我改进」知识点,NeoHorse-1 演示了 GRPO/PPO 之外的一条 Agent 能力提升路径——把已在线上运行的路由 Harness 变成持续的训练信号来源,是"Harness-mediated self-improvement"方向的首个具体实现,对已经部署多模型服务层的团队具有直接可复制的参考价值。
T1:面向长时程任务的终端智能体强化学习(2026)
发表:2026 年 9 月 10 日 | arXiv:2609.11042
核心贡献:腾讯 Hy 基础模型前沿等机构提出 T1——122B 总参数 / 10B 激活的混合专家(MoE)模型,以强化学习驱动真实云端沙箱 Shell,每任务最多执行超 300 次工具调用,奖励信号来自任务自带的隐藏验证器。训练关键技术包括:TITO(精确使用采样 token 标识符训练、在回合边界修复漂移)和 R3(回放 MoE 层的专家路由选择,对齐训练与推理的 token 分配)。评测结果:在 Terminal-Bench 2.1 上,基础模型 43.8% → SFT 49.4% → RL 后 64.0%(后训练相对提升 46.1%);Long-Horizon Terminal-Bench 达 27.9%,超越 GPT-5.4 和 GLM-5.1;训练语料与测评集完全隔离,确保结果反映真实泛化能力而非基准泄漏。
与本章关系:直接对应本章「RL 后训练工程实践」与「长时程 Agent 奖励设计」知识点,T1 提供了迄今为止规模最大的「RL 训练终端 Agent」公开食谱——MoE 专家路由如何在 RL 梯度下保持训练-推理对齐(TITO + R3),以及密集过程奖励如何在 300 步以上的长轨迹中提供稳定梯度信号,是 Agentic RL 从数学/代码任务向现实操作系统级长时程任务扩展的关键参考案例。
Dream-RSI:在持续演化的世界中实现智能体递归自我改进(2026)
发表:2026 年 9 月 16 日 | arXiv:2609.14858
核心贡献:DeepMind 提出 Dream-RSI(Recursive Self-Improvement Through Evolving Worlds):将递归自我改进循环嵌入持续演化的模拟世界,而非依赖人工标注数据。系统周期性地使用已付费生成的历史轨迹构建策略模拟器——每次真实探索运行后,将探索历史组织成发现树;候选探索策略直接在发现树上离线回放,读取已记录节点结果,零额外执行成本评估数千种策略变体。通过"冻结模型权重、只演化调度策略代码"的核心设定,Dream-RSI 将递归自我改进解耦为探索阶段(在线)和策略优化阶段(离线),使团队无需访问模型内部或修改权重即可持续迭代 Agent 能力。
与本章关系:直接对应本章「Agent 自我改进」与「Agentic RL 训练范式」知识点,Dream-RSI 展示了一条"不动权重、只演化编排层"的 RL 替代路径——历史轨迹树既是模型的执行记录,也是策略优化的零成本模拟器;对无法访问模型参数或微调成本高昂的工程团队,这是一条直接可复制的持续改进思路。
ActObs:对环境观测 Token 施加 SFT 监督,改变 GRPO 后探索方式(2026)
发表:2026 年 9 月 17 日 | arXiv:2609.20715
核心贡献:标准 Agent SFT 只对动作 token 施加损失,将环境观测 token 作为上下文但不作为预测目标——ActObs 仅改变 SFT 损失掩码,让模型同时预测轨迹中已有的观测 token,无需额外数据、参数或前向传播。两种方式在 SFT 阶段表现相近,但 GRPO 后分叉明显:在 Qwen3-4B 上,ActObs-GRPO 在 Terminal-Bench 2.0 每个采样预算下均高于仅动作监督的基线;在 4B 跨域代码编辑任务(aider-polyglot,训练中从未见过)的 pass@1 提升 +4.2pp。机制解释:动作梯度与观测梯度在 SFT 早期迅速正交化,仅动作监督会破坏模型对环境后果的预测能力并压低基模型水平;ActObs 保留了这一能力,使 GRPO 能以更少的策略移动维持更高熵,从而保留更广泛的动作可探索空间。
与本章关系:直接对应本章「GRPO 训练工程」与「SFT 初始化对 RL 的影响」知识点,ActObs 把 SFT 损失掩码设置定义为一个影响 GRPO 探索能力的上游设计决策——只需一行损失掩码改动,即可在不增加任何计算开销的前提下提升 GRPO 的 pass@k 多样性;是 Agentic RL 团队在下一次 RL 运行前值得审计的配置项。
ConSPO:对比序列级策略优化,从对比学习视角重构 GRPO(2026)
发表:2026 年 5 月(EMNLP 2026 Main Conference 录用)| arXiv:2605.12969
核心贡献:北京理工大学与阿里巴巴 Qwen 团队将 GRPO 重新表述为"加权正负辨别目标",从而揭示两个结构性缺陷:①似然未对齐评分——优化的是截断 token 级重要性采样比率而非生成似然;②对分数不敏感的信用分配——组内信用不反映正负 rollout 之间的当前分数差距。ConSPO 用长度归一化序列对数概率替代截断比率分数,并优化组内 InfoNCE 风格目标,使正 rollout 与组内负样本对比,并加入课程调度边距(训练早期粗粒度正负排序,后期强化分离压力)。在多种基础模型、参数量和训练数据上持续超越 GRPO 等强基线。
与本章关系:直接对应本章「GRPO 算法原理与局限」知识点,ConSPO 从对比学习视角揭示了 GRPO 的两个被忽视的目标层缺陷,为理解"为什么 GRPO 在某些设置下效果不稳定"提供了清晰的理论解释,是 RLVR 算法演化脉络(PPO→GRPO→DAPO/GSPO/ConSPO)中最近一个有 EMNLP 主会背书的节点。
高效推理奖励提升推理模型对欠规范任务的弃答能力(2026)
发表:2026 年 9 月 21 日 | arXiv:2609.20846
核心贡献:现代大型推理模型(LRM)在可回答任务上表现出色,但对"信息不足、无法作答"的任务往往不知道弃答——反而生成比可回答任务更长的思维链,浪费算力。研究对比了人类与 LRM 在欠规范任务上的推理投入,发现人类对不可回答任务的推理量上界于可回答任务,而 LRM 正好相反。受资源理性认知科学启发,论文设计了一种新颖的 GRPO 奖励,鼓励模型在生成推理链时高效判断"当前任务是否有足够信息求解"。对多个 4B 推理模型进行微调后,弃答性能平均提升 +12.8%,思维链平均缩短 44%,且模型在可回答任务上的正确率保持不变。
与本章关系:直接对应本章「奖励信号设计」与「推理模型后训练」知识点,本文将"知道什么时候不该回答"纳入 GRPO 奖励建模范畴——推理模型的弃答能力不是内置的,而是需要专项奖励信号显式培养;与已收录的 DRACO(长 Horizon 动态评分细则)和 ActObs(损失掩码设计对 GRPO 探索的影响)共同构成"奖励工程如何影响推理模型行为"的完整图谱。
DSec:DeepSeek 面向大规模 Agent RL 训练的弹性沙盒基础设施(2026)
发表:2026 年 9 月 19 日 | arXiv:2609.22978
核心贡献:DeepSeek(梁文锋署名,131 位作者)首次系统披露其用于大规模 Agent 强化学习训练与评测的生产级沙盒平台 DSec(DeepSeek Elastic Compute)。单个规模单元约 160 个 CPU 节点、3 万核、250 TB 内存,生产环境每日服务约 300 万沙盒,峰值支持同时运行超 38 万沙盒,创建速率超 5000/秒。核心技术包括:①将基础镜像、工作区、工具包拆成独立版本化只读层,运行时动态拼装(维护成本从 O(m·N) 降至 O(m));②通过内存共享回收(峰值内存减少 40.2%)和 QoS 调度(延迟膨胀从 45.2% 降至 17.3%),单节点可承载 3200 个容器;③与 DeepSeek RL 框架协同设计,将 Agent 有状态任务执行与可抢占 GPU 训练解耦。此外还用 AppArmor + eBPF 实现针对 Agent "作弊"行为的沙盒隔离(DNS 白名单+三重网络过滤)。论文前身为 ACM SIGOPS ATC 2026 操作系统方向 extended abstract,已通过首轮评审后大幅扩写。
与本章关系:直接对应本章「Agentic RL 训练基础设施」知识点,DSec 将 Agent RL 训练所需的"可交互、可验证、可隔离"执行环境工程化为生产级平台——既揭示了 GRPO 等算法在真实大规模场景中落地所需的系统层支撑,也展示了 Agent 越来越强时"防止它在训练环境中作弊"成为关键工程挑战;是理解 DeepSeek 从 V3.2 到 V4.1 全系列 Agentic RL 训练底座的权威一手资料。
小模型 RLVR + GRPO:无蒸馏达 3.8 倍增益,奖励形状决定成败(2026)
发表:2026 年 9 月 25 日 | arXiv:2609.28765
核心贡献:来自莱顿大学的研究者在小于 10 亿参数的模型(Qwen3.5-0.8B)上验证了 RLVR + GRPO 路线的有效性:以 Wikipedia 实时检索作为工具、以多跳问答(MuSiQue)为训练任务,无需任何大模型蒸馏即实现平均精确匹配从 0.092 提升至 0.352,七基准套件平均 3.8 倍增益。关键发现:奖励形状比 RLVR 本身更重要——Search-R1 默认的稀疏精确匹配奖励在小模型上表现最差,甚至劣于它直接优化的精确匹配指标本身;小模型 RLVR 需要专属的奖励设计研究,而非照搬大模型方案。三种奖励变体跨三个种子的细粒度实验为奖励工程提供了可复用的对照基准。
与本章关系:直接对应本章「RLVR 算法应用」与「奖励信号设计」知识点,本文将"大模型 GRPO 成功经验能否平移到小模型"这一关键工程问题量化落地——奖励稀疏性是小模型 RLVR 的核心阻塞因素,与已收录的 ActObs(损失掩码影响探索熵)、高效推理奖励(弃答奖励)共同构成奖励设计的多维图谱。
SLCA-GRPO:解决工具调用 RL 中的跨段信用误分配(2026)
发表:2026 年 9 月 24 日 | arXiv:2609.29050
核心贡献:工具调用 Agent 的输出是异构的——结构化工具调用与自然语言摘要交替出现。标准 GRPO 将轨迹级标量 advantage 广播到所有 token,导致摘要生成的梯度噪声"污染"工具决策 token(跨段信用误分配)。SLCA-GRPO 提出段锁定信用分配(SLCA):在单组 rollout 内于结构段层面解耦 advantage 估计,配合层次化奖励(HierR)将执行优势路由到工具 token、偏好优势路由到摘要 token。同时构建 Schema 引导的 LLM 模拟器(SGLS)替代真实 API 进行可扩展探索。在 7B 骨干模型上,SLCA-GRPO 相比标准 GRPO 在 BFCL 上提升 +1.36 pp,在 τ²-Bench 上提升 +9.15 pp,并减少工具冗余调用。
与本章关系:直接对应本章「GRPO 在 Agent 训练中的局限」与「工具调用 RL」知识点,SLCA-GRPO 揭示了一个此前被忽视的结构性问题——在工具调用场景下,GRPO 的"同一 advantage 分配给所有 token"设计会产生信号污染,而分段解耦是解决此问题的直接手段;与已收录的 ConSPO(优化目标层面的 GRPO 改进)共同构成 GRPO 从目标函数到信用分配的双维度改进图谱。
GRPO-MA:树状多答案采样使思维级优势估计方差趋零(2026)
发表:2026 年 7 月(ICML 2026)| arXiv:2509.24494
核心贡献:北京大学 CFCS 与 Agibot 联合队伍从方差分析角度系统论证了树状分支在 GRPO 思维级优势估计中的必要性。标准 GRPO 对每个 thought token 只采样一个最终答案,导致思维级优势估计方差存在严格正下界——无论如何增大 thought 采样数量 K,方差都无法收敛到零。作者用多元 Delta 方法证明:当每个 thought 固定采样 M 个续写时,主项方差以 1/M 速率趋零;而单纯增大 K(思维数量)只降低答案级噪声,不能解决这一结构问题。GRPO-MA(多答案 GRPO)在数学、视觉推理和不同模型规模上,相比标准 GRPO 均表现出更稳定的优化、更高的训练效率和更强的最终性能。
与本章关系:直接对应本章「GRPO 算法原理」与「思维链 RL 训练稳定性」知识点,GRPO-MA 提供了迄今为止最清晰的理论解释——为何"多个答案 per thought"优于"更多 thought 采样";是 GRPO 工程实践中超参调优(G vs M)的理论支柱,与已收录的 ConSPO(目标函数重构)和 SLCA-GRPO(段级信用分配)构成 GRPO 理论—算法—工程三层改进图谱。
贝尔曼策略优化(BPO):无需重要性采样的 RLVR 轨迹级目标(2026)
发表:2026 年 9 月 14 日 | arXiv:2609.15987
核心贡献:阿里 DAMO 院与新加坡国立大学研究者(Song、Xu、Zhang、Bing)提出 Bellman Policy Optimization(BPO),一种从策略镜像下降(PMD)严格推导的无 Critic 方法。标准 GRPO 中重要性采样比率在长答案轨迹上方差爆炸;BPO 通过 Bellman 方程将 PMD 重构为纯轨迹级目标,彻底避免对中间状态估计价值函数,并在理论上证明与原始 PMD 目标具有完全相同的唯一最优解。实践中,BPO 的失配修正权重是互补 token 概率的平滑比值,在数学推理基准 AIME 上达到平均准确率 50.5%。
与本章关系:直接对应本章「RLVR 算法基础」与「超越 GRPO 的理论探索」知识点,BPO 从策略优化理论出发提供了 GRPO 的替代路线——用 Bellman 方程绕过重要性采样引入的高方差问题;与已收录的 GRPO-MA(树状采样降低方差)在目标上一致但路径不同,为本章 RLVR 算法谱系增补了理论驱动的新成员。
V-Rubrics:用逐项准则分级奖励解决多模态 GRPO 的视觉信用误分配(2026)
发表:2026 年 8 月(EMNLP 2026 主会录用)| arXiv:2608.25580
核心贡献:南洋理工大学 S-Lab、A*STAR 与 UIUC 联合提出 V-Rubrics,将 50,248 个视觉问答样本拆解为 352,938 条可独立评分的原子准则(Rubric),分三类:视觉事实(VF)、推理一致性(RC)、指令遵循(IF)。当答案恰好正确但推理过程引用了错误图表数字,或答案错误但早期视觉识别正确时,标量结果奖励无法区分——V-Rubrics 将这些原子准则得分直接注入 GRPO 信用分配,相比同等 SFT 起点和同等 RL 数据的答案级 GRPO,在通用与知识评测的 Overall Avg. 上达到 68.04,在视觉依据型推理基准上增益最大。
与本章关系:直接对应本章「信用分配(Credit Assignment)」与「奖励信号粒度」知识点,V-Rubrics 将"答案对了就全部奖励"的粗粒度标量奖励升级为"逐项检查视觉推理链"——与已收录的 SLCA-GRPO(结构段级信用解耦)在思路上高度互补:前者解决的是"哪个推理步骤做对了",后者解决的是"哪类 token 该得多少梯度",共同构成 GRPO 信用分配的多维优化视角。
iCoder-27B:Agent 主导的前沿工业代码模型递归自建(2026)
发表:2026 年 9 月 25 日 | arXiv:2609.29626
核心贡献:来自上海 AI Lab 与上海交通大学联合团队(Yang、Lyu、Liu、Zhang、Yan 等)提出 iCoder,一个将人工输入压缩为可复用"研究技能(Research Skills)"的递归自建框架。人类仅编写规则:目标、阶段脚手架、权限边界和操作程序,打包为 Skill 文件;Agent 全权负责其余工作——演化训练数据、运行 SFT、在线自蒸馏和带可验证奖励的 RL、读取实验结果并调整计划。最终产出 iCoder-27B,专注 RTL 硬件设计和 GPU 核心优化:在 RTLLM 七项基准上整体领先,在 KernelBench L2 上超越 GPT-5.5 16 分,TritonBench 与 Claude Opus 4.8 并列最优。
与本章关系:直接对应本章「Agentic RL 自进化」与「Agent 主导训练循环」知识点,iCoder 将"Harness 即研究规范、Agent 即实验员"的模式推进到工业规模——人在循环的接口从每小时调参变为高层级可复用 Skill 文件;是本章 RLVR 训练范式在"AI for AI"场景下的最新具体实例,与已收录的 DSec(DeepSeek 300 万沙盒/天 RL 基础设施)共同指向"Agent 自主扩大 RL 训练基础设施"这一前沿趋势。
BATON:贝叶斯反馈归因 + 轨迹质量归一化,同步修复 GRPO 的两类信号病灶(2026)
发表:2026 年 9 月 17 日 | arXiv:2609.19830
核心贡献:浙江大学与上海 AI Lab 联合团队(Zhuang、Yu、Yang、Sun 等)将 LLM Agent RL 训练的优化问题拆解为两个独立维度:轨迹内反馈归因(哪些步骤真正导致了成功/失败?)与轨迹间目标聚合(不同轨迹对 batch 梯度的贡献应当相等吗?)。提出 BATON(Bayesian Attribution and Trajectory Objective Normalization):第一轴用贝叶斯反馈归因,以环境结果为条件为每个采样动作构建后验,将信用精准分配给"关键决策步骤";第二轴用轨迹质量归一化(TMN),让每条完整轨迹获得等权优化话语权,防止"又长又失败"的轨迹(占 25% 却消耗 60.3% 聚合质量)主导梯度方向。两者即插即用于 GRPO/GiGPO。在 ALFWorld 上,GRPO 成功率从 72.9% 提升至 85.6%,GiGPO 从 86.8% 提升至 94.1%;WebShop 和 SearchQA 同向增益;消融证实双轴独立有效。
与本章关系:直接对应本章「信用分配(Credit Assignment)」与「GRPO 在 Agent 训练中的局限」知识点,BATON 从两个正交的维度(步骤级归因 + 轨迹级归一化)系统诊断了 GRPO 的梯度信号失真问题——25% 轨迹占 60% 聚合质量的测量结果,是工程实践中判断"何时应该加 TMN"最直接的诊断指标;与已收录的 GRPO-MA(树状多答案采样降低方差)和 V-Rubrics(细粒度奖励分配)共同构成 GRPO 信用分配的多维优化图谱。